项目中的技术选型,你怎么向面试官解释?
面试怎么回答
我不会先讲某个技术有多先进,而会按“约束、候选、取舍、验证”四步说明。先交代业务目标、数据规模、时效与一致性要求,以及团队和成本边界;再用同一组维度比较候选方案,区分必须满足的门槛和可以权衡的指标;然后说明最终方案解决了什么核心问题,同时接受了哪些复杂度和风险;最后用 PoC、真实数据压测、双跑校验、灰度和回滚方案验证关键假设。我还会准确说明自己在需求分析、测试或落地中的职责。这样面试官听到的是一套可复用的决策过程,而不只是技术名词。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人的回答是:
“我们用了 Flink,因为它实时性能好;用了 Kafka,因为吞吐高;用了 ClickHouse,因为查询快。”
这些话不能算错,但很难证明这是一场真正的技术选型。
因为任何技术都有优点。面试官更想知道的是:
在什么业务约束下,你比较过哪些方案,为什么接受了这个方案的代价?
我理解的技术选型,不是介绍产品功能,而是解释一个受约束的决策过程。
第一步:先讲需求和约束,不要先报技术名
同一个“实时数仓”需求,在不同公司可能完全不是一回事。
选型前至少要讲清四类约束。
业务目标
这套系统要解决什么问题?是实时看板、广告归因、风险识别,还是离线报表?
目标不同,对延迟、准确性和可追溯性的要求完全不同。
数据特征
数据规模、增长速度、写入模式、查询类型、更新比例和冷热分布是什么?
离开数据特征谈“高性能”,基本没有判断依据。
交付指标
要明确时效、可用性、一致性、查询并发、恢复时间和数据保留周期等关键指标。
团队与成本
团队是否熟悉这套技术?有没有运维能力?预算、云资源、迁移窗口和存量系统允许多大的复杂度?
技术上能做,不等于团队长期接得住。
第二步:比较方案时必须使用同一把尺子
不要把 A 方案的性能优势,和 B 方案的生态优势放在一起做散点式描述。
我通常会用同一组维度比较候选方案:
- 是否满足核心业务指标
- 数据模型和查询模式是否匹配
- 稳定性与故障恢复能力
- 建设、迁移和长期运维成本
- 团队学习成本与人才可获得性
- 与现有系统的集成复杂度
- 未来扩展与退出成本
最重要的是先区分“必须满足”和“可以权衡”。
例如端到端延迟必须控制在分钟级,这是门槛;查询性能再快一些,也许只是加分项。只要门槛不满足,其他优点再多也不能成为首选。
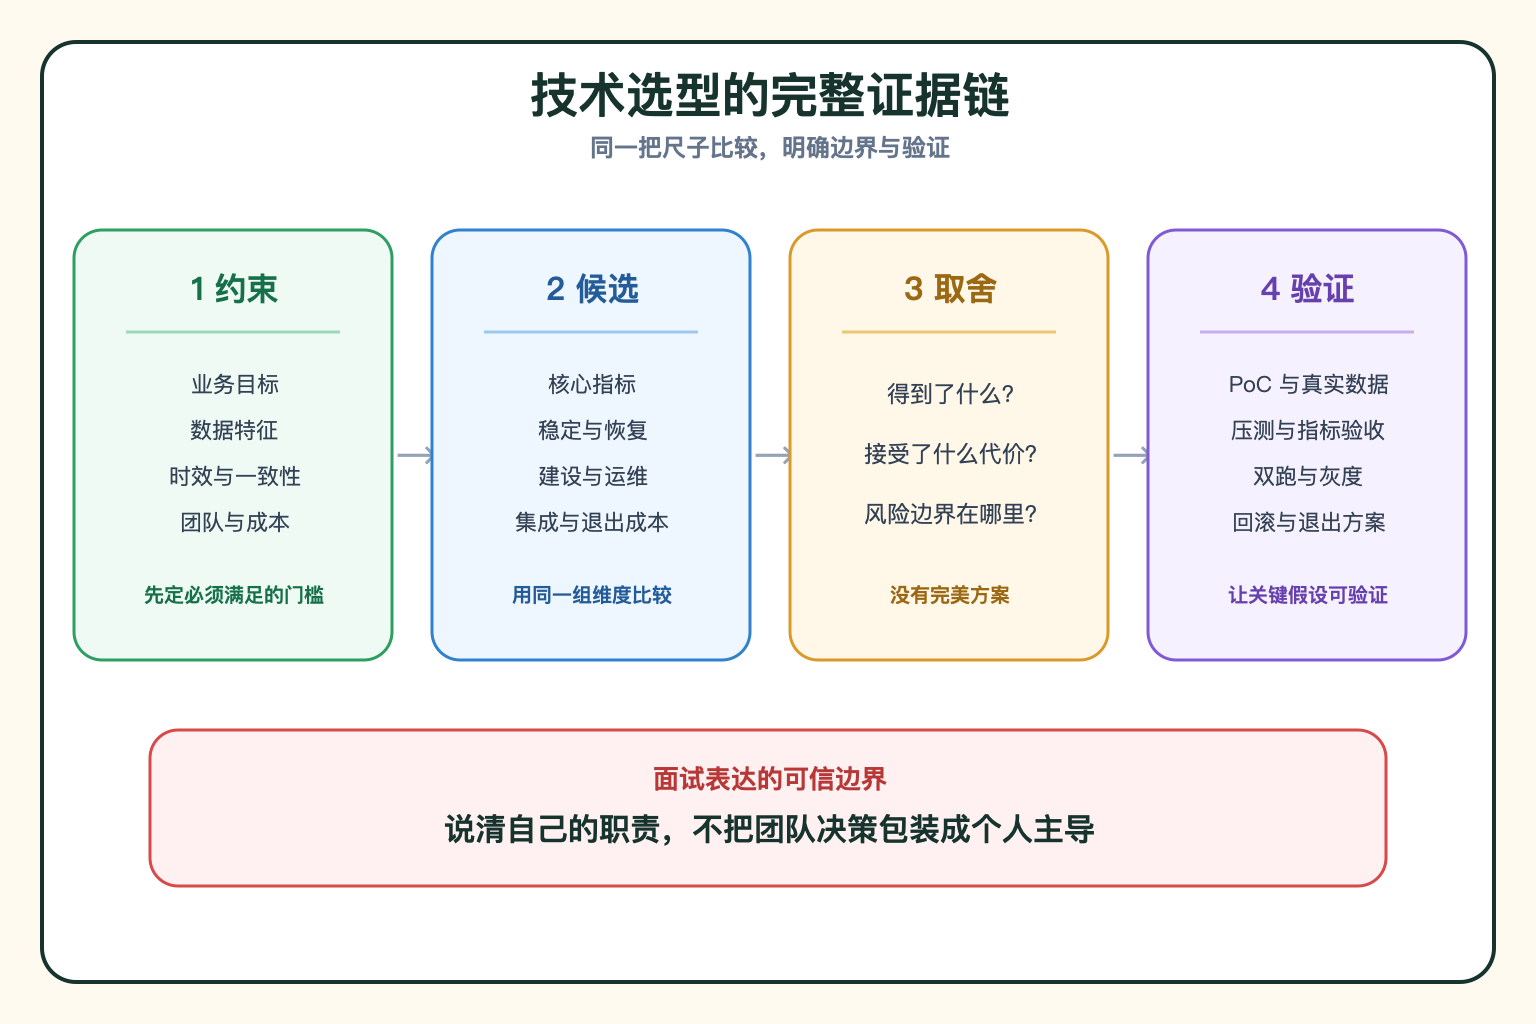
第三步:把取舍和风险主动说出来
好的选型回答里一定有“没有选什么”。
因为技术决策不是寻找完美方案,而是在约束下选择总成本更可控的方案。
如果选择 Flink,就要说明你接受了状态管理、Checkpoint 和运维复杂度;如果选择批处理,就要说明业务为什么能够接受更高延迟;如果选择托管服务,也要说明费用、平台绑定和可控性的取舍。
同时还要讲风险控制:
- 先做 PoC 验证哪几个关键假设
- 用什么真实数据和指标验收
- 如何灰度、双写或回滚
- 哪些风险留到后续阶段处理
选型结论有边界,验证方案才让结论可信。
一个典型场景
比如面试官问:为什么实时链路选择 Kafka + Flink + OLAP,而不是继续使用纯离线方案?
浅层回答会说“Flink 延迟低,OLAP 查询快”。
更完整的回答应该先说明:业务需要分钟级观察核心指标,现有离线链路只能按小时交付;数据以持续追加为主,查询集中在固定维度聚合;团队已有 Kafka 运维基础,同时可以接受维护 Flink 状态任务的成本。
然后再讲候选方案:继续提高离线调度频率的改造小,但高频小批次会增加调度和文件压力;引入流处理复杂度更高,但能稳定满足时效门槛。
最后说明验证和边界:先选择一条核心链路做 PoC,对比延迟、资源成本、数据一致性和故障恢复;通过双跑校验再逐步切流,同时保留离线链路承担回溯和兜底。
这才是在解释“为什么选”,而不是背一遍技术栈。
第四步:把你的作用讲清楚
面试官还会关注:这项决策到底是不是你参与的。
不需要把团队成果全部说成个人决策,但要准确说明自己负责了什么:
- 参与需求和约束梳理
- 完成候选方案调研或 PoC
- 负责某项指标测试
- 推动评审、灰度或数据校验
- 在实施中发现并修正某个风险
如果最终方案不是你决定的,也可以讲清你提供了什么判断依据、提出了什么风险,以及结果如何验证。
可信的边界,比夸大“这是我主导的”更有说服力。