指标平台和语义层怎么设计?
面试怎么回答
我会从实体与粒度开始建语义模型,再定义可复用维度和基础度量,指标在其上声明业务过滤、时间语义、单位、负责人和版本。平台要控制 Join 路径、可加性、权限和发布影响,并让明细查询、预聚合与缓存都使用同一份指标定义。语义层的价值不是集中存 SQL,而是让不同工具在同一业务契约下得到可追溯的一致结果。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
运营说 GMV 看报表 A,财务说必须看报表 B,数据开发发现两边 SQL 都“写得没错”。
问题往往不在计算语法,而在指标定义、维度、时间语义和版本没有形成统一契约。
语义层要把实体、维度、度量、指标、时间和权限从具体报表 SQL 中抽出来,形成可复用、可治理、可追溯的业务语义。
第一层:先定义业务实体和粒度
订单、用户、商品、广告活动都是业务实体。每个语义模型必须声明主实体、事实粒度和唯一键,例如“一行代表一个订单明细”还是“一行代表一个订单”。
粒度不清,GMV、订单数和用户数在 Join 后都可能重复。语义层不能替代建模,反而要求底层事实粒度更明确。
第二层:区分度量和指标
度量是可聚合的基础计算,例如 SUM(pay_amount)、COUNT(DISTINCT order_id);指标则在度量之上增加业务条件、时间范围、目标和展示语义,例如“有效支付 GMV”或“近 7 日付费用户数”。
指标定义应包含名称、口径、过滤、聚合方式、默认时间字段、单位、负责人和版本,而不是只有一段 SQL。
第三层:统一维度和时间语义
同一个指标需要按地区、渠道、商品等维度切分。维度必须有稳定标识、层级和 Join 关系,避免每个报表自己决定关联路径。
时间要明确事件时间、记账时间、自然日、滚动窗口、时区和累计方式。“本月 GMV”在跨时区业务中不是一句话就能定义。
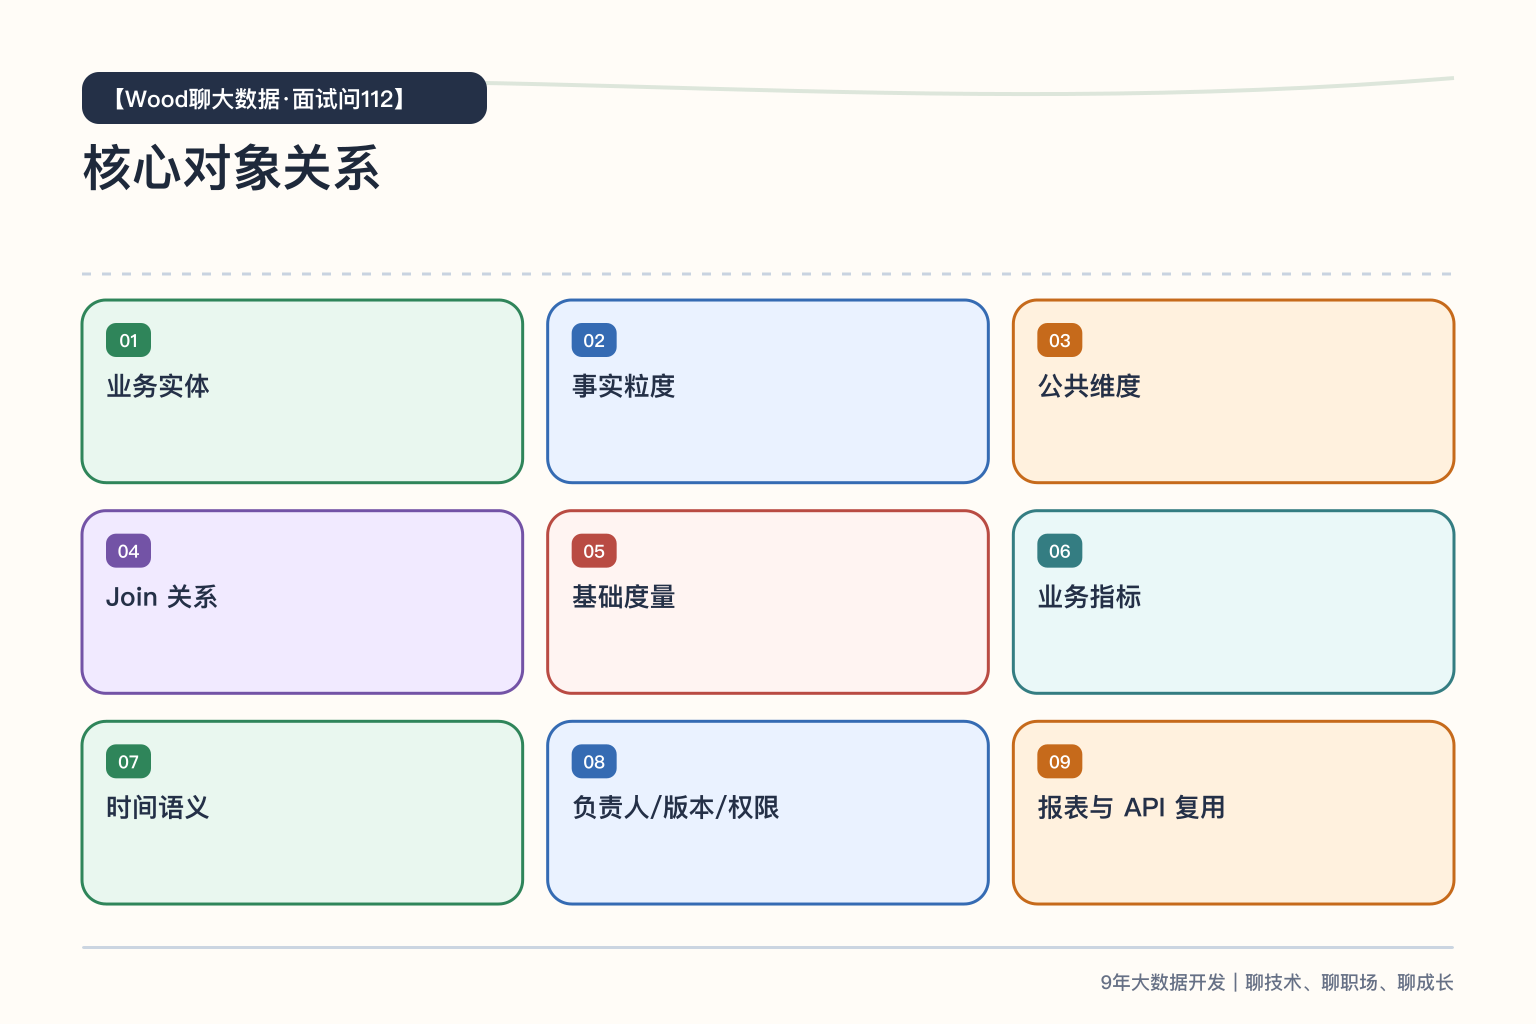
第四层:把治理能力放进执行链路
指标发布需要评审、版本、影响分析、权限和废弃流程。查询时记录实际使用的指标版本、维度和底层数据,才能解释历史结果。
语义层还要做可加性校验。例如库存余额不能跨日期直接求和,去重用户数也不能简单把每日 UV 相加。不是所有度量都能任意切维度和时间。
缓存和预计算怎么做?
语义层负责“算什么”,执行层决定“怎么快”。高频指标可以建设 Aggregate Table、物化视图或缓存,但缓存 Key 必须包含指标版本、维度、过滤和时间范围。
预计算不能成为第二套口径。无论走明细还是聚合路径,结果都要通过同一语义定义生成并对账。
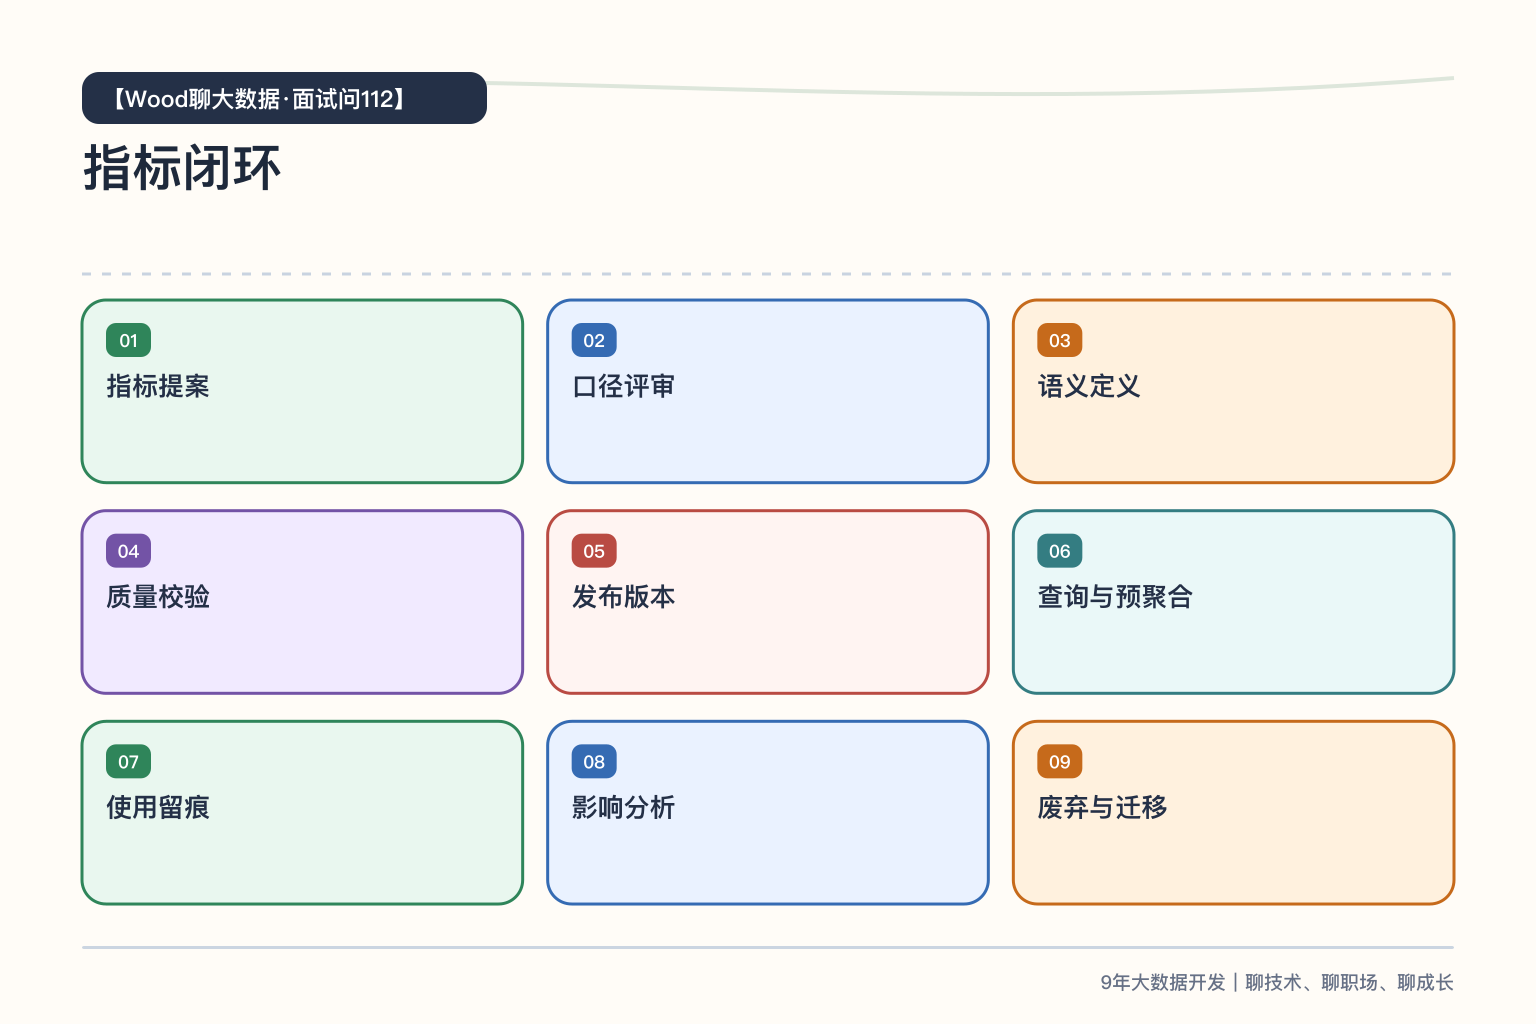
一个典型反例
平台只建立了指标名称和 SQL 模板,没有声明事实粒度与默认时间。用户增加“商品类目”维度后,订单金额因一对多关系被放大。
修复不能只给当前 SQL 加 DISTINCT,而要定义实体关系、允许的 Join 路径和可加性,并在编译或运行前阻止危险查询。