Lambda 架构和 Kappa 架构怎么选?
面试怎么回答
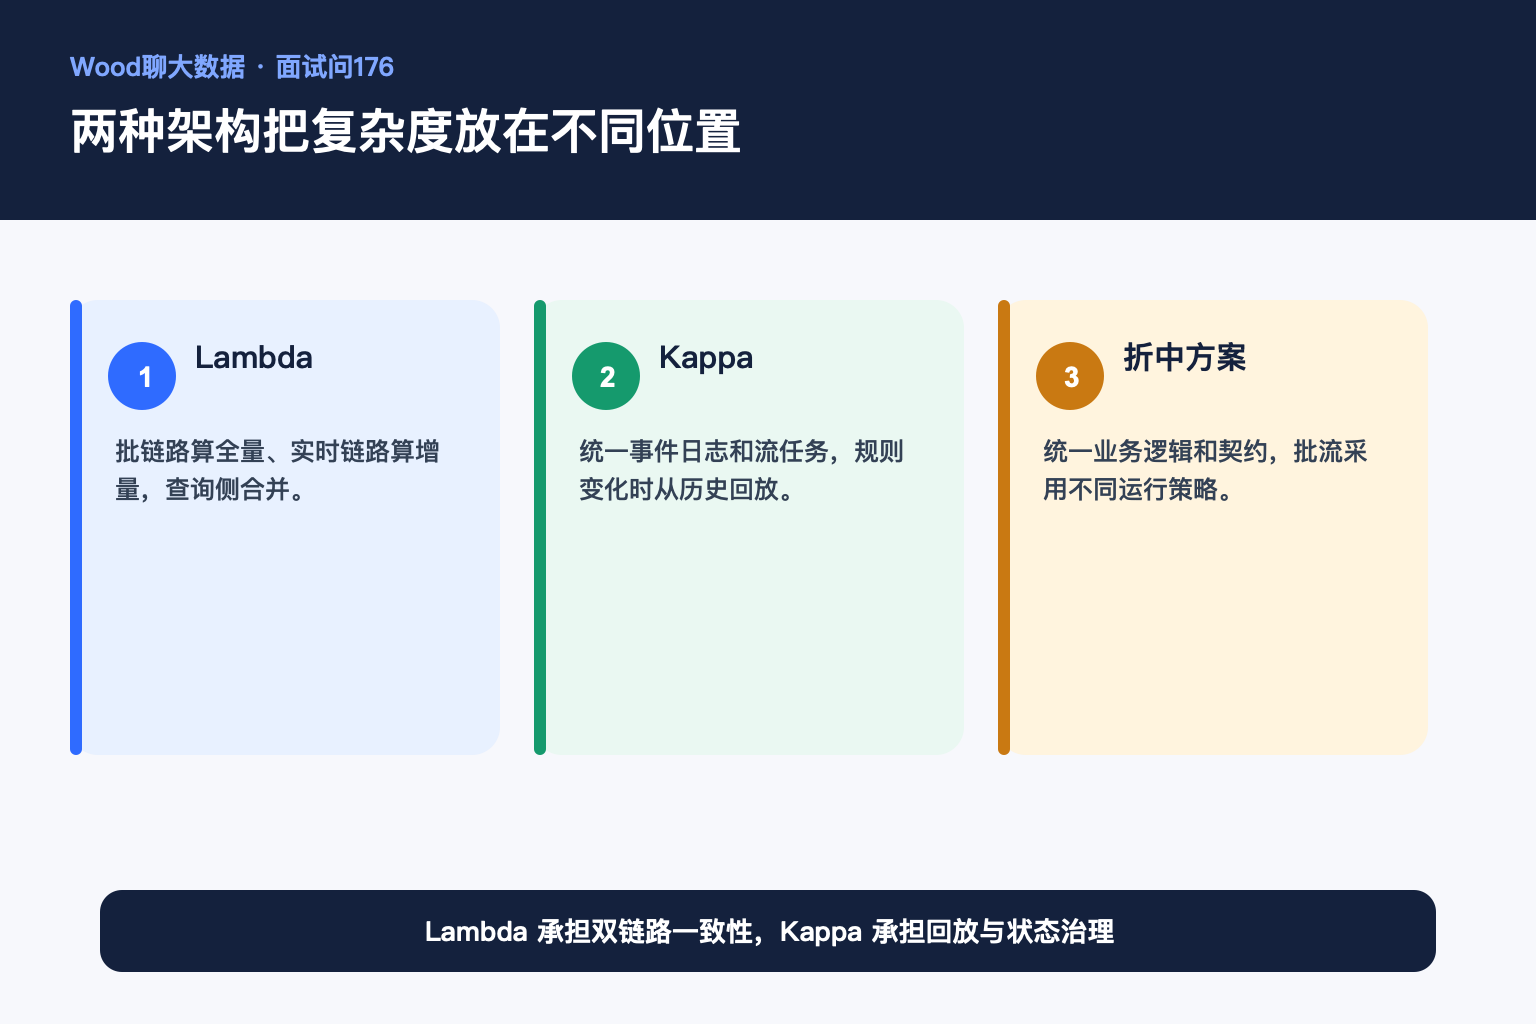
Lambda 用批处理和实时处理两条链路分别保证历史准确性与低延迟,优点是重算路径清晰,缺点是逻辑重复和结果合并复杂。Kappa 以可重放事件日志和统一流式任务为核心,减少两套代码,但对日志保留、回放、状态和幂等要求更高。我会根据历史更正频率、数据事件化程度、时效 SLA 和团队能力选择,也可以采用统一逻辑、不同运行路径的折中方案。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一套逻辑写两遍,离线结果和实时结果总有一天会对不上。
可把所有计算都改成流式之后,历史回放和状态升级又变成新的难题。
Lambda 用批流两条链路换取结果与实时性,Kappa 用统一流式链路降低重复逻辑,但回放和状态治理更关键。
Lambda 为什么有两条计算链路
Lambda 架构通常保留不可变原始数据,批处理链路周期性计算准确全量视图,实时链路计算最近增量,查询时合并两者。它能兼顾历史重算和低延迟,但同一业务口径需要在批流两套代码中实现,长期容易漂移。
Kappa 把事件日志当作统一入口
Kappa 架构以可重放的事件日志为事实来源,主要使用流处理维护结果。规则修复或逻辑升级时,从历史 Offset 重新回放到新结果表。代码路径更统一,但日志保留、回放吞吐、状态迁移和外部副作用必须设计好。
选择不能只看实时延迟
如果业务经常大范围更正历史、源数据并非完整事件流,批处理仍然更自然。如果数据天然事件化、实时逻辑占主导且可以可靠回放,Kappa 能减少重复实现。还要考虑团队排障能力、状态大小、成本和下游是否接受最终一致。
流批统一是计算模型,不是口号
Apache Beam 等模型可以用统一 API 描述有界与无界数据,Flink、Spark 也在加强批流统一能力。但统一编程模型并不会自动解决源端补数、结果幂等、维表历史、外部系统写入和 SLA 差异,数据链路仍可能需要不同运行策略。
一个典型场景
交易指标既要分钟级看板,又经常因退款和结算规则调整回刷半年历史。完全双链路会产生口径漂移,完全流式回放又可能占用大量资源。更现实的方案是统一指标逻辑和表契约,实时链路负责低延迟增量,受控批任务负责大范围校正。
参考资料
- Apache Beam Unified Model:https://beam.apache.org/documentation/basics/