大数据任务的资源怎么估算?只看每天多少GB够吗?
面试怎么回答
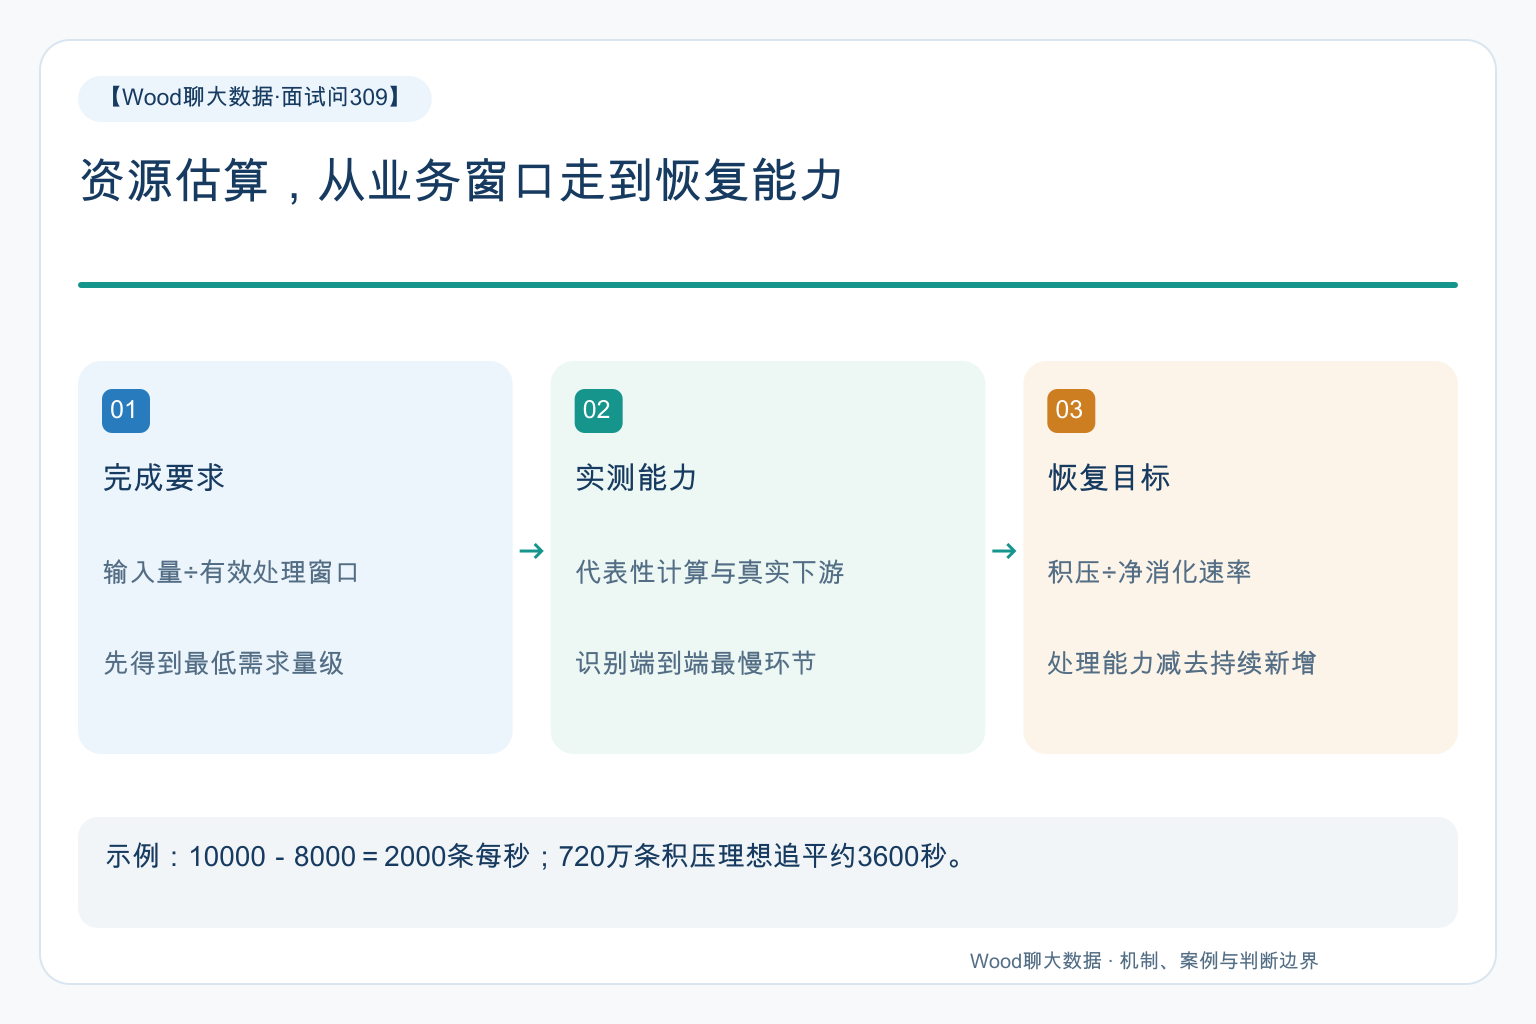
我会先确定可用处理窗口和峰值输入,而不是把日数据量简单除以24小时。再拆解扫描、Shuffle、状态、输出和外部调用,使用代表性任务测单位资源能力,估算并行需求。还要计算积压在持续新增下多久能追平,并为失败恢复、重算和共享下游留余量。估算给出范围和假设,最终通过压测与运行观测修正,不把线性扩容当成保证。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
每天只有1TB数据,平均摊到24小时似乎不算多。但上游凌晨两点才交齐,报表四点就要完成,真正的处理窗口只有两小时。用日均吞吐选资源,可能从第一天就低估了需求。
容量估算先按有效时间窗和峰值计算需求,再用实测单位能力校准,并给重算、故障与下游瓶颈留余量。
有效窗口比日均量更重要
离线任务可用时间,应从业务截止时间扣除上游等待、前置依赖、必要验收和发布耗时。不能把整晚都当成计算窗口。
例如示意数据量为1TB,按十进制单位约一百万MB,两小时处理完,仅输入平均吞吐就约为139MB每秒。这个数还没有计算重复扫描、Shuffle和写出。
实时任务则需要看峰值及持续时长。短暂突发可以靠缓冲吸收,持续峰值超过处理能力就会不断积压,不能用全天平均掩盖。
字节、记录数和计算复杂度都要看
同样100GB,少量宽记录与大量窄记录的调度、序列化和对象开销可能不同;复杂正则、JSON解析或外部查询,也会改变单位记录成本。
Join与聚合还可能产生远大于输入量的中间数据。应依据计划和实测观察Shuffle、Spill、状态规模与输出放大,而不是把输入存储大小当成全部I/O。
压缩前后字节也不同。对象存储里1TB压缩文件,解码后的内存和网络中间表示未必还是1TB,容量表应注明计量口径。
单位能力最好来自代表性实测
选择与生产相近的数据分布、字段宽度、计算逻辑和下游,测量稳定处理速率及资源利用,再估算需要多少并发处理单元。
只用均匀随机数据,可能看不到真实热点;只测内存中的简单COUNT,也无法代表带Shuffle和外部写入的任务。
资源翻倍未必吞吐翻倍。串行阶段、热点键、任务启动、网络和目标库都可能成为瓶颈,因此估算应给出范围和验证计划,而不是一个看似精确的实例数。
一个典型场景:CPU空闲,积压却追不平
比如团队按输入日均量配置计算资源,发现高峰后积压长时间不下降,于是继续增加Executor。
观察发现计算侧并不繁忙,目标数据库写入已经达到限制。最初认为并行度还不够,根因却是端到端能力被下游封顶。
旧压测使用本地空输出,只测转换速度,没有包含真实写入。修复应测完整链路,控制写入并发,并根据目标库容量设计批量、缓冲或错峰方案。
这不是说下游永远要扩容,而是容量估算必须把它纳入约束,不然计算资源再多也只是更快地产生等待。
追平积压,要用净处理能力
假设持续新增每秒8000条,当前能够处理每秒10000条,净消化积压只有每秒2000条。
如果已有720万条积压,理想稳定条件下需要3600秒追平,而不是按10000条每秒算成720秒。这个公式假设速率稳定、没有其他瓶颈,真实恢复还要考虑重启与热身。
如果处理能力不高于持续新增,积压不会自行消失。此时扩大队列只延缓失败,无法满足追平目标。
余量必须对应具体风险
为节点失效、Checkpoint恢复、历史回补和业务活动预留空间,最好说明每份余量服务哪个场景,而不是笼统把所有参数乘二。
存储还要考虑保留期、副本、版本快照和临时文件;只计算一份逻辑数据,可能低估实际占用。但不同存储机制不能机械叠加所有系数。
上线后持续对照估算与实际,记录数据增长、单位成本变化和瓶颈迁移。容量规划是可修正的工程模型,不是一张算完就永久有效的表。
面试里能清楚写出窗口、负载、单位能力和恢复目标,比只报一个“通常给几个核”更能体现判断能力。