数据质量检查怎么设计?
面试怎么回答
我一般会这样回答:
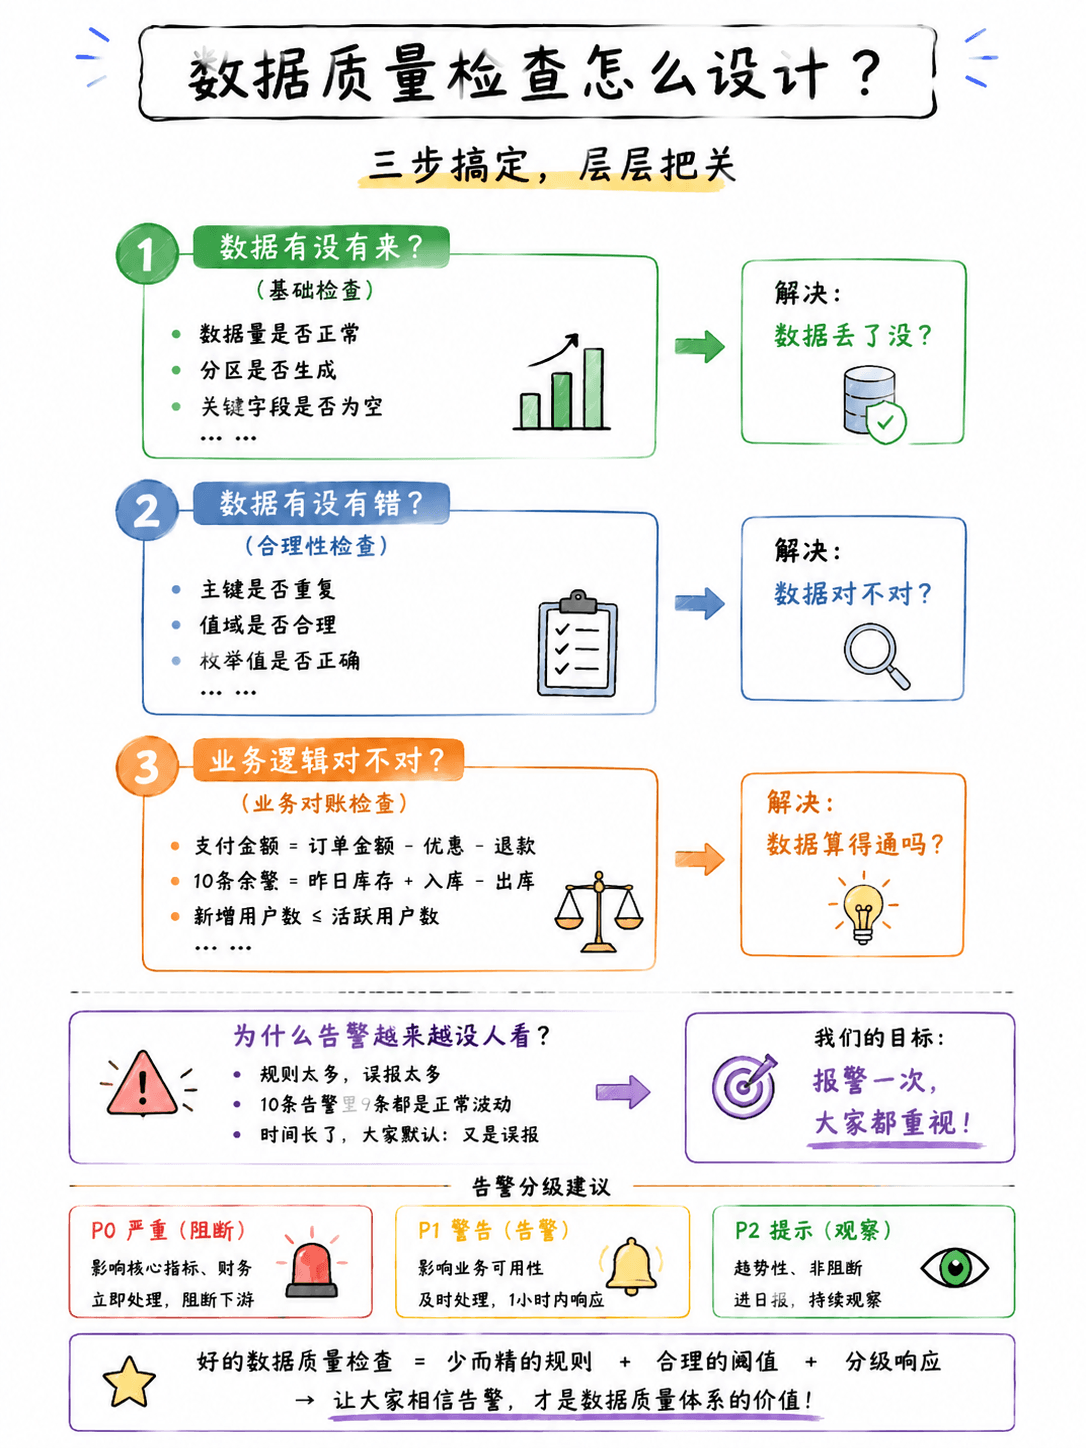
第一步检查数据有没有来;
第二步检查数据有没有错;
第三步检查业务逻辑是否成立;
最后根据影响范围做告警分级。
其中最有价值的不是空值率和唯一性,而是业务勾稽和对账规则。
因为真实生产环境里的很多问题,只有业务规则才能发现。
这样的回答,既有体系,也有实际经验。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人一上来就开始讲:
- 空值检查
- 唯一性检查
- 数据量检查
其实这些都没错。
但如果只回答这些,基本停留在初级阶段。
因为真实生产环境里,最大的难题从来不是不会写规则,而是:
规则写了很多,告警也很多,但真正出问题的时候却发现不了。
我接手过一个数据质量平台,里面配了200多条规则。
每天几千条告警。
结果值班同学告诉我:
「这些告警平时根本不看。」
因为大部分都是误报。
这也是很多公司数据质量建设的现状:
告警越来越多,大家越来越不相信告警。
数据质量检查,到底检查什么?
如果让我总结,我会分成三类。
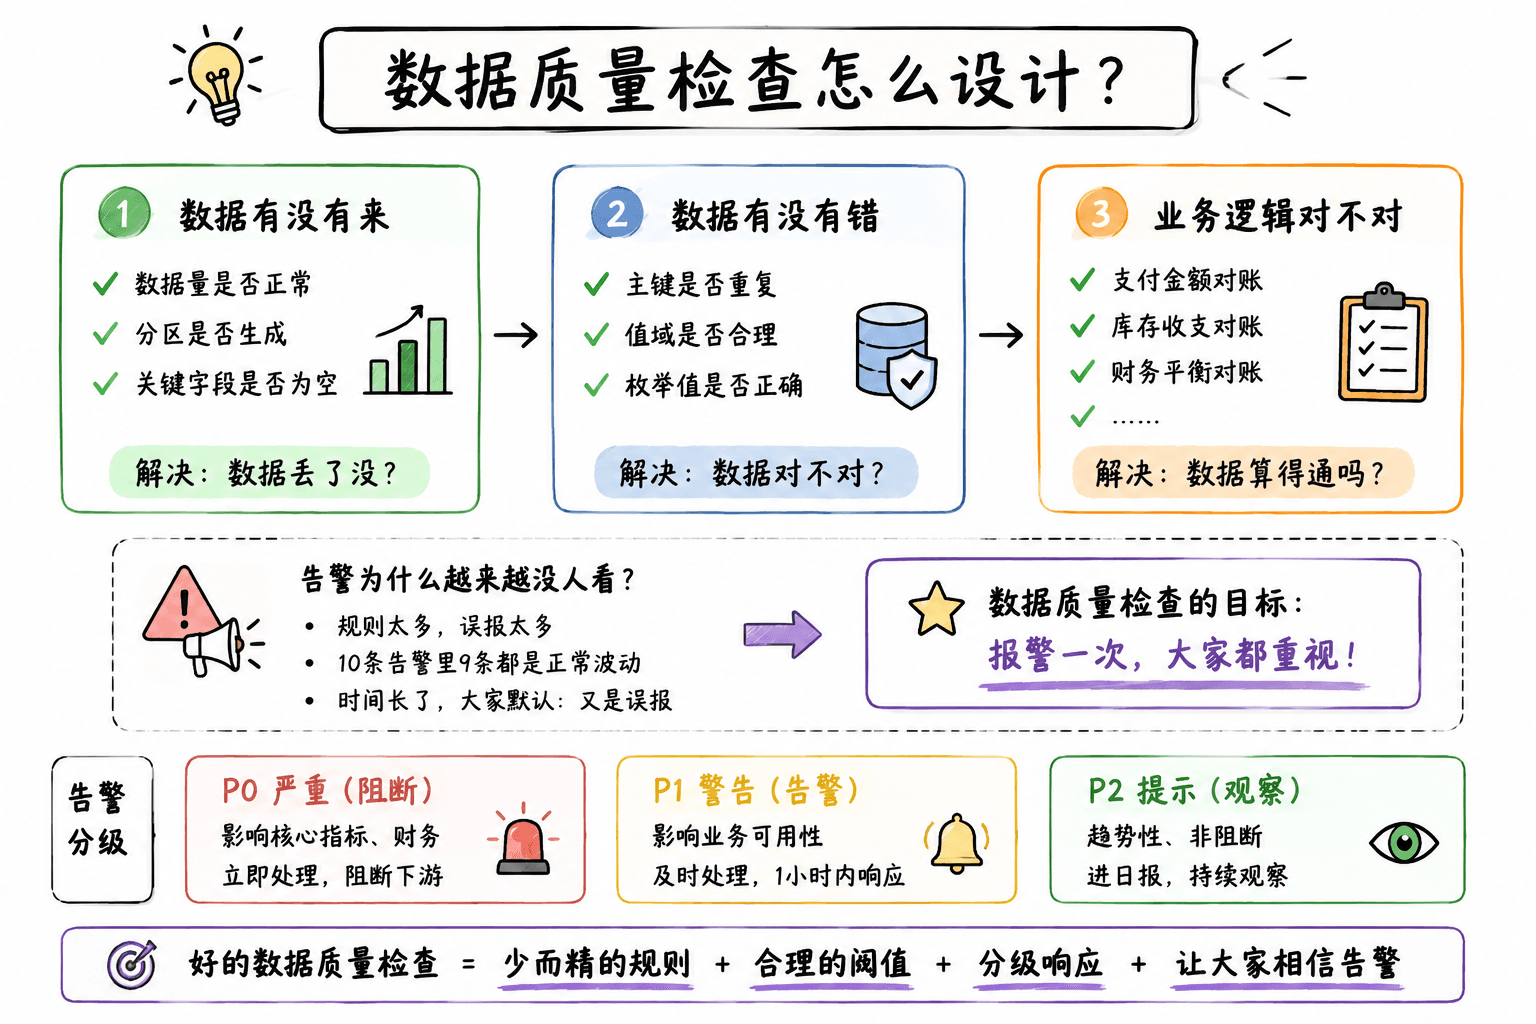
第一类:数据有没有来
这是最基础的。
比如:
- 数据量是否正常
- 分区是否生成
- 关键字段是否为空
举个例子:
昨天100万条数据,
今天只有10条数据。
那肯定有问题。
这类规则主要解决:
数据丢了没?
第二类:数据有没有错
数据来了,不代表数据正确。
比如:
- user_id是否重复
- 金额是否小于0
- 状态值是否超出范围
这些属于数据合理性检查。
主要解决:
数据格式对不对?
第三类:业务逻辑对不对
这是最容易被忽略的一类。
也是最有价值的一类。
例如:
支付金额 = 订单金额 - 优惠金额 - 退款金额
库存余额 = 昨日库存 + 入库 - 出库
新增用户数 ≤ 活跃用户数
这种规则往往能发现真正的业务问题。
因为很多事故其实是:
- 数据量正常
- 字段正常
- 主键正常
但业务逻辑已经错了。
一个真实踩过的坑
有一次业务同学反馈:
GMV比昨天高很多。
我们第一反应是活动效果好。
结果排查发现:
优惠金额没有扣减成功。
导致GMV虚高。
而当时的数据质量规则全部通过。
因为:
- 数据量正常
- 空值率正常
- 主键没有重复
最后还是业务对账发现的问题。
从那以后我发现:
数据量检查能发现脏数据。
业务逻辑才能发现错数据。
空值率、唯一性这些规则,
更多是在检查“数据格式”。
而真正高级的数据质量检查,
是检查“业务逻辑是否成立”。
告警为什么越来越没人看?
很多团队有个共同问题:
规则越来越多。
告警越来越多。
最后没人看。
因为大家发现:
10条告警里面有9条都是正常波动。
例如:
周末订单量下降。
节假日流量上涨。
这些本来就是正常现象。
如果每天都报,
时间长了大家就会默认:
又是误报。
真正事故来了反而容易被忽略。
我理解的数据质量检查
工作这些年下来,我越来越觉得:
数据质量检查不是为了制造告警。
而是为了让大家相信告警。
真正好的规则不一定很多。
但当它报警的时候,
所有人都知道:
这次可能真的出事了。
这才是数据质量体系存在的价值。