调度依赖怎么设计?上游成功为什么下游仍然缺数据?
面试怎么回答
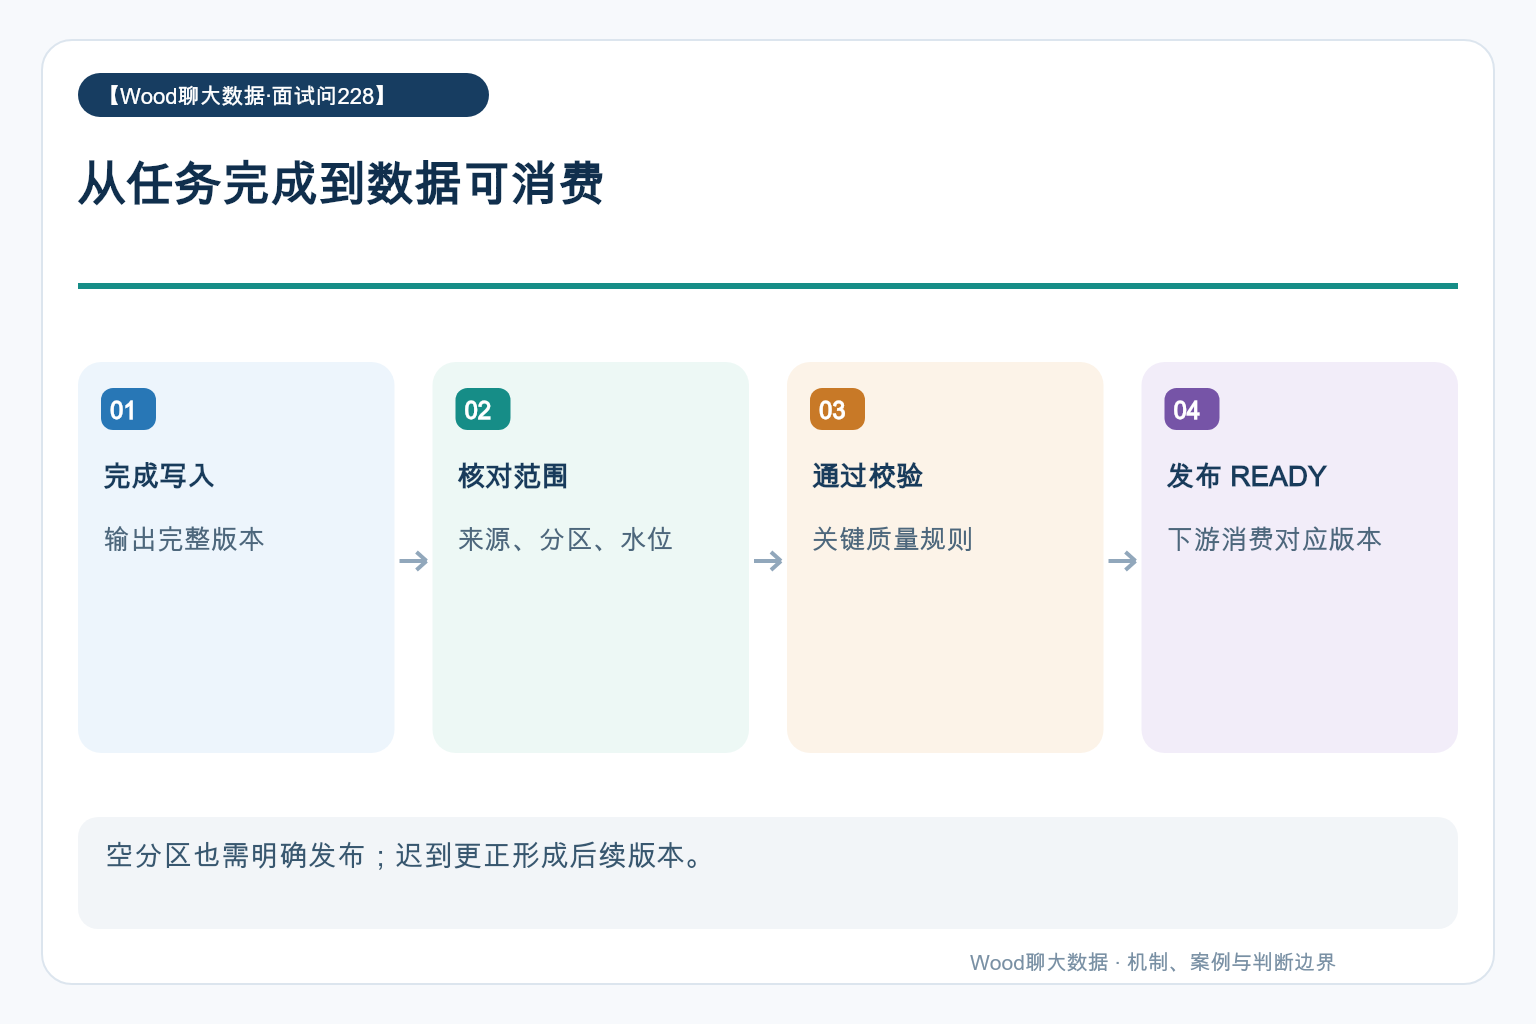
我会按数据产物设计依赖:先定义业务区间、预期来源和输入水位,再在完整写入与质量检查通过后发布 READY。下游消费指定分区版本,不能只看最近一次任务成功。迟到和回刷通过新版本传播,空分区显式标记,并监控缺失来源、等待时间和下游影响,这样依赖才真正对应数据可用性。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
凌晨的任务全部显示成功,早上的日报却少了一个渠道。下游确实等上游成功后才开始,为什么依赖线也没有挡住缺数?这道题考的是如何定义“数据可以被消费”。
把任务成功与数据就绪分开,按业务分区、批次水位和质量门禁发布可消费状态;依赖关系还要覆盖迟到、更正和重跑传播。
任务成功只证明代码完成了自己的条件
一个采集任务成功,可能只是接口调用没有报错;一个同步任务成功,可能只复制了当时能够看到的文件。如果代码没有检查来源是否到齐,调度器不会自动知道还缺一个渠道。
因此先为数据产物定义契约:覆盖哪个业务日期或小时、包含哪些来源、截止水位是什么、允许多晚到达、满足哪些质量规则。没有产物定义,依赖线越多也只是把不明确的状态串起来。
把就绪信息落成可验证的记录
可以维护一份分区或批次状态表,包含数据集、业务区间、输入水位、输出版本、校验结果和发布时间。只有写入完整、检查通过后,才将这一版本发布为 READY。
下游等待的是自己需要的日期和版本,而不是“最近有一次成功”。例如九月二日运行的日任务可能处理九月一日数据,不能拿运行日期直接关联上游业务日期;小时汇总成日结果,还需要确认预期小时集合全部覆盖。
就绪发布必须晚于完整产物可见
先写文件再发事件、或者先提交表再更新就绪状态,要考虑中途失败能否恢复。就绪消息提前发出,下游可能只读到一半;产物已完成但消息丢失,则会造成无谓等待。
实践中应采用引擎支持的原子发布机制,或用幂等状态机和定期核对修复两者差异。资产事件调度有助于描述数据依赖,但事件本身仍需携带业务区间,并由生产任务承担质量与完整性的判断。
一个典型场景:固定等十分钟仍然缺数
比如团队为慢渠道给下游统一增加十分钟延迟,平时正常,某天渠道晚到半小时再次缺数。初步判断是调度不准,实际是等待时间与数据到齐没有直接关系。
原监控只看任务运行耗时,没有监控预期来源集合和源数据水位。改造后按渠道、业务日登记状态,全部达到要求再发布;超时则明确报出缺失渠道和影响指标。固定延时可以作为缓冲,但不应替代可观察的就绪条件。
迟到与重跑要有后续版本
每天只能变成 READY 一次的模型难以处理迟到更正。可以为同一业务区间记录多个输出版本,下游保存自己消费的上游版本;收到新版本后,按血缘确定需要重算的范围。
还要防止所有历史回刷都触发整条链路,造成重跑风暴。将更正范围、优先级和批次合并策略明确下来,并给没有新数据的正常空分区提供显式就绪标记。空数据和未产出必须能被区分。
跨天回刷时还应确认下游等待的日期没有被当前调度时间覆盖,并保留每次消费过的版本,便于解释为什么同一天曾经发布过不同结果。