离线任务出现重复数据,你怎么排查?
面试怎么回答
我会先定义目标表粒度和预期唯一键,确认哪些记录在业务上才算重复。然后从目标分区取重复 key 样本,沿 SQL 向上游逐段比较总行数、主键数和重复倍数,定位第一次发生放大的步骤。根因通常分四类:源头本身重复或多版本、Join 侧不唯一造成一对多放大、任务重跑使用追加写导致重复落地,以及目标表粒度设计错误。修复时优先解决产生重复的上游契约,而不是只在结果层 DISTINCT。最后补上主键监控、Join 基数校验和幂等写入,并评估受影响分区和下游重算范围。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人第一反应是:
“最后加一个 DISTINCT,或者按主键做 ROW_NUMBER() 去重。”
这能让结果暂时不重复,却不一定解决问题。
因为离线任务出现重复数据,至少可能来自四个环节:
源头重复、Join 放大、任务重跑重复写入、目标表粒度设计错误。
如果没有先确认重复发生在哪一步,去重可能会掩盖数据链路里的真正缺陷,甚至把本来不同的业务事件误删掉。
第一步:先定义“重复”到底是什么意思
排查前必须先说清目标表粒度。
一行数据代表的是一个订单、一笔支付、一次广告点击,还是“用户 + 日期 + 商品”的汇总?
然后确定三件事:
- 业务主键是什么
- 时间口径和分区范围是什么
- 哪些字段不同仍然算同一条业务记录
如果连预期唯一键都没有定义,COUNT(*) 和 COUNT(DISTINCT ...) 的差值没有业务意义。
有时所谓重复,其实是一个订单有多次支付尝试;有时两行看起来不同,却是同一事件被重复同步。
先定粒度,再谈唯一。
第二步:从目标表向上游逐段定位放大点
我通常会先在目标分区按预期主键分组,找到重复 key 和重复倍数,再带着样本向上游回查。
重点比较每个关键步骤的:
- 总行数
- 业务主键数
- 重复 key 数
- 单 key 最大重复倍数
哪一步开始出现“行数增加但业务主键数不变”,哪一步就是重点怀疑对象。
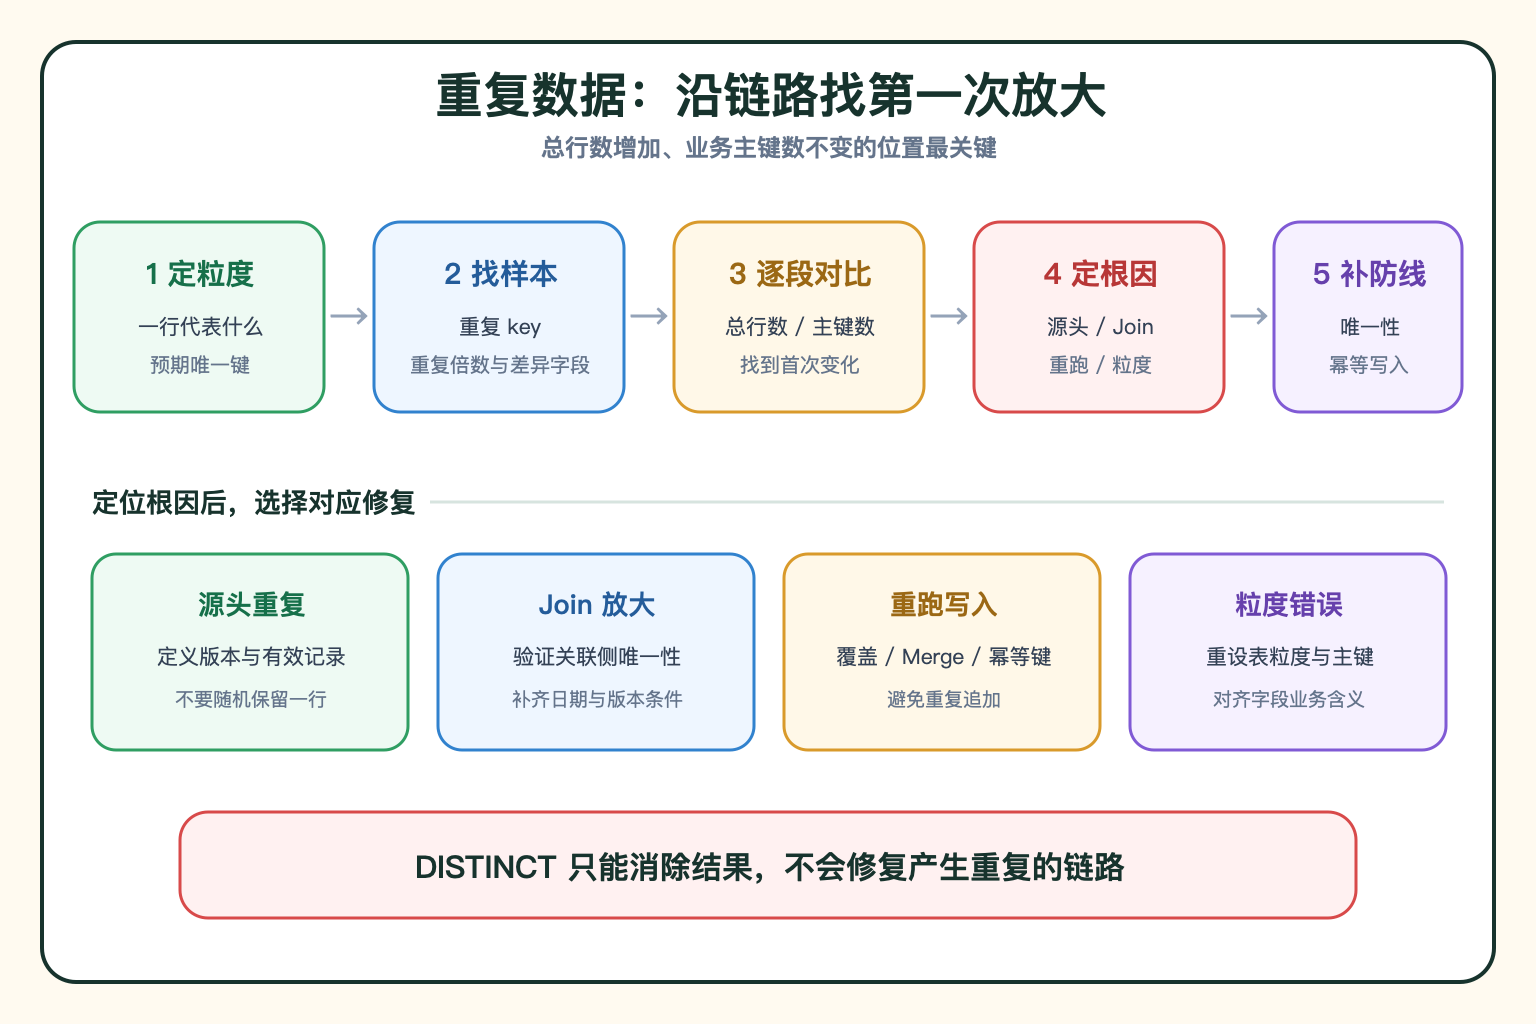
第三步:按四类根因检查
第一类:源头重复
检查上游同一业务主键是否已经有多条记录,是重复采集、CDC 重放、状态更新记录,还是业务本身允许多版本。
如果是多版本数据,需要按明确的更新时间、版本号或状态规则取有效记录,不能随意保留一条。
第二类:Join 放大
这是最常见也最容易被忽略的一类。
事实表 Join 维表前,要验证关联键在被 Join 一侧是否唯一。只要维表同一个 key 有两行,事实表一行就可能变成两行。
还要检查空字符串、默认值和缺失 key 是否被集中关联,以及 Join 条件是否漏了日期、版本或业务范围。
第三类:重跑与写入重复
检查调度是否重复触发、失败重试是否再次追加、补数据和日常任务是否覆盖了同一分区。
如果任务使用追加写,却没有幂等键、覆盖分区或写前清理机制,同一批数据重跑就会重复落地。
第四类:目标粒度错误
目标表设计成订单粒度,SQL 却混入商品明细;或者汇总表应该按天聚合,却把小时字段保留下来。
这类问题不能靠去重修复,而要重新对齐表粒度、字段含义和主键约束。
一个典型场景
比如某个订单宽表同一 order_id 出现两行。
最初判断是订单源表重复,于是在最终 SQL 外层增加 ROW_NUMBER(),只保留更新时间最新的一行。
但向上游逐段统计后发现,订单明细在 Join 用户标签维表之前仍然唯一,Join 之后才翻倍。
继续检查维表,发现同一用户同时存在两条有效记录:标签任务使用追加写,重跑时没有覆盖当日分区。
外层去重虽然让订单表恢复一行,却会随机保留其中一套标签,也没有阻止其他下游继续被放大。
正确处理应该是:
修复标签表的幂等写入和有效记录规则,校验 Join 侧唯一性,再重算受影响分区。
这个场景说明,结果重复只是症状,重复真正产生在更上游。
第四步:修复以后必须补上防线
修完当前数据还不够,还要让问题下次更早暴露。
可以补四道防线:
- 源表和维表建立业务主键重复监控
- Join 前验证被关联侧唯一性和基数
- 调度写入采用覆盖分区、Merge 或其他幂等策略
- 目标表监控总行数、主键数和重复倍数变化
对于一次重复事故,还要明确影响分区、受影响下游和重算顺序,避免只修当天结果。
数据质量闭环不是加一个 DISTINCT,而是让粒度、关联和写入契约都能被验证。