数据目录 Data Catalog 怎么设计才有人用?
面试怎么回答
Data Catalog 不能只做库表清单。我会围绕搜索、理解、判断可信、申请权限和开始使用这条路径,把技术元数据、业务术语、血缘、质量、负责人、权限和热度关联起来。Schema、SQL 血缘和使用日志自动采集,业务口径与责任边界由负责人确认,并在建表和变更流程中维护。最终用找数时长、搜索转化、文档覆盖和误用事件衡量效果。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
不少公司花几个月建了数据目录,页面里有十万张表,却没人敢根据目录直接取数:字段没解释、负责人离职、血缘停在半年前。
能搜索到表只是起点,真正有用的 Data Catalog 要帮用户回答“这是什么、能不能信、谁在用、出了问题找谁”。
Data Catalog 要把技术元数据、业务语义、血缘、质量、权限和使用反馈连成消费闭环;自动采集保证覆盖,人机协同保证语义和责任。
目录首先服务真实查数路径
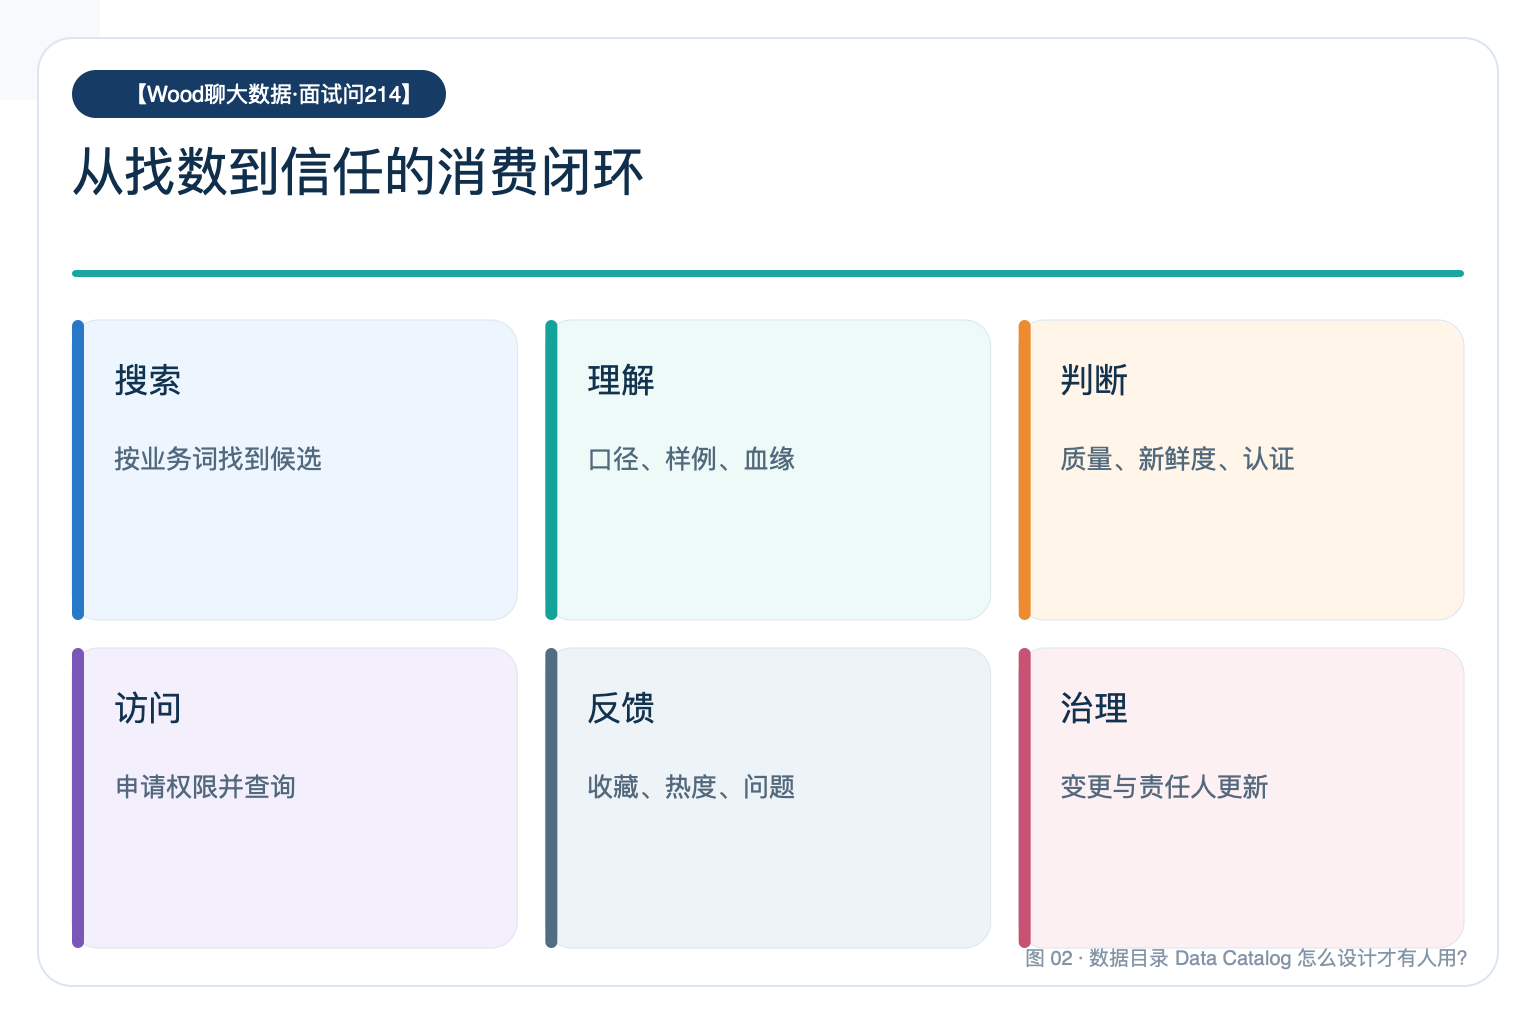
从用户任务反推信息架构:按业务词搜索指标,比较候选数据集,查看样例和质量,再申请权限并开始查询。若目录只按库表层级展示技术对象,业务用户仍然需要到群里问人。
元数据要分层组织
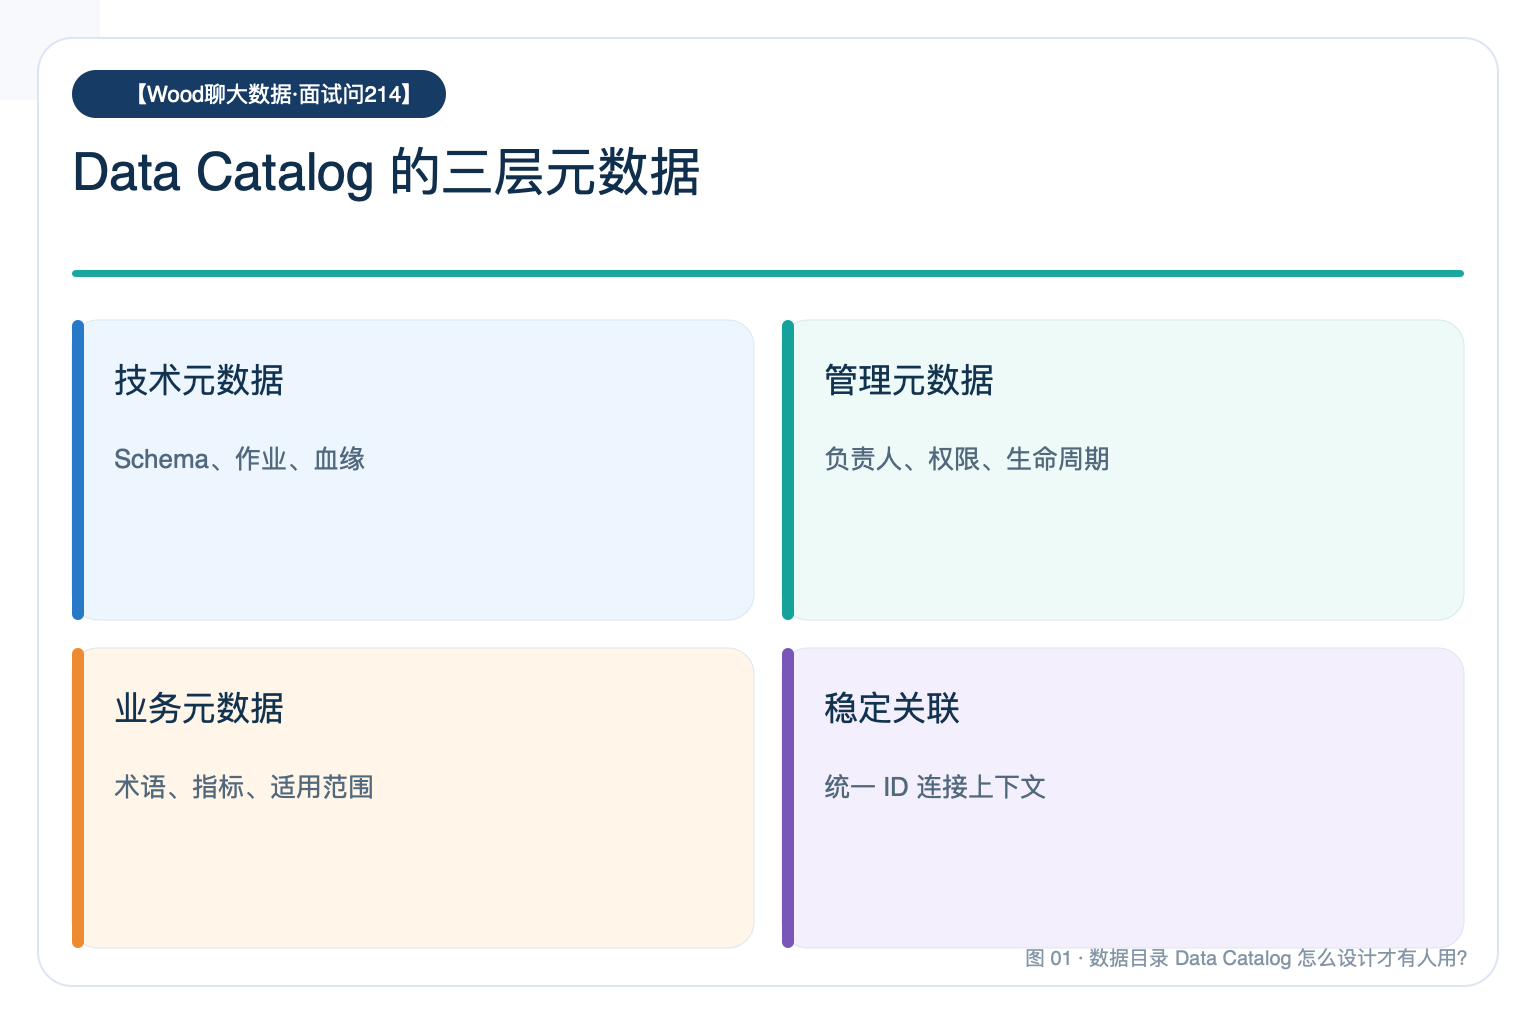
技术层包括库表字段、类型、分区、作业和血缘;管理层包括负责人、分级分类、权限和生命周期;业务层包括术语、指标口径、使用示例和适用范围。三层通过稳定 ID 关联,而不是把说明散落在多个系统。
自动采集解决覆盖和时效
从数据库、调度、SQL 日志、BI 和质量平台持续采集 Schema、血缘、查询热度与检查结果。采集任务本身也要有成功率和更新时间监控,否则目录会悄悄变成旧快照。
人负责机器推不出的语义
字段描述可以由 AI 辅助生成,但业务定义、责任人和可用边界必须确认。把认证流程嵌入建表、发布和变更流程,让负责人在工作发生时补齐信息,比季度集中填表更有效。
信任信号要在消费点出现
用户查看表时应同时看到新鲜度、质量趋势、最近变更、下游影响、认证状态和热门查询。质量红灯却仍标记“已认证”,会迅速消耗整个目录的可信度。
用使用指标迭代目录
关注搜索无结果率、从搜索到查询的转化、权限审批时长、文档覆盖率、失效负责人比例和被复用数据产品数。目录的成功不是对象数量,而是减少找数时间和误用事件。
参考资料
- OpenMetadata:Lineage Ingestion:https://docs.open-metadata.org/latest/connectors/ingestion/lineage