源表和目标表怎么对账?为什么行数一致还不够?
面试怎么回答
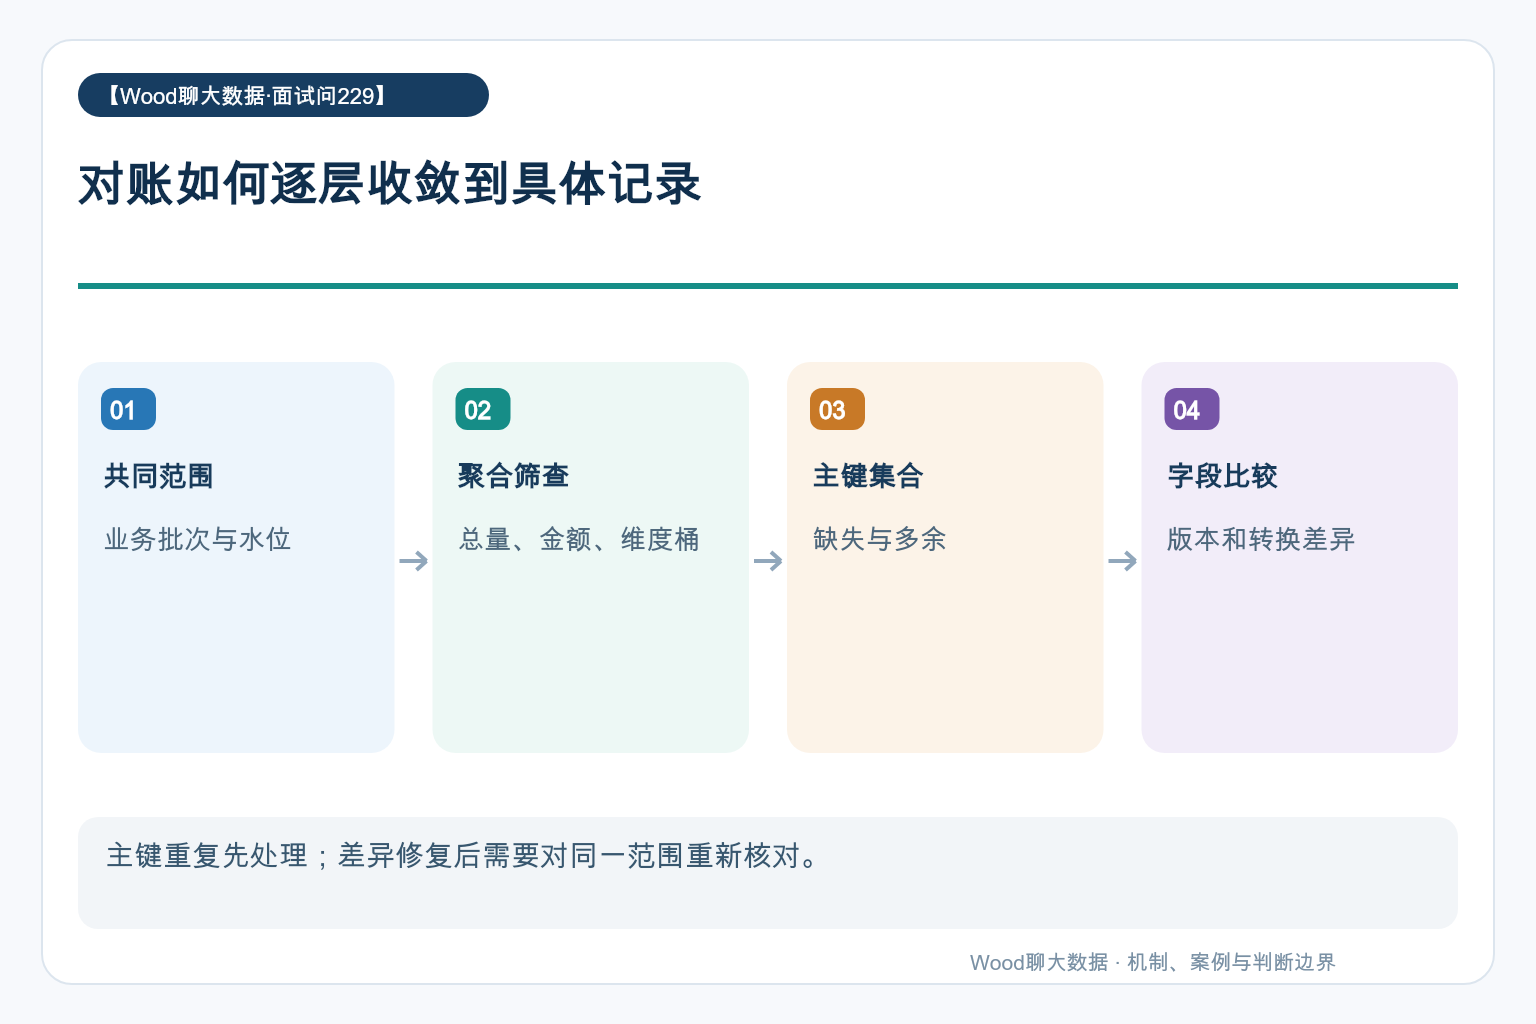
对账先统一业务口径和数据截止水位,再从总量、分组、主键到字段逐层下钻。总行数与金额只能筛查,漏一条多一条可能抵消;主键集合比较负责找缺失与多余,字段比较负责找版本或转换差异。摘要用于缩小范围,最终输出可解释的业务记录,补偿后按同一范围复核才能关闭问题。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
源表和目标表都是一百万行,两边金额合计也一样,能宣布同步正确吗?如果少了一笔一百元订单,又重复了一笔一百元订单,这两条检查会同时通过。对账需要逐层缩小不确定性。
先对齐比较范围和数据版本,再按总量、分组、主键和字段逐层定位;校验摘要用于筛查,最终差异需要落到可解释的业务记录。
先确认比较的是同一个集合
实时源表仍在更新,目标表有消费延迟,直接同时执行两个 COUNT 常常没有可比性。要选择共同的数据截止水位、稳定业务批次或可复现快照,并明确删除、退款和无效状态是否包含。
同时检查时区、币种、单位和主键定义。源端一行代表变更事件,目标端一行代表最新实体,这两张表天然不能用总行数直接相等作为规则,应先转换为相同的业务语义再核对。
总量筛查要逐步拆到有意义的维度
先比较记录数、主键去重数和关键金额,可以快速发现大范围问题。再按业务日、渠道、状态或稳定哈希桶拆分,找到差异集中的子集,而不是把两张巨表一次性全量拉到本地。
分组维度要兼顾排障价值和计算成本。总金额相等仍可能有正负抵消,主键数量相等也可能是一条少、一条多。每层规则只能缩小问题范围,不能把上层通过当作下层必然正确。
主键对账与字段对账分别处理
以正确的业务唯一键做集合比较,分成源端有目标端无、目标端有源端无、两端都有但字段不同。先检查重复键,否则全连接本身就可能放大差异行。
字段比较需要统一空值、数值精度、时间格式和字符串规范。NULL 与空字符串是否视为相同,要由口径决定;把它们都随手转成空串,可能把真实差异吞掉。结构化字段也要明确字段顺序是否影响业务等价。
摘要能减小数据量,但不是绝对证明
对分桶后的规范化记录计算摘要,适合先定位可疑桶。编码时需要包含字段边界、空值标记和稳定格式,防止字符串拼接产生歧义;哈希碰撞仍然意味着摘要一致不能作为数学上的逐行证明。
若用异或聚合,成对重复甚至可能抵消,因此应结合行数、唯一键检查和其他指标。高要求场景对可疑桶继续做明细比较,输出业务键与变化字段,避免告警只有一个让人无法行动的哈希值。
一个典型场景:两处错误刚好抵消
比如一次补数同时漏掉一条订单,又因重试重复写入另一条等金额订单,总量与金额全部通过。用户按渠道查看才发现一边少、一边多,团队最初怀疑报表过滤条件。
回到同一输入批次做主键集合核对后,才能找到漏单和重单各自的任务路径。原质量规则只看全局合计,完全没有识别业务身份。修复后应重新验证同一批次,并把缺失、多余、字段更新分别计数,记录根因和补偿水位。
对账报告要能直接指导处理
报告至少说明比较批次、差异范围、受影响指标、明细样例和建议处理方。区分源端晚到、同步丢失、目标重复与口径不一致,避免所有差异都自动触发重跑。
对可接受浮点误差要设置有业务依据的绝对或相对容差;精确结算金额则遵循约定精度。告警关闭以修复后的复核结果为准,不能因为补数任务成功就直接标记对账通过。