Schema Drift 怎么治理?
面试怎么回答
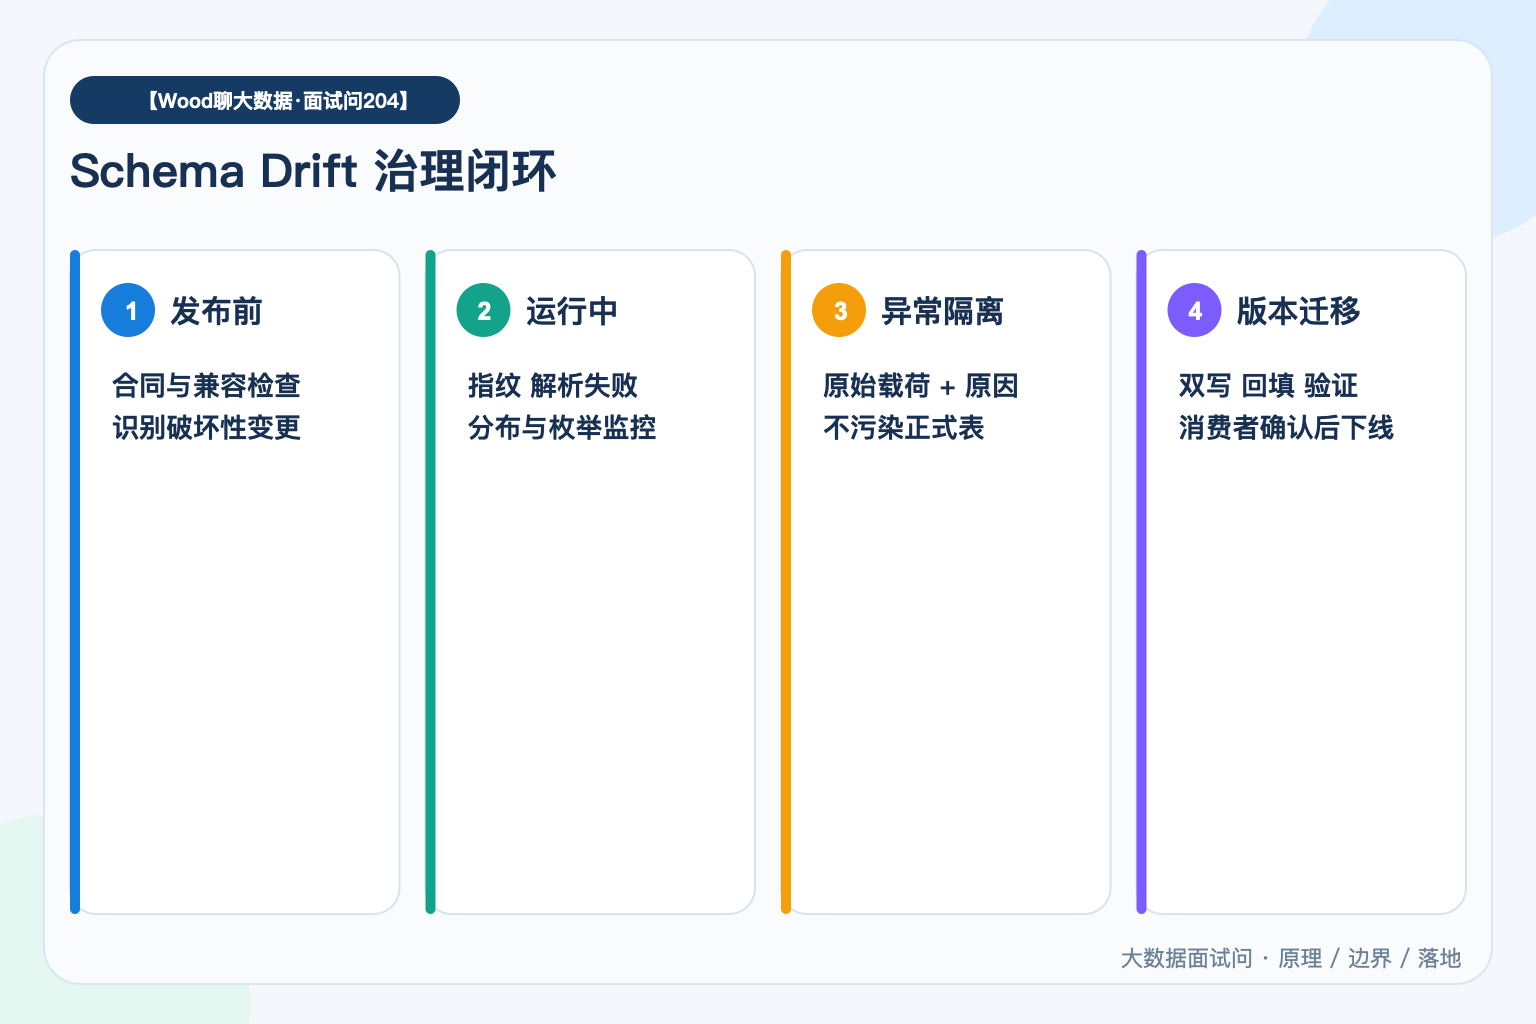
我会把 Schema Drift 分成结构、兼容性和语义三层。发布前用数据合同或 Registry 做兼容检查,破坏性变更必须版本化;运行期用 Schema 指纹和解析指标发现漂移,异常数据进入隔离区并保留原始载荷。迁移时双写新旧版本、做影响分析和消费者确认,最后再下线旧字段。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
字段没有被删除,任务也没有报错,指标却开始缓慢偏离。
因为 Schema Drift 不只包括列增删和类型变化,还包括单位、枚举、嵌套结构、默认值和业务语义悄悄改变。
Schema Drift 要按结构、兼容性和语义三层识别,并把发现、分级、隔离、迁移和追溯做成发布前与运行期的闭环。
先把漂移分成三层
结构漂移包括字段增删、重命名、类型和嵌套层级变化;兼容性漂移关注旧消费者还能否读取;语义漂移则是单位、枚举含义、时区和统计口径变化。第三类最隐蔽,因为 Schema 看起来完全没变。
不要把自动演进当成自动正确
允许新列自动进入湖仓表,可以减少任务失败,但也可能把拼写错误、错误类型和敏感字段扩散到下游。自动演进只能解决“存得进去”,不能替代字段审批、语义确认和消费者影响分析。

发布前做契约兼容检查
生产者提交变更时,先与数据合同或 Schema Registry 比较。新增可空字段通常风险较低;删除字段、收窄类型、改变主键、单位或枚举含义属于高风险。高风险变更应阻断发布或进入版本化迁移流程。
运行期做发现与隔离
对消息流、API 和文件落地持续采样 Schema 指纹,发现未知字段、类型分布变化和解析失败。不能识别的数据进入隔离区并保留原始载荷、来源、批次和错误原因,避免既丢数据又污染正式表。
迁移要给消费者过渡窗口
破坏性变更应采用新字段或新版本双写,让消费者完成验证后再下线旧字段。回填历史数据时明确默认值和不可恢复范围。对于枚举或单位变化,最好让旧值与新值同时可解释,而不是直接覆盖历史语义。
闭环靠 Owner 和影响面
每个数据产品要有生产者 Owner、消费者清单、变更记录和回滚方式。监控不仅报“Schema 变了”,还要说明影响哪些表、指标、接口和任务,以及谁需要在什么时间前完成迁移。
参考资料
- Data Contract Specification:https://datacontract.com/