数据血缘怎么设计才真正有用?
面试怎么回答
我会先统一 Dataset、Job、Run 的标识,再结合 SQL 静态解析和引擎运行事件采集表级血缘;对核心指标逐步补字段映射,并标明来源与可信度。血缘还要关联负责人、质量、SLA 和版本,接入发布影响分析、故障定位和告警闭环。判断血缘是否有用,不是看 DAG 有多少条边,而是看一次字段变更能否准确找到受影响资产和责任人。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一个字段准备改口径,平台画出了几百条上下游连线,却没人敢回答:哪些报表会错、谁负责确认、今天能不能发布?
这说明系统“采集了血缘”,但还没有把血缘变成可行动的信息。
有用的血缘不只是一张 DAG,而是把资产、作业、字段、运行实例和负责人连接起来,能够支持影响分析、故障定位和变更闭环。
第一层:先统一血缘对象和标识
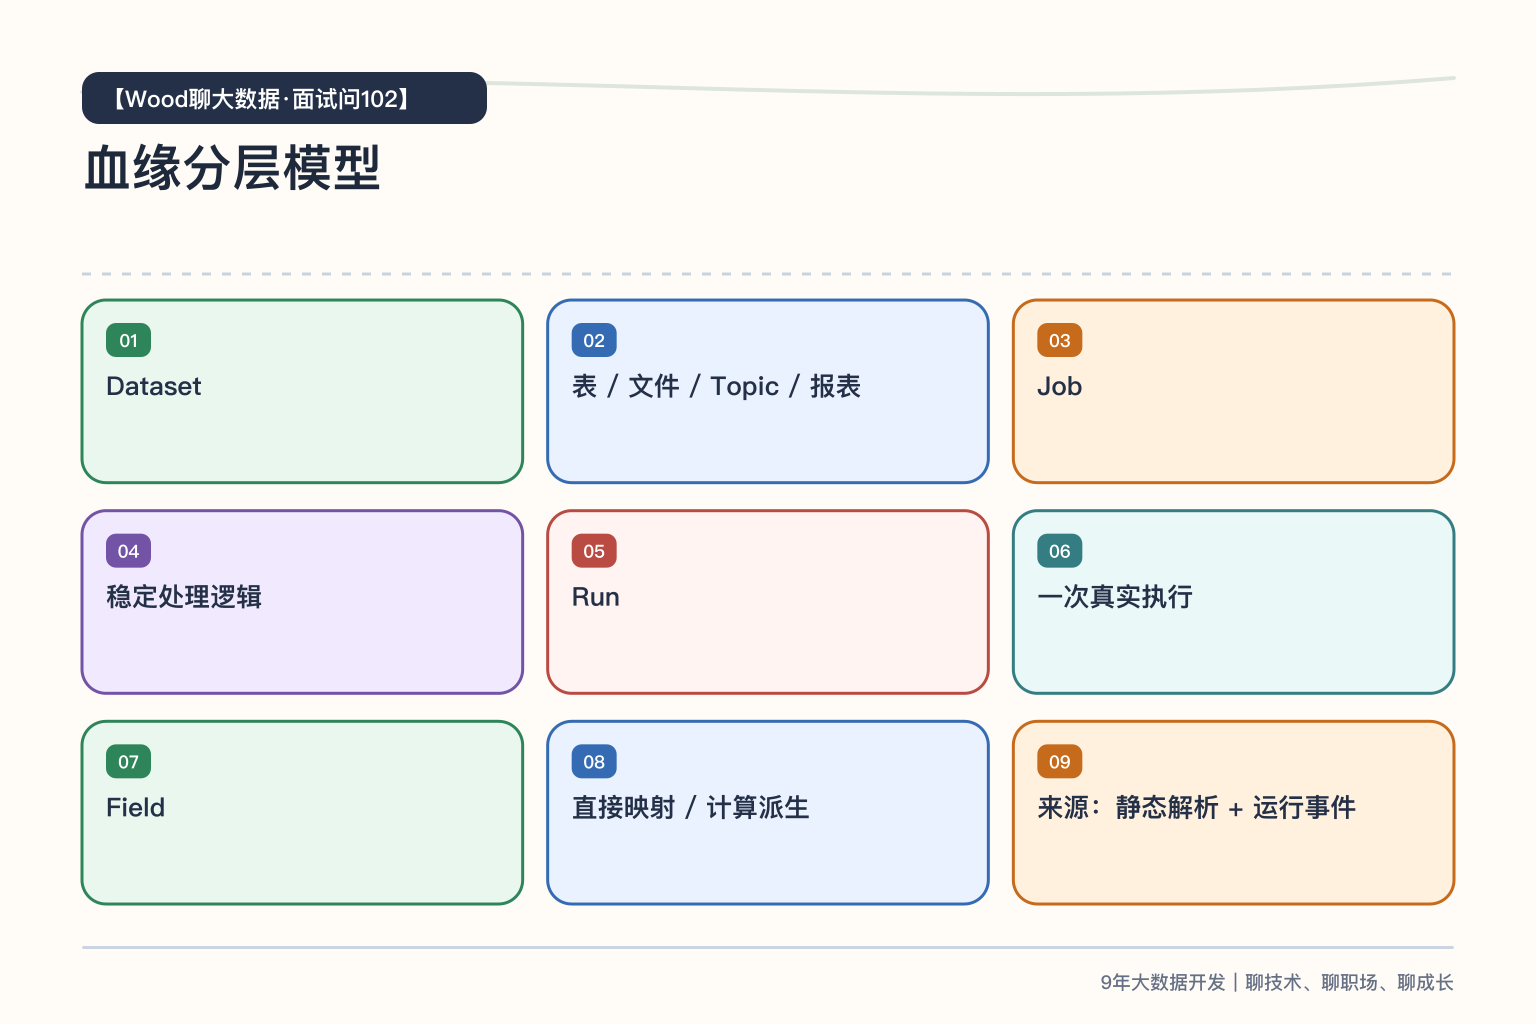
最基本的对象包括 Dataset、Job 和 Run。Dataset 可以是表、文件、Topic 或报表数据集;Job 表示稳定的处理逻辑;Run 表示某次具体执行。
每个对象要有稳定唯一标识。只用表名容易遇到同名库、跨环境和临时表冲突;只记录调度节点,又无法表达一条任务读写多张表。命名空间、平台、项目、库表和环境需要形成统一规则。
第二层:采集静态与运行时血缘
静态解析从 SQL、代码和配置提取读写关系,覆盖面大,但动态 SQL、UDF、临时表和运行分支可能解析不全。
运行时采集从引擎、调度或事件中获取这一次真正读取和写入的资产,还能关联开始、完成、失败和数据版本,但接入成本更高。
两者应该互补:静态血缘用于变更前分析,运行血缘用于证明实际发生了什么;冲突时要标明来源与可信度,不能悄悄合并成一条“确定”关系。
第三层:从表级走向关键字段级
表级血缘能回答任务链路,字段级血缘才能回答“改这个字段影响什么”。解析要保留字段映射、表达式、聚合和过滤来源,同时区分直接映射、计算派生和控制依赖。
不是所有字段都必须一次做到完整。可以先覆盖核心指标、公共维度和高风险表,并保留未知节点,避免为了画完整图而制造错误关系。
第四层:把血缘接入工作流
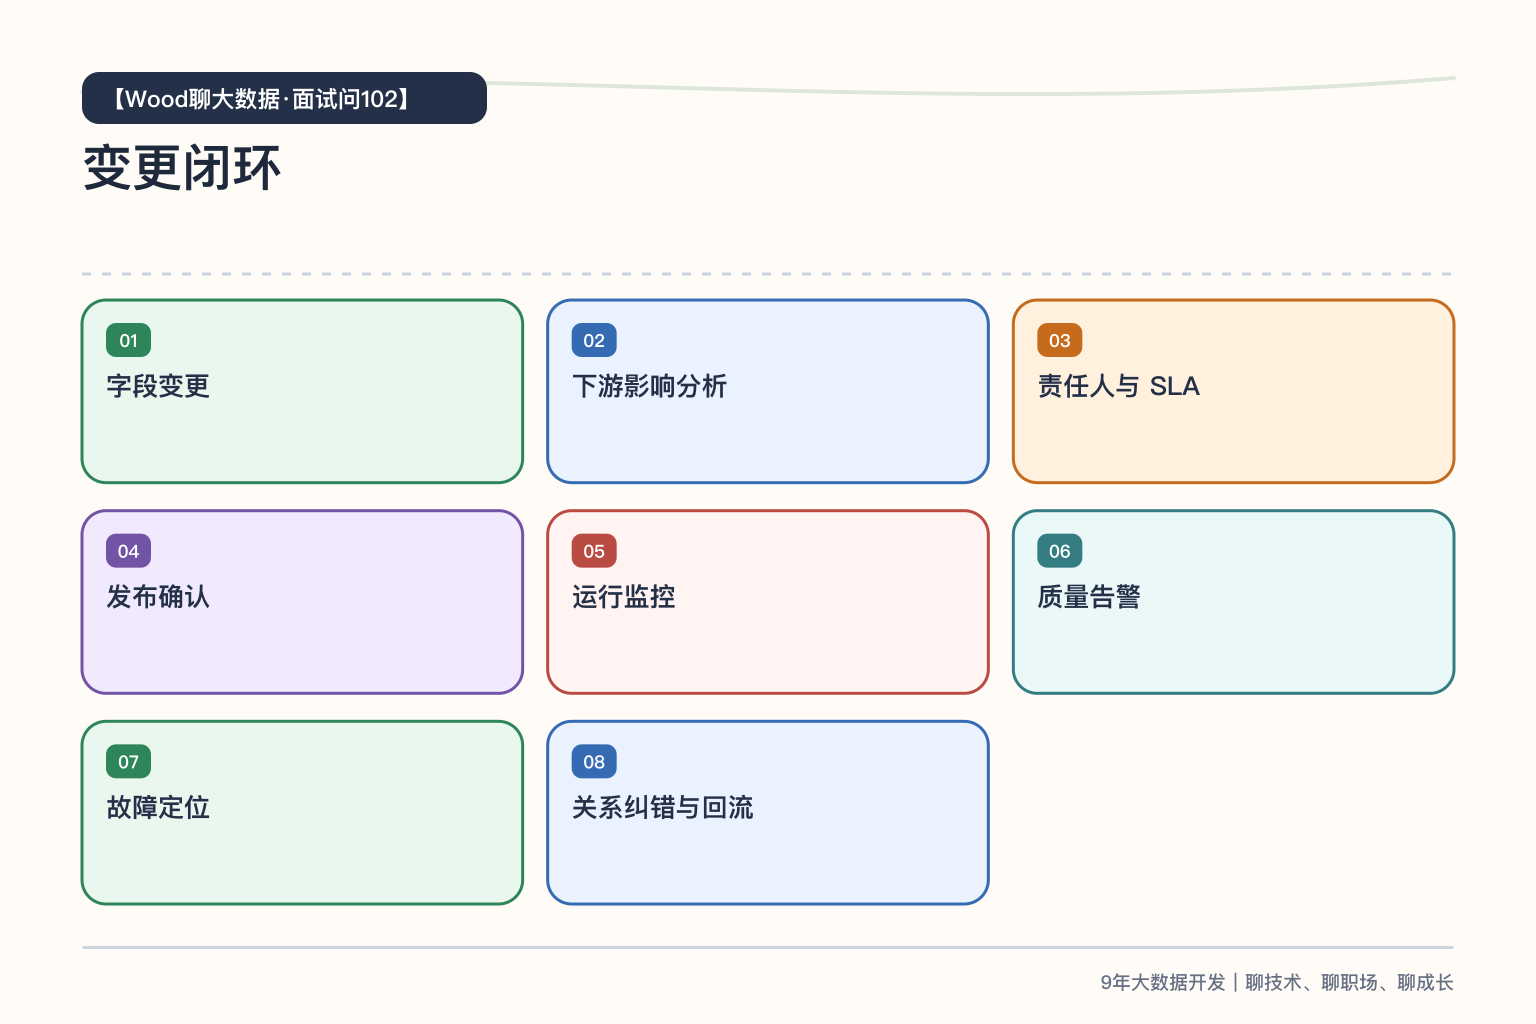
变更发布前自动列出下游任务、指标、报表、负责人和 SLA;任务失败时沿上游寻找最近异常;数据质量规则触发后,把影响范围推给真正负责的人。
血缘还应带上所有权、分级、质量状态、运行时间和变更记录。否则面对数百个节点,使用者仍然无法判断优先级。
一个典型反例
团队通过 SQL 解析生成了漂亮的表级 DAG,却没有处理任务改名、临时表和跨集群同名表。几个月后出现大量重复节点和断边,大家逐渐不再相信影响分析。
根因不是图不够漂亮,而是标识、运行校验和责任治理缺失。修复时应先统一资产 ID,再用真实 Run 事件校验边,给无法解析的关系标记置信度,并让负责人能够确认和纠错。