Kafka 分区数怎么设计?
面试怎么回答
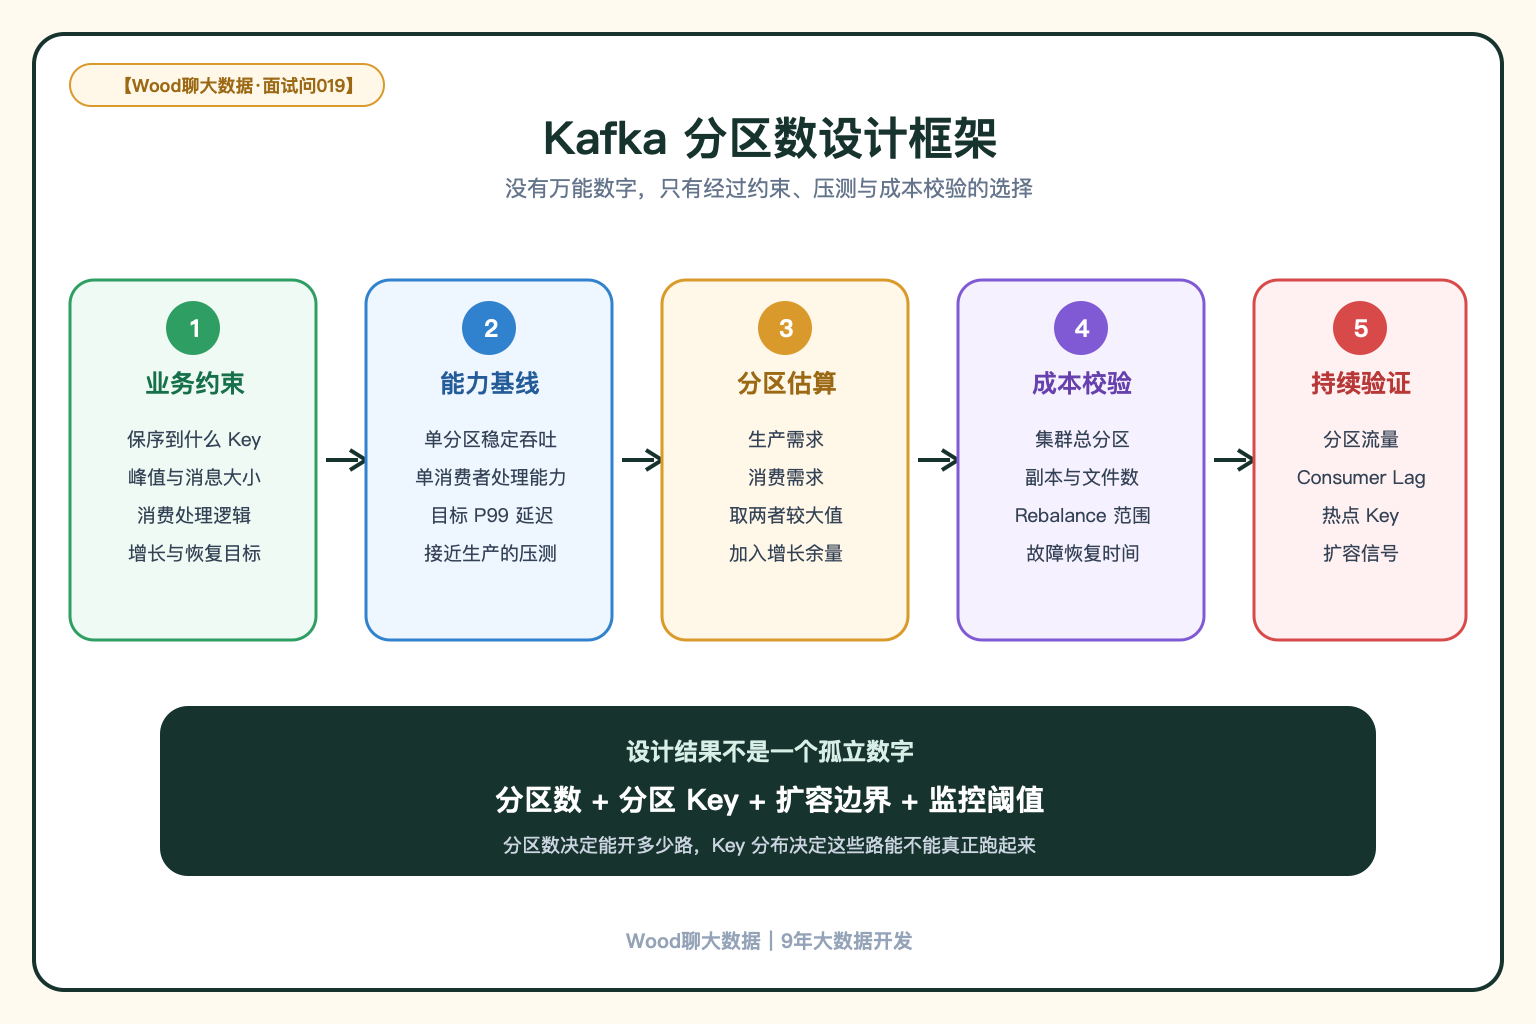
我会先确认业务需要按什么 Key 保序,再根据峰值生产吞吐、消费处理能力和真实压测结果估算基础分区数,因为同一消费组的有效并发不会超过分区数。然后结合增长预期预留余量,同时评估集群总分区、复制开销、Rebalance 和故障恢复成本。上线后持续看各分区流量、Lag 和 Key 倾斜。需要扩分区时,还要确认分区器变化是否影响同 Key 顺序以及下游状态,不能只把分区数当成越多越好的并发参数。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会直接回答:
“分区数等于 Consumer 数量,或者尽量多建一些。”
这两个答案都不完整。
分区同时决定吞吐并行度、消费并发上限、同 Key 顺序边界,也会增加 Broker 和客户端的管理成本。
所以设计分区数,本质上是在回答:
这条 Topic 需要多少并行能力,又愿意为未来扩容保留多少成本和余量。
第一步:先确认顺序性边界
Kafka 保证的是单个 Partition 内有序,不是整个 Topic 全局有序。
如果业务要求同一个订单、用户或设备的事件按顺序处理,就要使用稳定 Key,让同 Key 数据进入同一分区。
这时还要检查 Key 的分布是否均匀。即使建了很多分区,如果大部分流量只来自少数热点 Key,仍然会出现热点分区,消费并行度也用不满。
如果要求全局严格有序,通常只能收缩到单分区或在下游引入额外排序机制,但吞吐和可用性设计也会受到影响。
第二步:用压测估算吞吐和并发需求
不要给所有 Topic 套一个固定数字。
可以从两个方向估算:
生产端吞吐
根据峰值写入吞吐、消息大小、压缩方式、副本数和 Broker 能力,压测单分区在目标延迟下能稳定承载多少流量。
消费端处理能力
同一个 Consumer Group 中,一个 Partition 同一时刻只会交给一个 Consumer 实例处理。因此,有效消费并发不会超过分区数。
可以用下面这个思路做初始估算:
基础分区数 ≈ max(
  峰值生产吞吐 / 单分区稳定写入能力,
  峰值消费吞吐 / 单消费者稳定处理能力
)
这里的单分区和单消费者能力必须来自接近真实消息大小、处理逻辑和硬件条件的压测,而不是网上的固定经验值。
第三步:给增长留余量,但不要无限放大
分区数过少,后续扩容受限;分区数过多,也不是没有代价。
过多分区会带来:
- 更多日志段、索引和打开文件
- 更多副本复制和 Leader 管理
- 更大的元数据和请求开销
- Rebalance、故障恢复和 Leader 切换范围扩大
- 单分区批次变小,吞吐效率可能下降
因此我通常会在压测基线之上预留明确的业务增长余量,再结合 Broker 规模、复制因子和集群内总分区数做容量评估。
第四步:扩分区前先评估数据语义
Kafka 可以增加分区,但不能把它理解成无风险的在线扩容按钮。
分区数变化后,默认分区算法对 Key 的映射结果可能变化。扩容前后的同一个 Key 可能进入不同分区,如果业务依赖跨扩容时点的严格顺序,就需要提前设计迁移和切换策略。
实际操作前,我会确认:
- Producer 使用什么 Key 和分区器
- Consumer 是否依赖分区内顺序和本地状态
- 是否需要停写、双写或按时间点切换
- 下游任务并行度、状态和监控是否同步调整
- 旧数据与新数据的顺序边界如何解释
如果一条 Topic 中的业务顺序要求、保留周期和吞吐模型差异很大,也可以考虑拆 Topic,而不是用一个分区数勉强兼容所有场景。
一个典型场景
比如一条用户行为 Topic 有 24 个分区,Consumer Group 也扩到 24 个实例,但仍有大量积压。
监控发现只有 3 个分区流量特别高,其他 Consumer 基本空闲。继续增加分区和 Consumer 并没有解决问题。
最后定位到 Producer 使用渠道 ID 作为 Key,业务流量高度集中在少数渠道。
这时真正要调整的是分区 Key:在不破坏所需顺序语义的前提下,选择更细、分布更均匀的业务 Key,或者单独拆分热点业务。
分区数解决并行度上限,合理的 Key 才决定流量能否均匀使用这些分区。