Kafka Consumer 调用 seek 后,消费组的提交位点也会改变吗?
面试怎么回答
seek只改变当前消费者对已分配分区的读取位置,不自动修改消费组已提交位点。我要分别记录拉取位置、业务完成边界和提交位置,提交的是下一条待处理位置。回放前先处理在途批次和自动提交,避免旧工作线程继续提交新位点;重启和重平衡后按恢复策略重新确认。正式回放还需输出隔离或幂等,不能把读回旧消息等同于业务撤销。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
调试时把某个分区seek回去,几条旧消息确实重新读到了。可重启消费者后,它又从原来的较新位置继续。seek明明执行成功,为什么这次“回退”没有被记住?
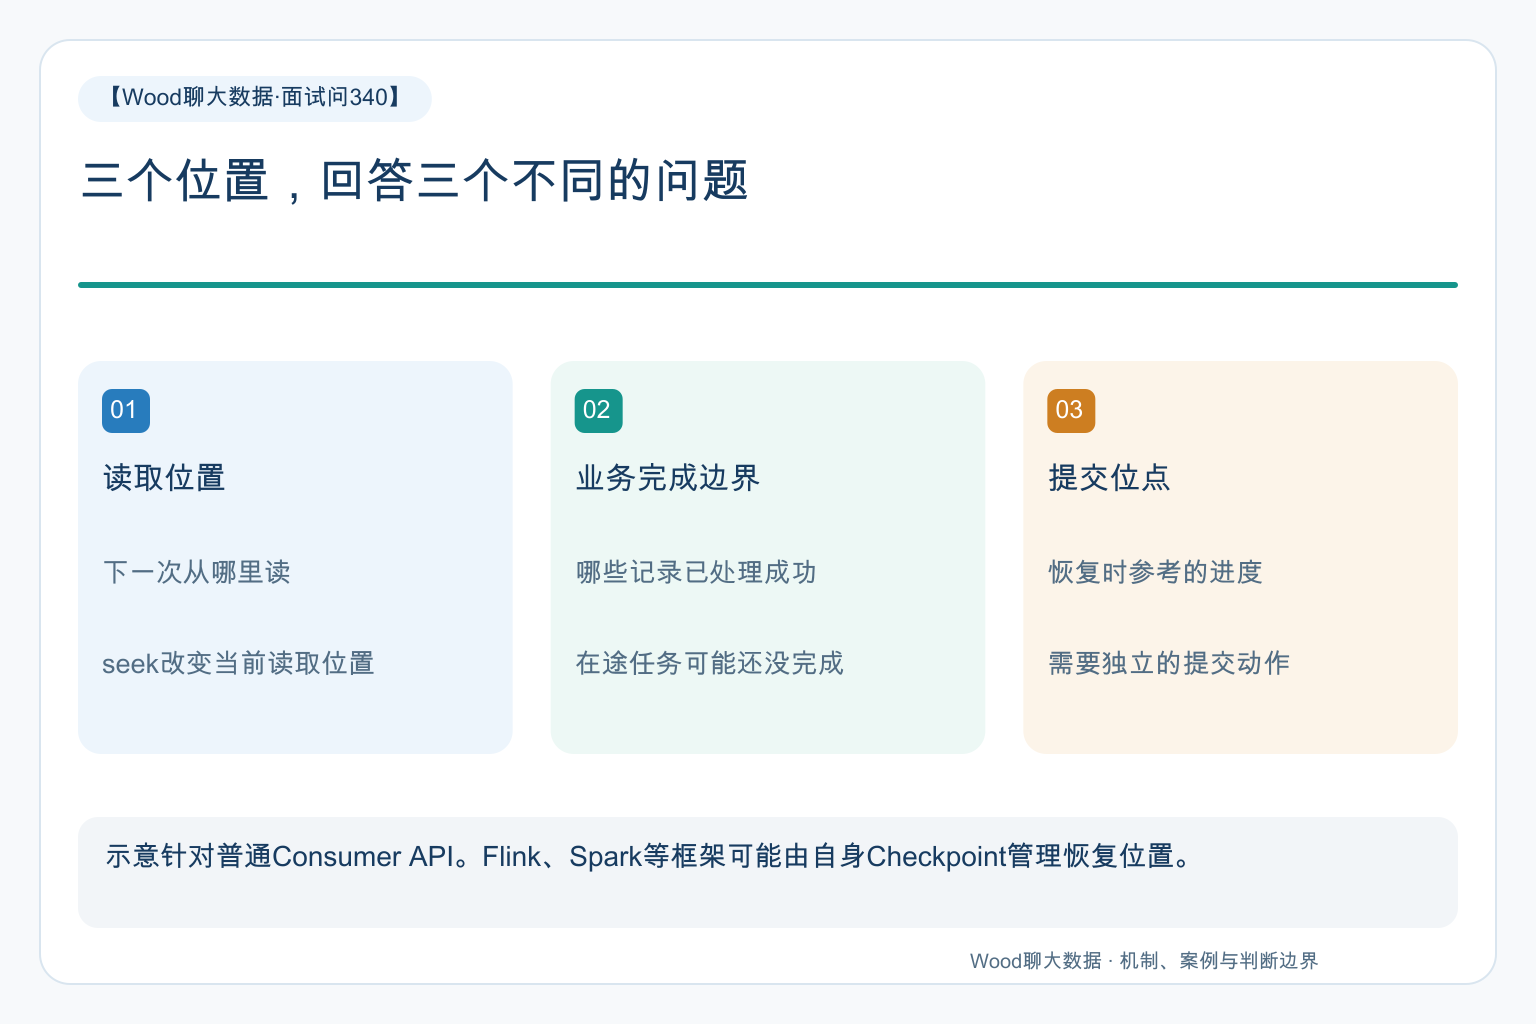
seek改变当前消费者的读取位置,提交位点是另一份持久化进度;已拉取、已处理和已提交必须分别跟踪。
offset不是一个变量的三个别名
Consumer当前读取位置表示接下来从哪里继续取数据。poll返回一批记录后,这个位置可能已经前进,但业务处理不一定完成。
已提交位点则是消费组保存的恢复信息。正常恢复会参考它,但应用自己的分配回调和seek逻辑也可能改变实际起点,不能只看一个值就推断所有运行行为。
还有一个应用层的处理完成边界,Kafka不会自动知道数据库写入、文件导出或远程调用是否真正成功。多线程处理时,这个边界尤其容易落后于读取进度。
seek不是提交,更不是回滚业务
seek针对当前消费者已经分配的分区,覆盖后续读取使用的位置。它不会同步撤销已经输出的业务结果,也不会自动持久化为消费组的提交进度。
例如已提交位置为200,临时seek到100,进程随后退出,而提交值没有改变,重启就可能仍参考200恢复。这个行为并不意味着seek失效,而是两个API负责不同事情。
位置还必须位于可用日志范围内。保留策略已经清掉的历史记录,不能靠seek凭空找回来;超出范围的行为还受auto.offset.reset等配置影响。
这里的数字仅用于解释位置,不表示期间一定有等量业务消息,日志位点可能存在间隔。
提交的是下一条需要处理的位置
假设按序完成了offset为100、101、102的记录,下一条待处理位置通常记为103。不要把“最后完成记录的offset”和“提交的下一位置”混为一谈。
若批次内出现并行处理,102先成功但101仍失败,就不能因为看到了较大的成功offset而越过未完成记录提交。
同一分区应维护连续完成边界;跨分区则分别维护,不能把一个分区的进度代替另一个。事务消费或框架托管场景还应遵循相应协议,不宜从外部随意提交。
一个典型场景:回放刚开始,又跳回了新位置
假设维护人员暂停拉取并seek到旧位置,但此前提交给线程池的批次仍在处理。旧任务随后成功,把较新的offset再次提交。
表面上是“Kafka记不住回退”,实际是读取位置、在途处理与提交逻辑没有形成一致的切换。原检查只验证seek后的第一条记录,没有观察后台提交及重启行为。
修正需要在受控停顿中确认分区所有权,处理或隔离在途任务,明确提交策略,再执行批准的回放范围。不能仅把自动提交关掉就认为问题结束,应用手动提交也可能来自旧批次。
对于正式业务回放,独立消费组和隔离输出通常更容易管理,但仍需防止重放触发重复扣费、重复通知等副作用。
重平衡会让临时假设失效
使用订阅与消费组分配时,分区可能被撤销后重新分配。回放代码需要在正确的生命周期处理读取位置,不能在每次poll之后无条件seek,否则可能反复读取同一段。
消费者本身的线程使用也要遵循API约束。工作线程处理结果应通过协调机制交回消费线程,不要让多个线程同时随意操作同一个Consumer。
如果任务由Flink或Spark托管,恢复位置可能来自框架状态,而不完全由消费组提交值决定。直接使用外部工具修改提交位点,未必能改变框架下一次恢复起点。
真正可靠的排查记录,应把分区身份、当前分配、读取位置、已完成边界、提交值和观察时间放在一起,才能解释一次重启为什么从那里开始。