Kafka max.poll.records 调小就能防 OOM 吗?Poll 和 Fetch 有什么区别?
本文目录
面试怎么回答
我会先区分Fetch与Poll。max.poll.records只限制单次poll返回的条数,不改变底层拉取行为,客户端还可能缓存其他记录。内存排查要看Fetch字节配置、分区数、压缩解压放大、反序列化对象和应用队列。调小批次有助于控制单批处理时间,但不能当成进程内存硬上限;还要验证消费节奏和位点提交安全。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
消费者每次只处理十条消息,堆内存还是持续上涨。有人觉得配置没生效,其实可能是把两件事混为一谈:从Broker拉取了多少,以及这次poll交给应用多少。
max.poll.records限制交给应用的单次记录数,不直接限制底层Fetch;内存还取决于缓存、字节批次、解压和应用队列。
Poll不是每次都现去网络取一小包
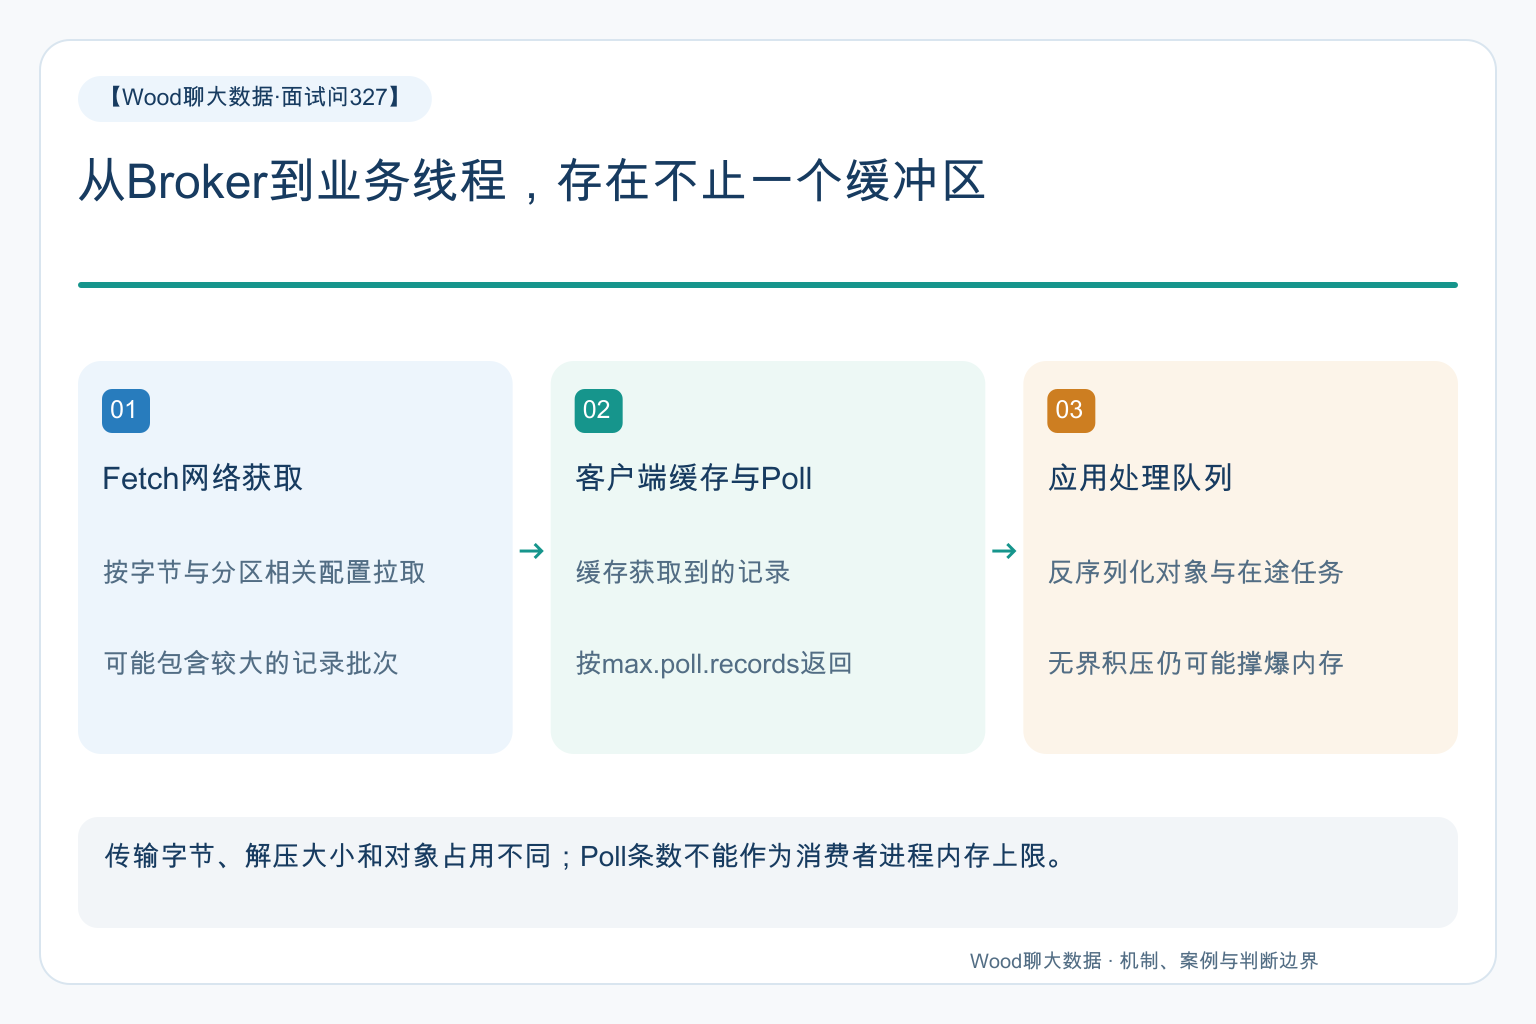
消费者会从Broker获取记录并保存在客户端缓存中,poll再把其中一部分返回给应用。网络获取与应用处理因此不是一一对应的动作。
Kafka 4.0文档明确,max.poll.records不影响底层Fetch行为。把它从较大值改成十,并不意味着网络层只拉十条,更不意味着整个消费者只会持有十个记录对象。
这个参数仍然有价值:它可以限制单次应用批次的条数,帮助控制处理时间和业务批量大小。但它解决的是一层边界,不是所有内存来源。
字节限制也不是进程内存上限
fetch.max.bytes面向一次Fetch请求的返回数据量,max.partition.fetch.bytes面向单分区获取规模。还要结合消息批次大小、分区分配和并行Fetch观察。
为了保证消费能够推进,首个非空分区的首个记录批次大于相关Fetch限制时,存在仍然返回该批次的情况。因此不能把这些配置简单理解成绝对不会越过的硬内存护栏。
更重要的是,传输中的压缩字节不等于解压后的记录大小,也不等于反序列化成业务对象后的堆占用。小文件或小网络包,并不能直接证明内存需求小。
内存增长可能发生在应用队列
如果poll线程持续把记录放进无界线程池队列,而业务线程处理很慢,即使每次只交付十条,几千次轮询之后也可能积累大量对象。
应检查队列长度、在途批次数、处理吞吐与输入吞吐。如果应用解耦读取和处理,需要有界队列、明确反压或暂停分区策略,并遵守消费者客户端的线程使用约束。
也要注意对象保留。错误日志上下文、缓存、批次结果集合和异步回调,都可能让处理完成的记录继续被引用,不能所有问题都归咎于Kafka客户端。
批次变小,需要和处理节奏一起看
较小的poll批次可能缩短一次处理耗时,有助于及时继续轮询,但也可能增加调用和提交开销,降低批量写入效率。
如果单条消息本身处理很慢,单纯减条数仍未必满足轮询间隔要求。应把最慢记录、下游超时和重试耗时纳入评估,而不只使用平均处理时间。
位点提交也必须与已完成业务结果匹配。把消息放入队列不等于已经安全处理;如果提前提交,进程崩溃时队列中的数据可能无法按预期重放。
一个典型场景:十条一批仍然被打爆
假设一个消费者把max.poll.records设为十,随后将每批提交到异步写库线程池。数据库变慢后,内存不断上涨,团队最初继续调低Fetch大小。
排查发现主要对象留在无界任务队列里,生产速度一直高于写库速度。旧压测使用快速下游,只观察单次poll返回条数,没有模拟下游停顿,所以没有发现积压。
修正时限制在途任务和队列容量,设置可解释的暂停恢复规则,并让位点只推进到连续完成的边界。然后模拟下游变慢、超时和进程重启,检查内存、积压与重复处理结果。
用两类指标共同验收
一类是资源指标:堆、直接内存、GC、客户端获取规模与应用队列。另一类是业务进度:已拉取、已交付、已处理、已提交的边界。
只有把这几条线放在一起,才能判断调参是在真正降低风险,还是把记录从一个缓冲区搬到了另一个缓冲区。面试中说清楚Poll与Fetch的区别,往往就能打开这条排查思路。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。