Kafka 为什么吞吐量高?
面试怎么回答
Kafka 的高吞吐来自整条数据路径设计。Partition Log 追加写,减少随机 I/O;Producer、Broker 和 Consumer 批量处理,配合批量压缩摊薄网络和存储开销;Broker 利用 Page Cache,并在适用链路上用零拷贝减少复制;Topic 分区提供跨 Broker 和 Consumer 的并行能力。调优时还要在 Batch、Linger、压缩、分区、延迟和可靠性之间取舍。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会回答:
“因为 Kafka 顺序写磁盘,还用了零拷贝。”
这是两个重要点,但只回答到局部。
Kafka 的高吞吐来自一整条数据路径上的协同:
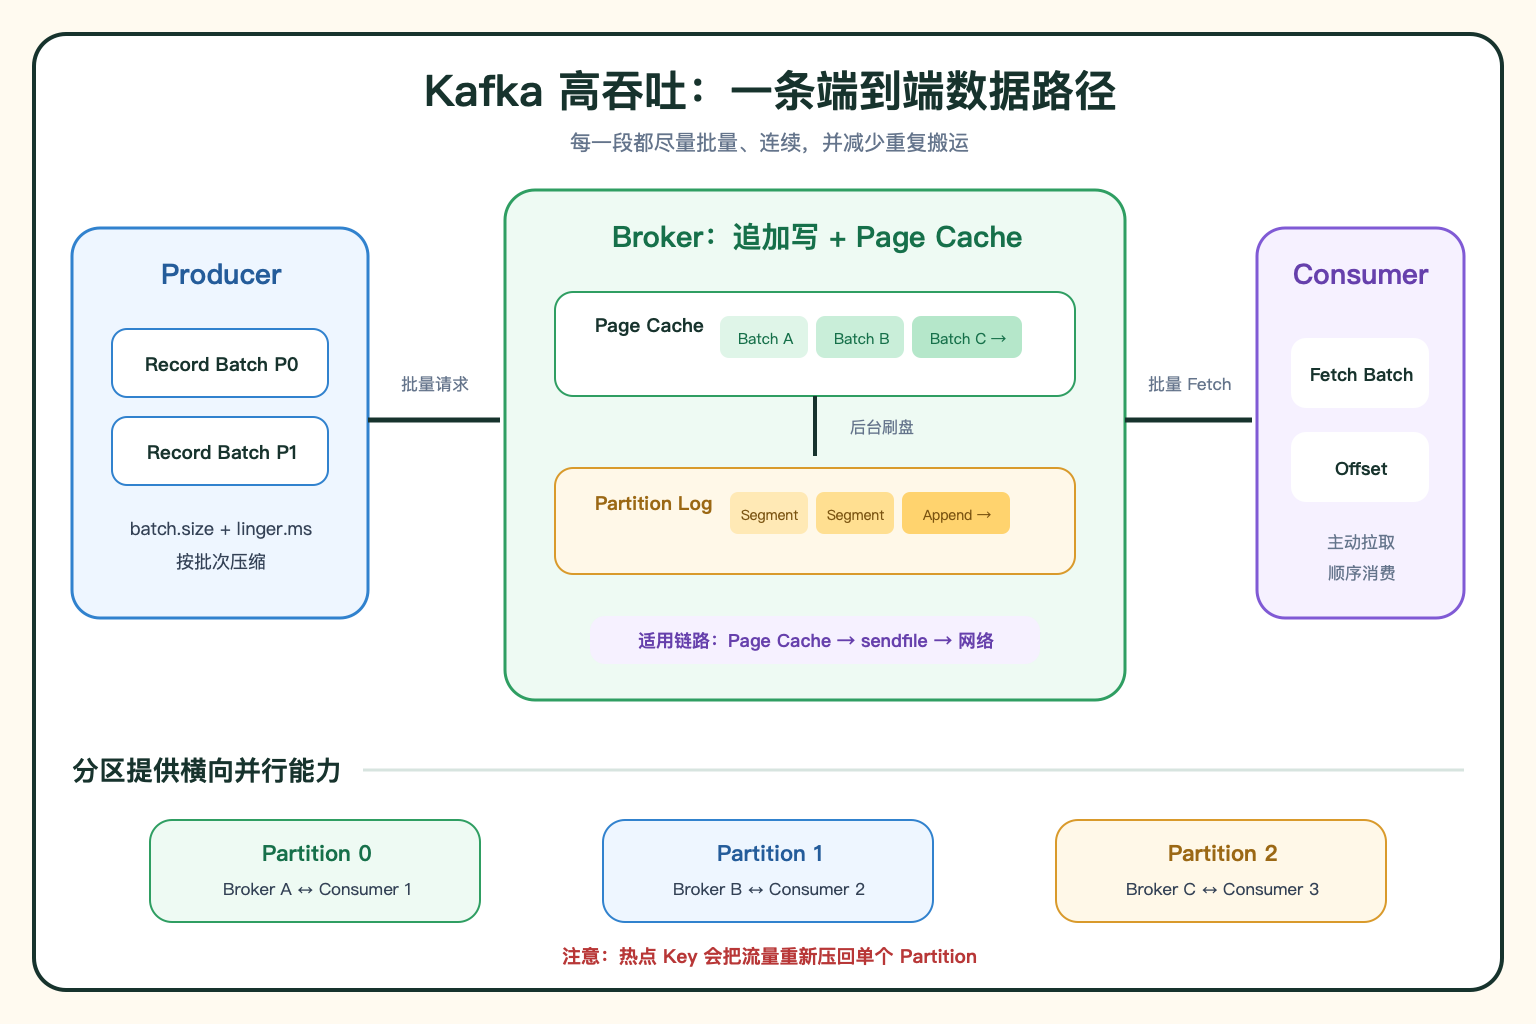
追加日志减少随机 I/O,批量与压缩摊薄请求成本,页缓存与零拷贝减少数据搬运,分区机制提供横向并行能力。
第一步:追加日志,把随机写变成连续写
Kafka 的 Topic 被拆成多个 Partition,每个 Partition 本质上是一份有序日志。
新消息不是在文件中间反复修改,而是追加到分区日志末尾。Broker 也不需要为每个 Consumer 维护一份独立消息副本,Consumer 通过 Offset 记录自己的读取位置。
这种设计让持久化路径更接近连续写,避免大量随机寻址,也让数据量增长后仍能按照 Offset 顺序读取。
所以 Kafka 的优势不是“磁盘比内存快”,而是通过合适的数据结构,把磁盘用在它擅长的连续 I/O 上。
第二步:批量传输,把单条消息成本摊薄
如果每条消息都单独发起一次网络请求、单独写盘,吞吐量会被大量小 I/O 和系统调用消耗。
Kafka Producer 会按 Partition 在内存中积累 Record Batch,再批量发送;Broker 批量追加日志,Consumer 也按批次拉取数据。
批量带来几类收益:
- 更少的网络往返和系统调用
- 更大的连续磁盘写入
- 更好的内存局部性
- 更高的压缩比
batch.size 决定批次容量,linger.ms 允许 Producer 在未装满时短暂等待更多消息。等待更久通常有利于形成大批次,但也可能增加低负载下的单条消息延迟。
第三步:压缩、页缓存和零拷贝减少搬运
Kafka 的压缩针对整个消息批次,而不是每条消息各自压缩。相似字段越多,批量压缩通常越有效,也能减少网络和磁盘占用。
在存储层,Kafka 大量利用操作系统 Page Cache。写入先进入页缓存,由操作系统负责后续刷盘;热点数据也可以直接从缓存读取。
在适用的数据传输链路上,Kafka 可以利用 sendfile 一类零拷贝机制,把页缓存中的数据直接送到网络,减少内核态和用户态之间的重复复制。
这里要注意:
零拷贝不是所有链路、所有安全协议下都无条件生效,所以它是重要优化,但不是 Kafka 高吞吐的唯一答案。
第四步:分区让读写能够横向扩展
一个 Topic 可以有多个 Partition,分布在不同 Broker 上。Producer 可以并行写入多个 Partition,Consumer Group 中的多个 Consumer 也可以并行消费不同 Partition。
因此,Kafka 的吞吐上限不是只由单台 Broker 决定,还取决于:
- 分区数是否与并行度匹配
- Partition Leader 是否均衡分布
- 消息 Key 是否造成热点分区
- 网络、磁盘和 Consumer 处理能力是否匹配
分区也不是越多越好。过多分区会增加元数据、文件句柄、副本复制和故障恢复成本。
第五步:高吞吐背后都有取舍
吞吐优化不能脱离延迟、可靠性和资源成本。
- 更大的 Batch 和更长的 Linger:减少请求,但可能增加等待延迟和内存占用
- 更高的压缩比:节省网络和磁盘,但消耗更多 CPU
acks=all和更多副本确认:提高可靠性,但写入链路更长- 更多 Partition:提高并行能力,但增加集群管理成本
生产上要根据消息大小、流量峰值、延迟目标、可靠性要求和 Consumer 能力一起压测,而不是照搬一组参数。
一个典型场景
比如 Kafka Broker 的 CPU、磁盘都还有余量,但 Producer 每来一条消息就同步发送,批次很小,请求数却非常高。
这时只升级 Broker 硬件未必有效。更应该先看 Producer 的平均批次大小、请求速率和压缩情况,再根据延迟要求调整 Batch、Linger 和压缩方式,让更多消息共享一次网络与存储开销。
如果流量仍集中在少数 Partition,还要继续排查 Key 分布和热点,而不是把“吞吐不够”统一归因到磁盘。
Kafka 的高吞吐不是某一个黑科技,而是让数据尽量成批、连续、少搬运,并且能够并行处理。