Kafka Consumer Group 协调机制是怎样的?
面试怎么回答
Consumer 会先找到 Group Coordinator,加入同一个 group.id,并通过心跳维持成员身份。Coordinator 负责成员和分区分配状态,Consumer 真正拉取数据,同组内一个分区同一时刻只归一个消费者。Offset 独立记录处理进度。Kafka 4.0 起还要区分 Classic 和新 Consumer 协议,后者采用服务端分配和增量协调。生产上我会同时关注心跳、处理时长、Rebalance、提交边界和幂等。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
Consumer Group 不只是“多个消费者平分分区”。
真正维持它运行的,是成员发现、心跳、分区分配和 Offset 四套边界。
Coordinator 管理组成员与分配状态,Consumer 真正读取并处理分区,Offset 则记录消费进度。三者不能混在一起。
消费者先找到 Group Coordinator
消费者使用相同 group.id 加入同一个消费组。客户端先找到负责这个组的 Coordinator,再完成成员注册和协议协商。
Coordinator 不是业务消息的转发节点,它主要维护组成员、会话状态和分区分配过程。
心跳维持成员存活
消费者持续发送心跳。成员超时、主动离开、订阅主题变化、分区变化或协议切换,都可能触发新的分配过程。
处理逻辑长时间阻塞、频繁 Full GC 或网络抖动,都可能让 Coordinator 判断成员失效,造成分区所有权转移。
同组内一个分区只交给一个消费者
分区分配策略决定哪些消费者获得哪些分区。如果消费者数量超过分区数,多出来的消费者不会提高吞吐,只会空闲。
分区被重新分配前后,要正确处理停止拉取、完成在途任务、提交安全进度和初始化新分区状态。

Offset 与成员协调是独立概念
Offset 表示消费组处理到哪个位置。分区分给谁,与进度提交到哪里,是两件不同的事。
提交过早可能丢业务处理,提交过晚可能重复消费。因此要根据“拉取、处理、落库、提交”的事务边界设计幂等和恢复策略。
Kafka 4.x 需要区分两套协议
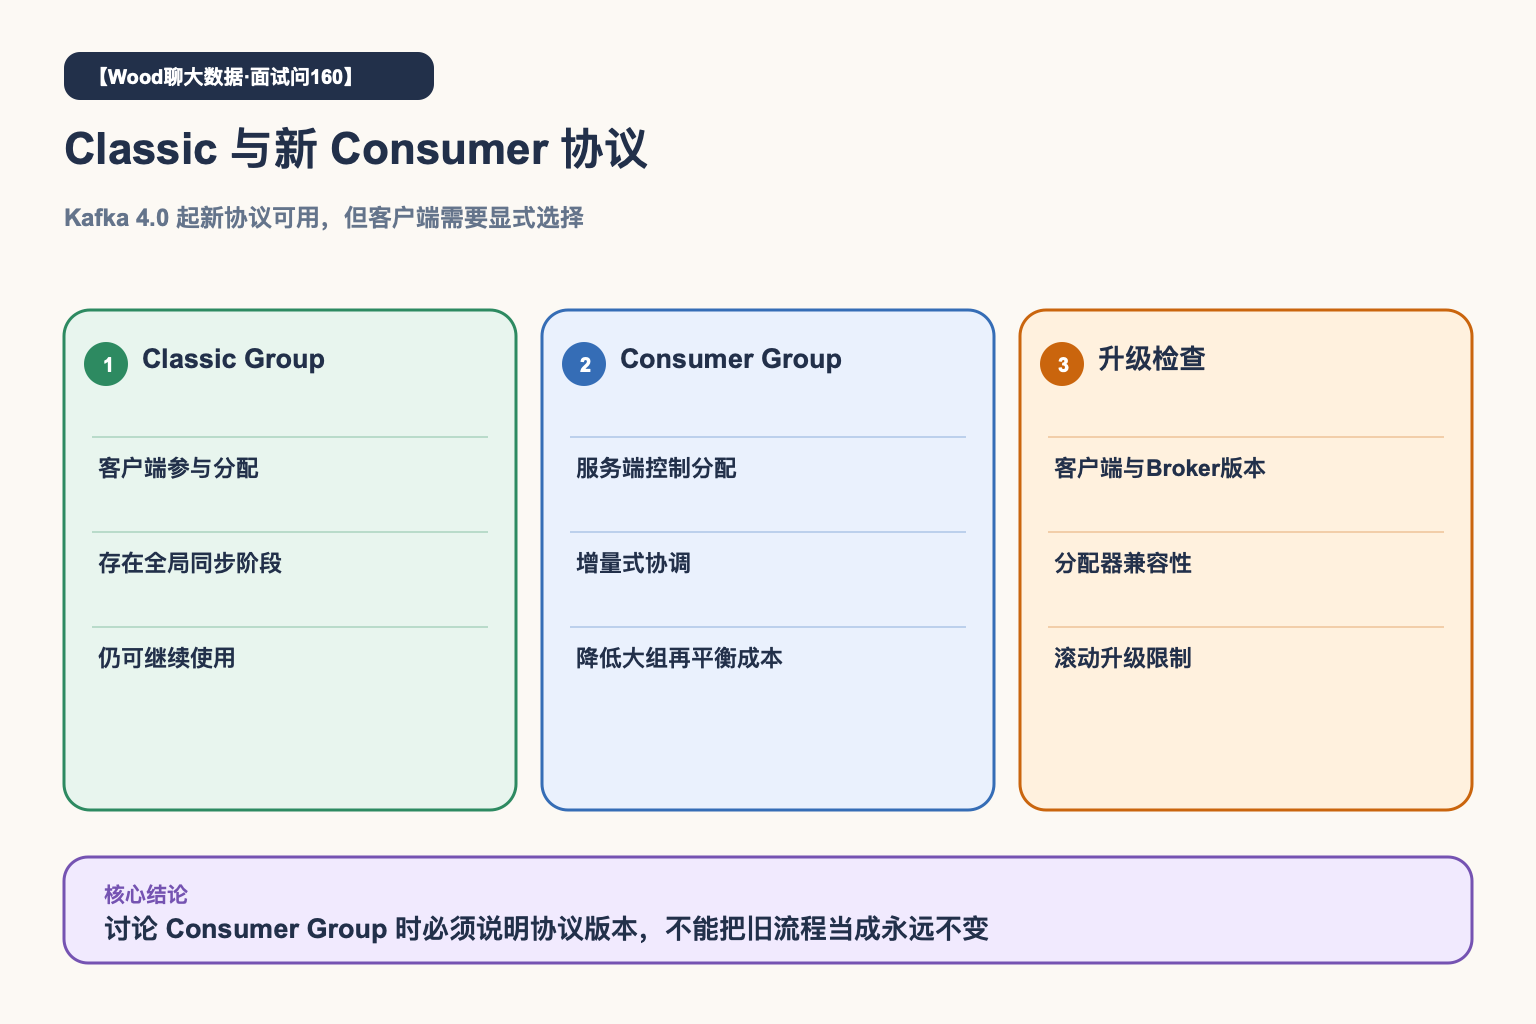
Kafka 4.0 起,新 Consumer Rebalance Protocol 已可用。官方文档把使用新协议的称为 Consumer Group,把旧协议称为 Classic Group。
新协议采用服务端分配和增量式协调,减少全局同步带来的再平衡成本;Classic 协议仍然可以使用。客户端需要通过 group.protocol 选择新协议,具体升级要核对客户端、Broker 和分配器兼容性。
一个典型场景
消费任务偶发重复数据,最初只检查 Offset 提交配置。继续排查发现,业务处理超过允许的轮询间隔,消费者被移出组,分区转交给其他实例,而原实例的外部写入仍在进行。
最终通过缩短单批处理、拆分异步写入、设计幂等键并监控 Rebalance,才解决重复问题。