Kafka 消息没有 Key 会怎么分区?默认策略是每条轮询吗?
本文目录
面试怎么回答
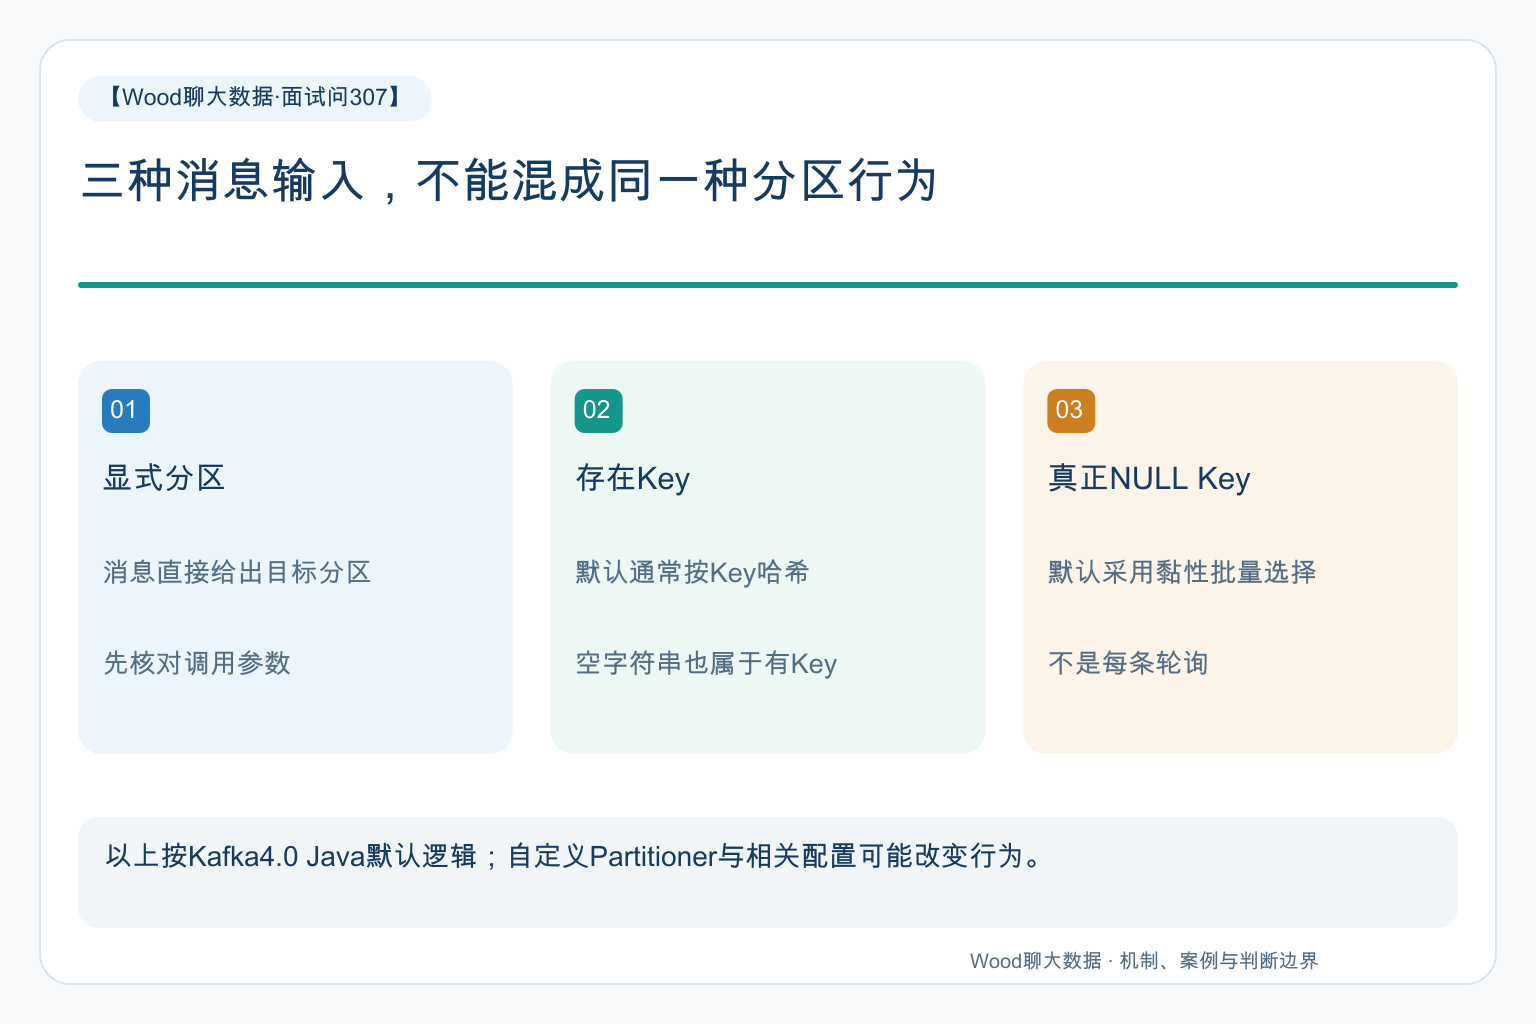
我会先核对客户端版本、显式分区和partitioner配置。以Kafka4.0 Java生产者默认逻辑为例,没有指定分区且有Key时通常按Key哈希;无Key则使用黏性批量选择,不是逐条轮询。空字符串Key仍然是有Key,不能当NULL。需要同业务对象有序时应使用稳定业务Key,并考虑扩分区与重试边界;只看几条消息的分布不足以判断长期负载是否异常。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
测试只发送几条没有Key的消息,它们都进了同一个分区。开发马上判断:“Kafka负载均衡坏了。”但对较新的默认生产者逻辑来说,短时间集中到一个分区,可能正是为了形成有效批次,而不是每一条都换分区。
无Key的默认分区行为要看客户端版本与配置;黏性批量选择不是逐条轮询,也不保证同一业务对象有序。
先看有没有绕过默认逻辑
如果消息明确指定了目标分区,讨论默认无Key策略就已经不在同一前提下。自定义Partitioner和忽略Key的配置,也可能改变行为。
还要确认使用的是哪个语言客户端及版本。不同客户端实现和历史版本不一定完全一致,不能把某篇旧面试笔记里的“轮询”当成所有版本的固定答案。
下面按Kafka 4.0 Java生产者文档解释默认逻辑,不把它泛化到所有客户端。
NULL Key与空字符串Key不同
没有指定分区但Key存在时,默认逻辑通常根据序列化后的Key哈希选择分区;相同字节Key在相同分区布局下会获得稳定路由。
空字符串序列化后仍然是一个存在的Key,许多消息都使用空字符串,就可能集中到同一个分区。它不是“没有Key”的另一种写法。
业务对象Key也应规范编码和序列化方式。一个客户端用数字字节,另一个用字符串字节,即使人眼看到同一个订单号,分区计算也可能不同。
无Key黏性选择,是为了形成批次
Kafka 4.0文档描述,无分区、无Key时使用黏性分区选择,在向一个分区积累至少相应批次大小的字节后切换目标。
这与每条记录依次轮询不同。批量聚集可以减少许多小批次开销,因此短窗口里看起来不均匀,不一定是异常。
但也不能反过来宣称“只要是黏性,任何长期不均都正常”。应结合实际客户端、配置、字节量、批次数和Broker情况观察,判断是否存在持续热点或异常路径。
一个典型场景:默认空串造成长期热点
比如上游框架把缺失订单号统一填成空字符串,再作为消息Key发送。所有异常记录持续进入同一个分区,下游出现明显积压。
最初认为无Key黏性分区不均,准备替换为轮询。抓取实际序列化Key后发现,它不是NULL,而是相同空串;走的是有Key哈希逻辑。
旧测试只验证业务字段为空,没有核对ProducerRecord实际Key,因而把消息内容缺值与消息Key不存在混为一谈。
修复应明确异常记录去向,必要时隔离到专门处理流程。不能为了打散就随机补Key,同时又期待同一业务对象的变更保持顺序。
吞吐分布与业务有序,是两个目标
无Key消息无法依据业务对象稳定路由。同一订单的不同事件可能进入不同分区,消费者不能仅凭分区内有序推导订单整体有序。
如果订单状态需要顺序,通常应使用稳定订单Key,并结合源端版本处理迟到与重试。增加分区后,哈希映射也可能改变,已有历史与新消息的顺序边界需要评估。
使用RoundRobinPartitioner或自定义逻辑时,更要确认是否仍然尊重Key语义。让分布看起来平均,不一定符合状态处理需要。
怎么验证分区策略?
构造明确Key、NULL Key、空串Key和显式分区四组消息,记录客户端版本、实际Key字节与目标分区。
观察足够长的发送区间,同时比较每分区消息数、字节数和批次,而不是只发十条就要求绝对平均。再加入业务热点Key,确认预期的集中路由是否被保留。
这道题最重要的不是背“哈希还是轮询”,而是说清前提、版本和业务顺序之间的关系。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。