Kafka 的 Segment 和稀疏索引如何定位消息?
面试怎么回答
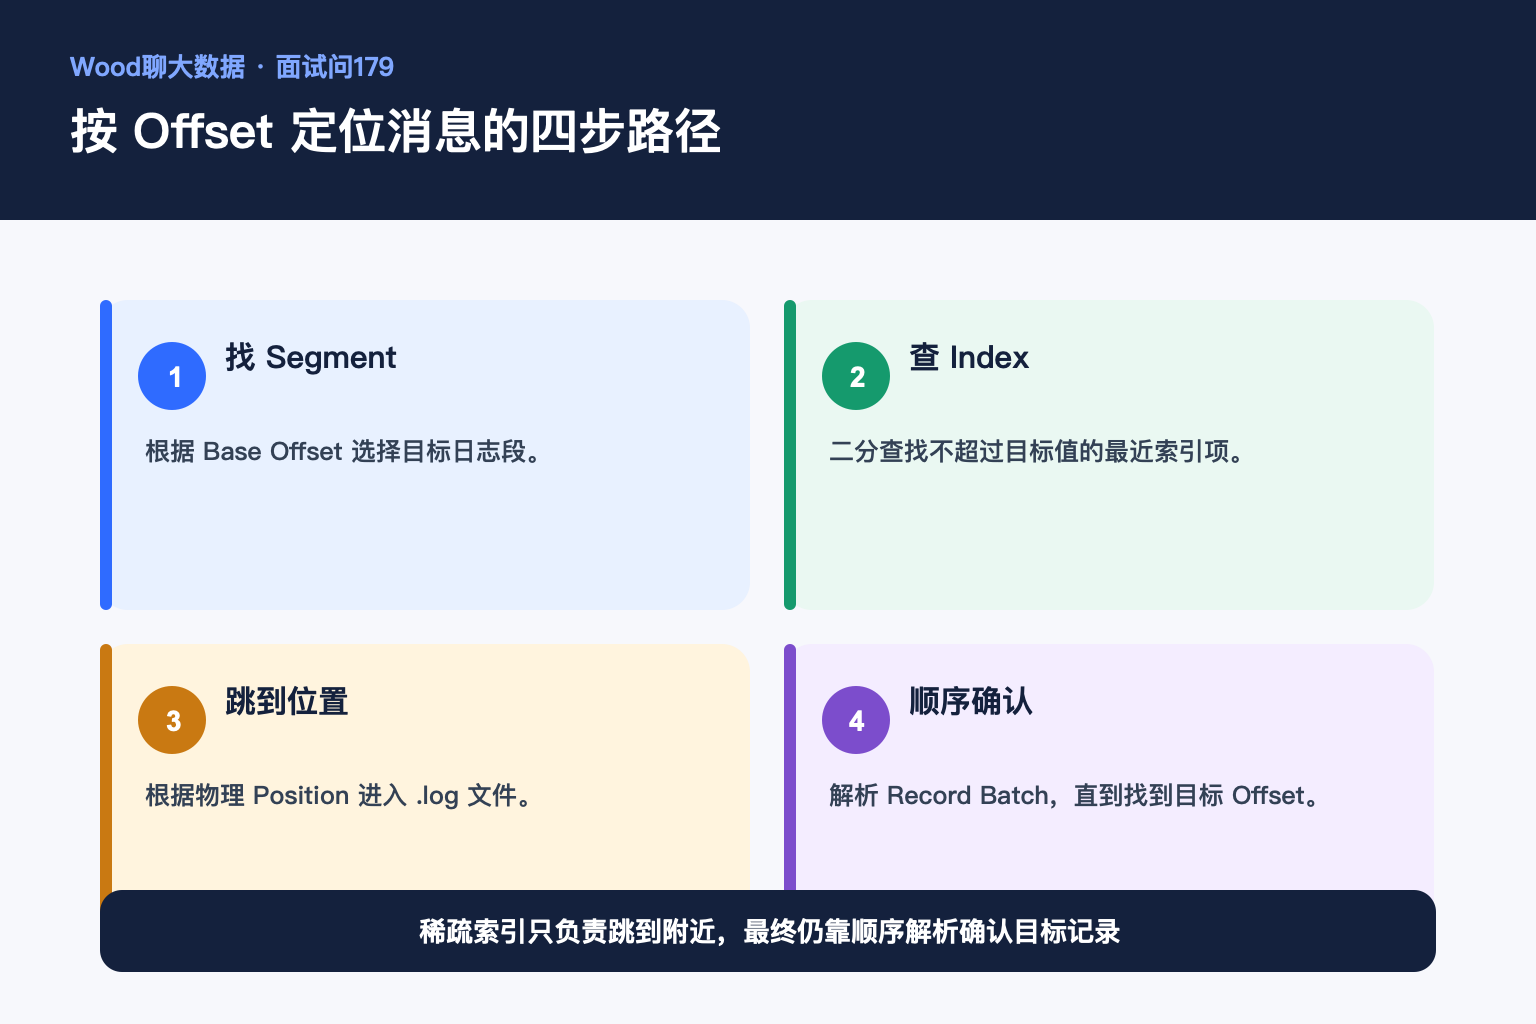
Kafka 将每个 Partition 的追加日志切分为多个 Segment,文件名记录 Base Offset。读取目标 Offset 时先定位所属 Segment,再通过稀疏 Offset Index 找到最近的相对 Offset 和文件位置,最后在 Log 中顺序扫描到目标消息;Time Index 用于按时间定位附近 Offset。这样索引体积可控,也便于按 Segment 做保留和清理。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一个 Kafka 分区可以有上亿条消息,按 Offset 查找为什么不需要从头扫描?
答案不只是顺序写,而是日志分段和稀疏索引共同缩小了搜索范围。
Kafka 把分区日志切成多个 Segment,再用稀疏 Offset Index 和 Time Index 缩小定位范围,最后顺序扫描目标记录。
为什么要把分区日志切成 Segment
一个 Partition 本质上是按 Offset 追加的日志。若始终写一个巨大文件,索引、恢复、删除和 Compaction 都难以管理。Kafka 按大小或时间滚动生成 Segment,只有 Active Segment 持续写入,旧 Segment 变为只读并可按文件粒度清理。
Segment 文件名提供第一层定位
每个 Segment 以该段第一条消息的 Base Offset 命名。查找目标 Offset 时,可以先根据这些 Base Offset 找到不大于目标值的最大 Segment,从而把搜索范围缩小到一个日志段。
Offset Index 为什么是稀疏的
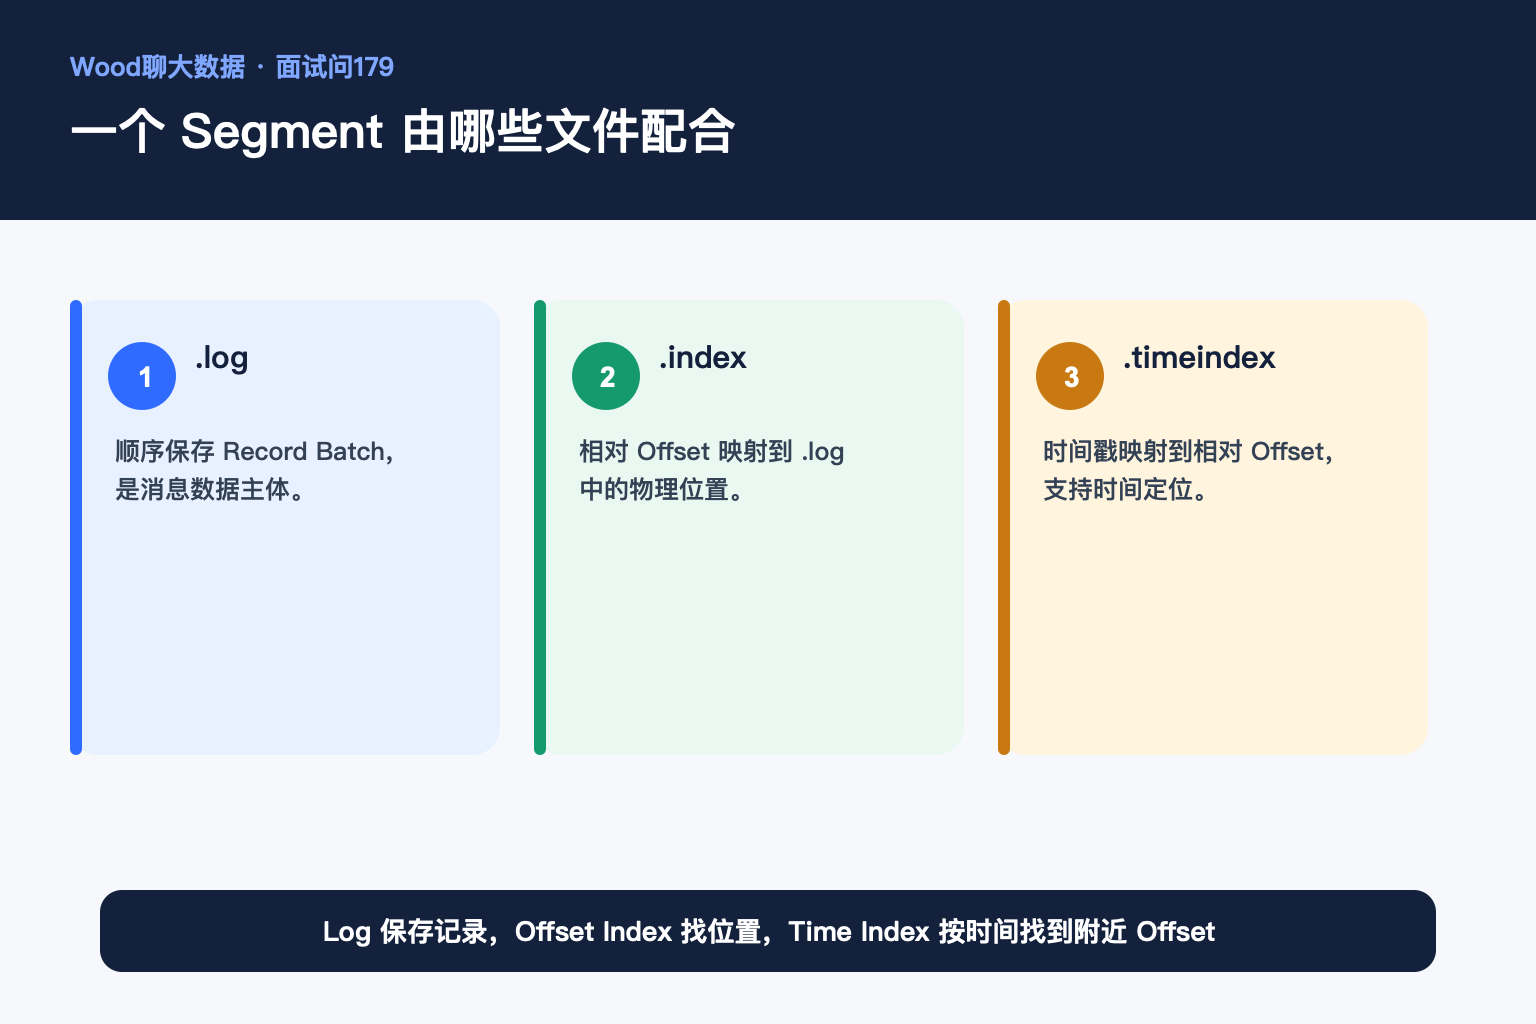
Offset Index 不为每条消息建立索引,而是按一定字节间隔记录相对 Offset 到 Log 文件物理位置的映射。找到最接近且不超过目标 Offset 的索引项后,从对应位置顺序解析 Record Batch,直到目标记录。稀疏索引更小、更容易进入页缓存。
Time Index 和滚动策略各管什么
Time Index 把时间戳映射到相对 Offset,支持按时间查找附近位置;segment.bytes 和 segment.ms 控制日志滚动。Segment 太大,删除粒度和恢复扫描变粗;太小则文件、句柄和索引数量增加。通常不应脱离吞吐与保留策略随意修改默认值。
一个典型场景
消费者按时间重置 Offset。Kafka 先通过 Time Index 找到接近目标时间的 Offset,再通过 Segment 与 Offset Index 定位日志位置。最终仍要解析附近消息确认时间,因此它是分层缩小范围,而不是一张精确到每条消息的全量索引。
参考资料
- Apache Kafka Topic Configs:https://kafka.apache.org/42/configuration/topic-configs/