Kafka 压缩算法怎么选?Producer、Broker 和 Consumer 谁负责?
面试怎么回答
Kafka 在 Producer 端按 Record Batch 压缩,Broker 通常保留该批次格式;如果 Topic 强制另一个 codec,Broker 可能需要重压缩;Consumer 拉取后解压。gzip 压缩率高但 CPU 偏重,lz4/snappy 更快,zstd 常见于兼顾压缩率和速度。最终要结合 batch.size、linger、真实消息、CPU、网络和版本做压测。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
打开 Kafka 压缩后,网络流量下来了,Producer CPU 却突然升高。
压缩节省的是批次传输与存储空间,代价由编码位置、算法和批次大小共同决定。
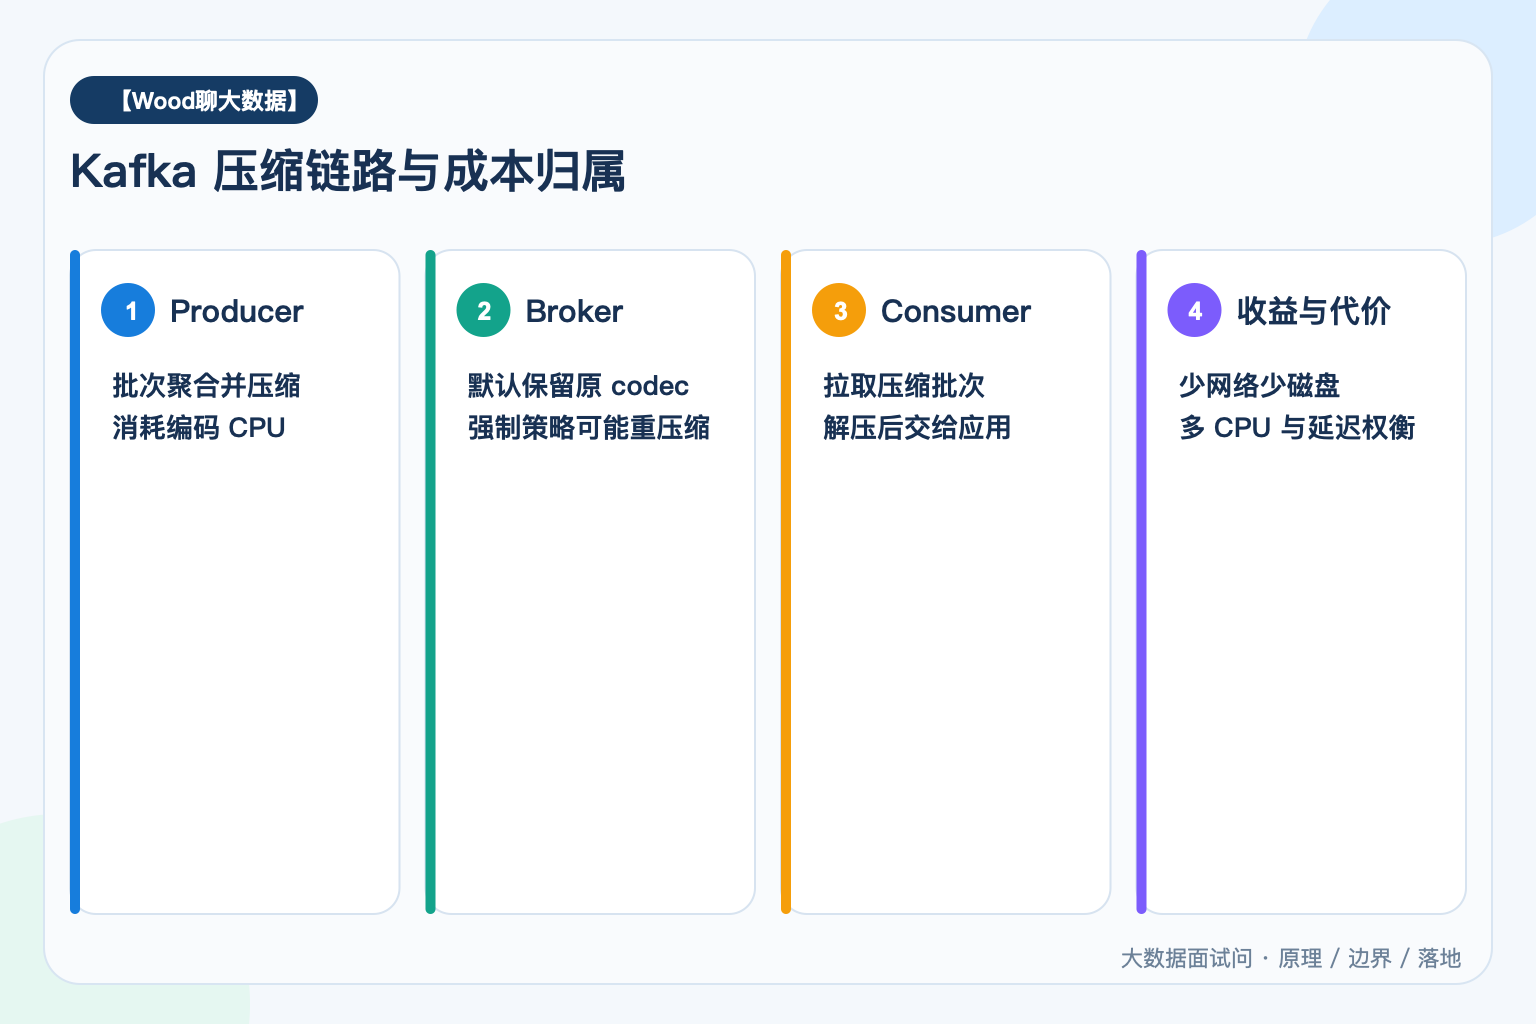
Producer 按 Record Batch 压缩,Broker 通常保留生产者压缩格式或按 Topic 策略重压缩,Consumer 拉取后解压;算法选择是在吞吐、压缩率、CPU 和兼容性间权衡。
Kafka 压缩的是批次,不是单条消息
Producer 会把同一分区的多条记录组成 Record Batch 后压缩,批次内相似内容越多,压缩率通常越好。因此 batch.size 和 linger.ms 不只影响请求次数,也影响压缩效果。单条大消息或批次太小,压缩收益会明显下降。
三端的责任并不对称
Producer 负责选择 codec 并执行压缩;Broker 接收压缩批次,Topic 的 compression.type 为 producer 时保留原格式,若强制指定其他 codec 则可能解压再压缩,增加 Broker CPU;Consumer 拉取批次后负责解压给应用。
算法要按负载测试
gzip 压缩率通常高但 CPU 成本较大;snappy 和 lz4 更偏向低延迟与高速度;zstd 常在压缩率和速度之间取得较好平衡,但要确认客户端与 Broker 版本兼容。不存在所有业务都最优的固定选择。
网络、磁盘和 CPU 要一起看
压缩会减少 Producer 到 Broker、Broker 复制和 Consumer 拉取的字节,也能降低日志存储量;但 Producer 和 Consumer 增加计算,Broker 若发生重压缩也会增加开销。瓶颈在带宽时收益大,瓶颈在 CPU 时可能适得其反。
不要忽略消息上限与观测口径
批次压缩后和单条记录序列化后的大小限制涉及不同配置。排查时同时观察 bytes in/out、record compression ratio、request latency、batch size、CPU 和 Consumer fetch 指标,不能只看 Topic 目录变小。
一个务实的落地方式
从 zstd 或 lz4 做基线压测,保持 Topic 继承 producer,避免 Broker 统一重压缩;用真实消息与批次参数测试吞吐、P99、CPU 和压缩率。若跨语言客户端或旧版本较多,再把兼容性作为硬约束。
参考资料
- Kafka Producer Configs:https://kafka.apache.org/42/configuration/producer-configs/
- Kafka Topic Configs:https://kafka.apache.org/42/configuration/topic-configs/