为什么列式存储更适合分析场景?
面试怎么回答
列式存储适合分析场景,主要因为分析查询通常扫描很多行但只读取少量列。按列组织能做列裁剪、减少无关 I/O;同列类型和值分布相近,更利于字典、RLE、Delta 等编码压缩;Row Group 或 Stripe 的统计信息还能配合谓词下推跳过数据块。但效果仍依赖分区、排序、文件大小和查询模式,频繁单行写入或点查不一定适合列存。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一张表有 100 列,查询只计算日期、渠道和金额 3 列。行式存储往往要把整行相关数据读进来,列式存储则可以优先读取真正需要的列。
这也是 Parquet、ORC 等格式适合分析型工作负载的重要原因。
列式存储通过按列组织数据减少无关 I/O,同列数据类型相近又更容易压缩,再结合统计信息、谓词下推和分区裁剪,降低扫描成本。
列裁剪:只读查询需要的列
分析 SQL 常做大范围扫描,却只选择少量字段:
SELECT channel, SUM(amount)
FROM orders
WHERE dt = '2026-08-29'
GROUP BY channel;
如果文件按列组织,引擎可以跳过用户地址、商品描述等无关列。表越宽、查询列越少,收益通常越明显。
行式存储则更适合按主键获取完整记录,或频繁插入、更新单行的事务场景。不能简单说“列存永远比行存快”,要看访问模式。
压缩:同列数据更相似
同一列通常类型一致、值域有限,适合字典编码、Run-Length Encoding、Delta Encoding 和位打包。压缩后磁盘和网络读取量减少,解码开销有时反而小于读取额外数据的成本。
不同列应允许选择不同编码。低基数字符串适合字典,高度递增数值可能适合 Delta;并不是统一使用最高压缩比就最好,还要平衡 CPU 和读取速度。
统计信息让引擎跳过数据块
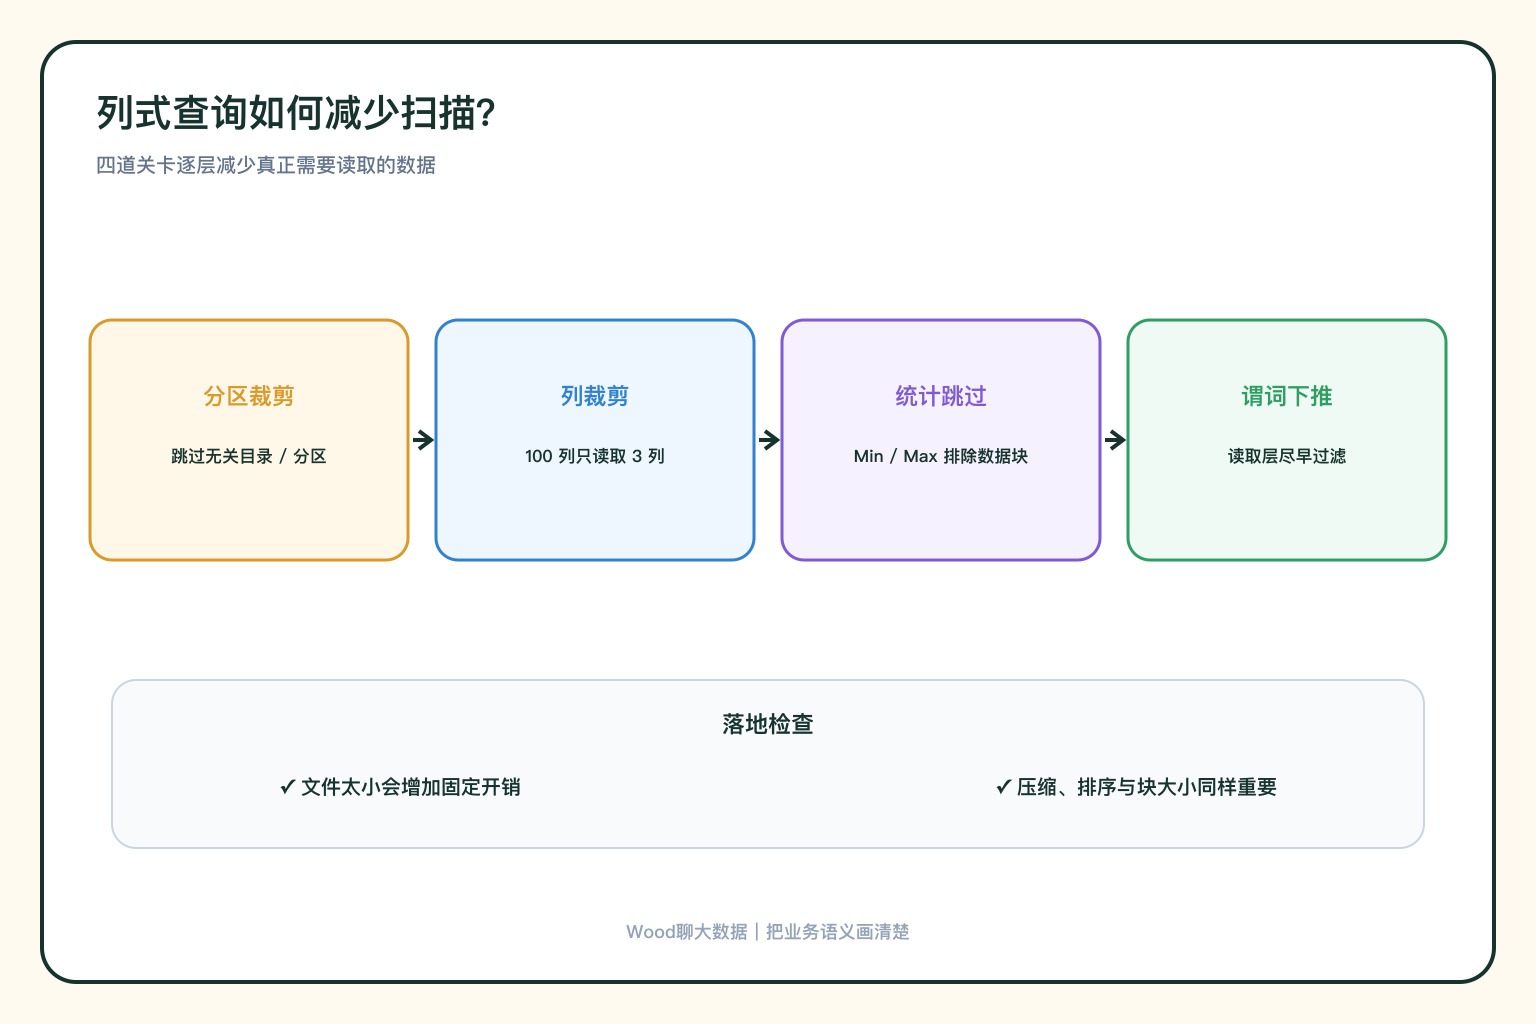
列式文件通常按 Row Group、Stripe 等单元组织,并保存列的最小值、最大值、空值数等统计。查询 amount > 1000 时,如果某个数据块的最大值只有 500,整个块都可以跳过。
谓词下推让过滤条件尽量靠近读取层执行;列裁剪减少列,分区裁剪减少目录或分区,数据块统计再减少文件内部读取。三者不是同一件事,但会叠加产生效果。
为什么小文件会破坏优势?
文件太小,会增加元数据、打开文件、任务调度和 Footer 读取开销;数据块太小,压缩和统计跳过效果也可能下降。文件太大又会影响并行度和重写成本。
因此列式格式仍需要合理的文件大小、排序、分区和 Compaction。把数据保存为 Parquet,不代表查询自然就快。
什么时候不适合?
高频单行更新、低延迟点查、每次都读取完整记录时,行式或 Key-Value 存储通常更合适。很多系统采用组合:事务库用行存承接写入,CDC 或 ETL 后进入列式分析存储。