Iceberg Schema Evolution 为什么依赖 Field ID?
本文目录
面试怎么回答
Iceberg 不用列名或位置作为字段身份,而给每个字段分配永不复用的 Field ID。重命名和重排只改变展示方式,读取历史文件仍按 ID 投影;删除字段后新增同名列必须使用新 ID,避免误读旧值。Struct、List 和 Map 的嵌套元素也有独立 ID。导入没有 ID 的旧文件可用 name mapping 兼容,但 Schema Evolution 仍要遵守类型提升、默认值和引擎支持边界。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一张表把列 a 重命名为 customer_id,又新建了一列叫 a。如果系统只按列名或位置读旧文件,历史数据很可能被映射到错误字段。
Iceberg 给每个字段分配永不复用的 Field ID,就是为了让“字段身份”不随名称和顺序变化。
Iceberg 以永不复用的 Field ID 识别字段,使重命名、重排、增删列无需重写历史文件;读取投影、嵌套类型和兼容导入都围绕 ID 解析。
列名和列位置都不是稳定身份
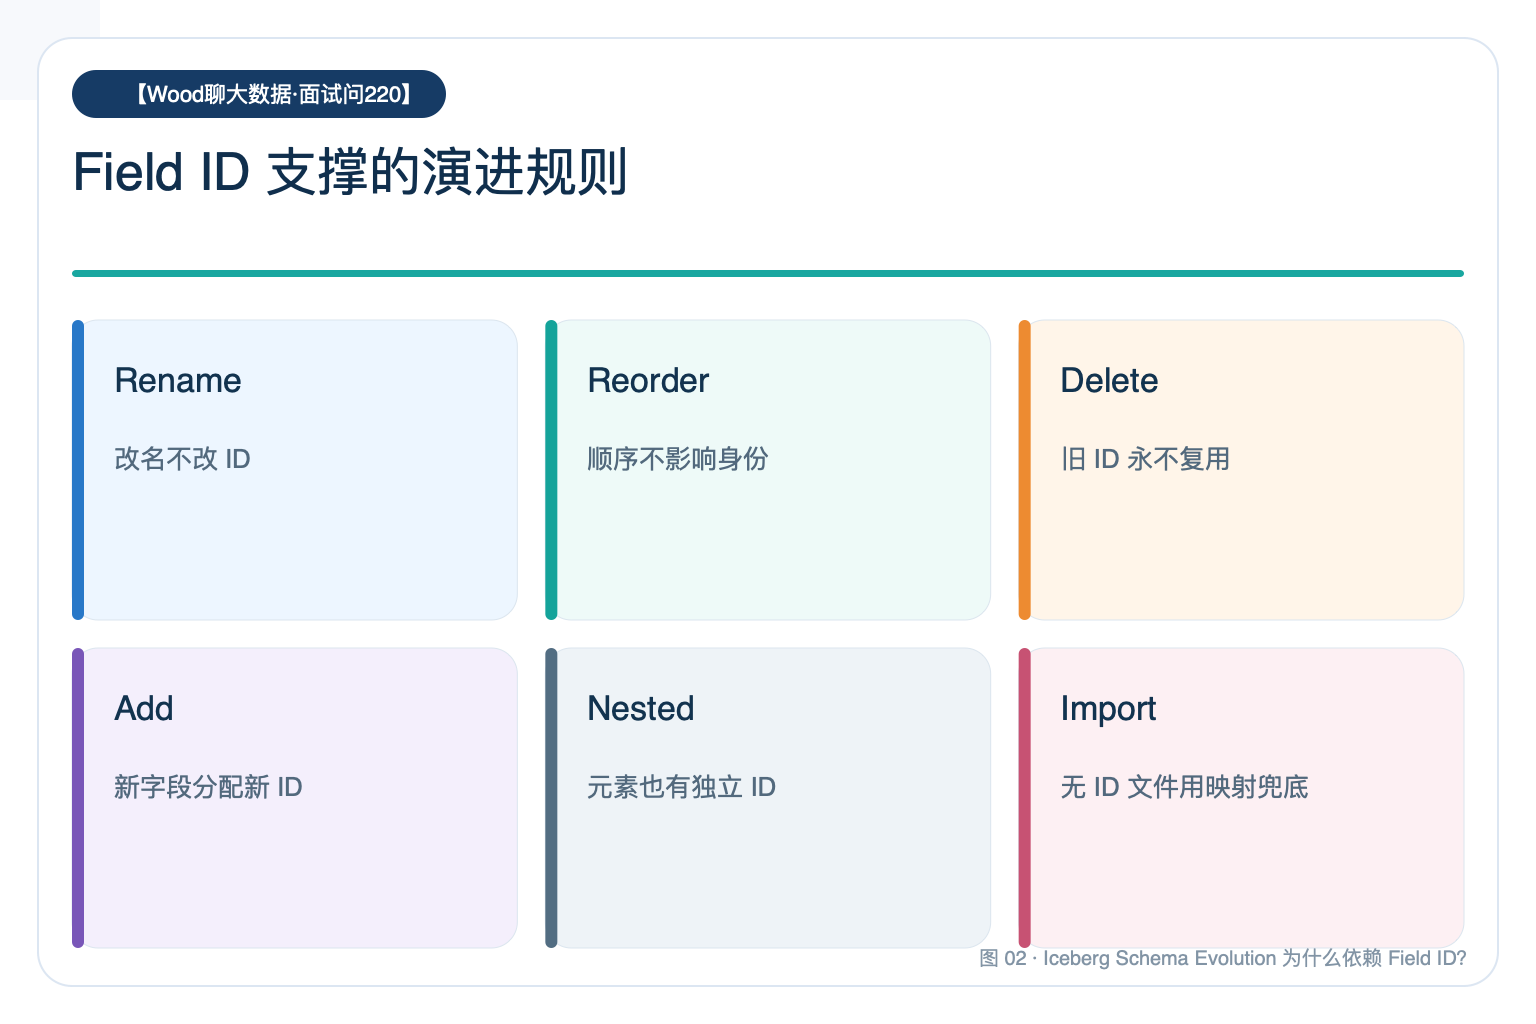
名称会重命名,顺序会调整;如果按位置映射,交换两列就可能读错值;如果只按名称映射,删除后再创建同名列又可能误读历史字段。Field ID 把显示名称与逻辑身份分离。
重命名只改名称不改 ID
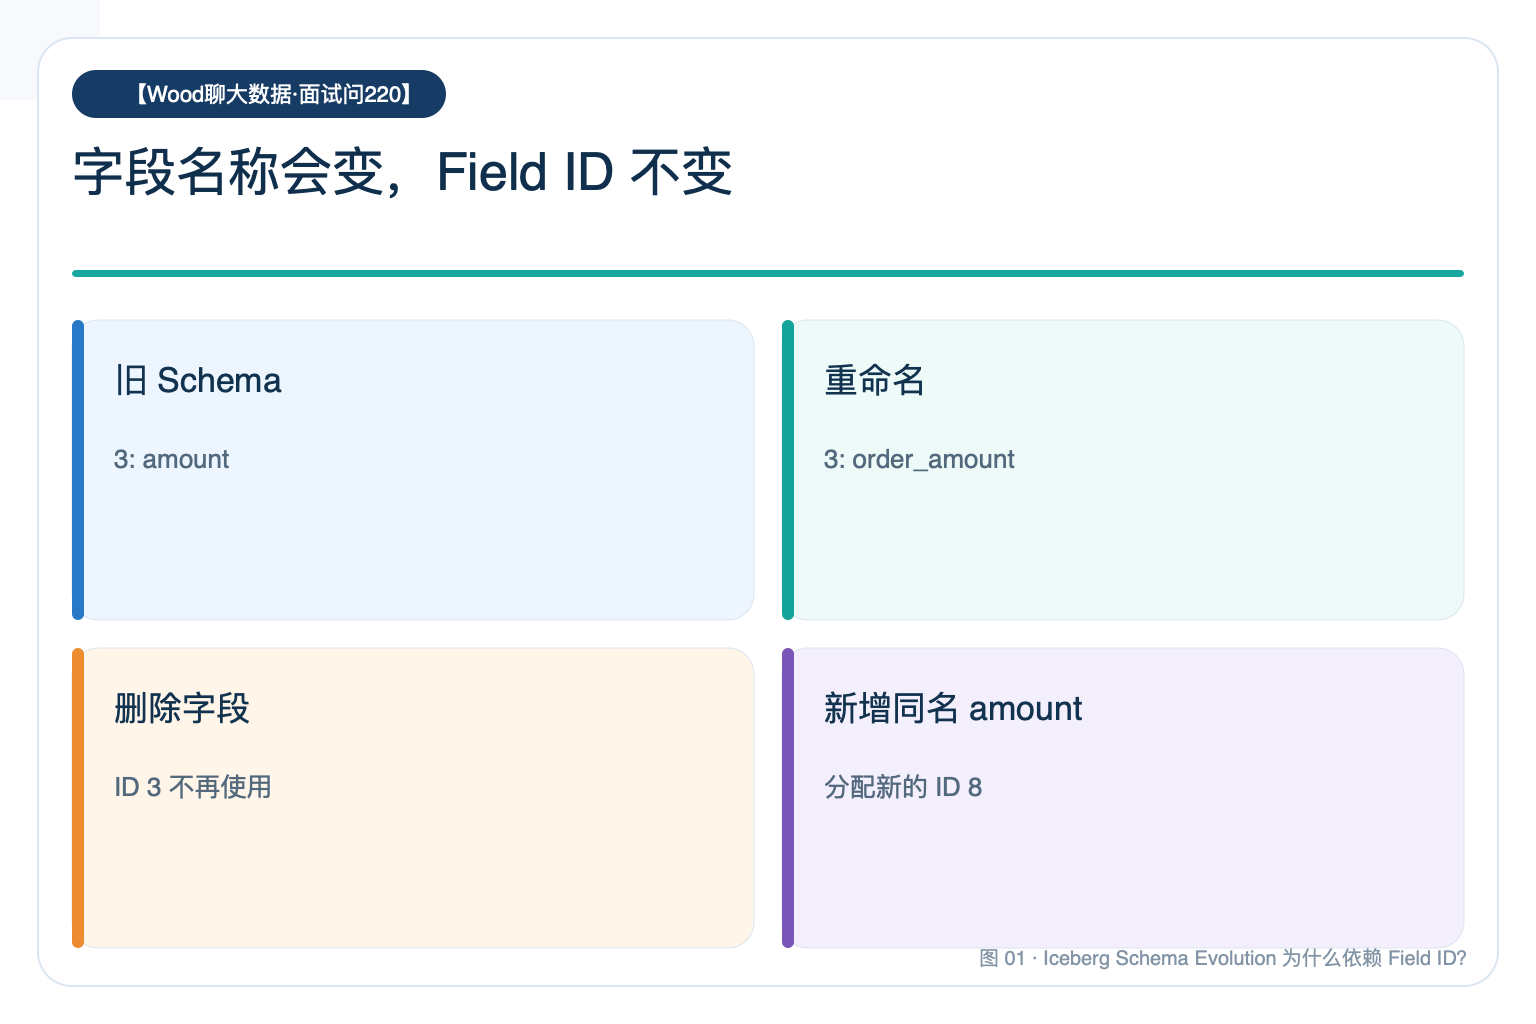
假设 id=3 的字段从 amount 改为 order_amount,历史文件仍保存字段 3,读取器按 ID 投影到新名称。因此无需重写全部旧文件,也不会把它当成“删除旧列再新增一列”。
删除后的 ID 不能复用
删除字段只是把它从当前 Schema 移除,旧数据文件里仍可能存在该 ID。以后新增同名字段必须分配新 ID,这样读取旧文件时新字段返回默认值或 NULL,而不是继承已删除字段的历史值。
嵌套类型同样需要独立 ID
Struct 字段、List 的 element、Map 的 key 和 value 都有自己的 ID。这样嵌套字段重排或改名时仍能精确投影,而不是因为复杂结构内部顺序变化而读错。
旧文件没有 ID 时需要 Name Mapping
迁移已有 Parquet、ORC 或 Avro 文件时,文件可能没有 Iceberg Field ID。表可提供 name mapping 作为兼容映射,但它是导入兜底;后续规范写入仍应把 ID 正确写入文件 Schema。
Schema Evolution 仍有兼容边界
Iceberg 支持新增、删除、重命名、重排和部分类型提升,但不是任意类型转换都安全。变更前要检查引擎支持、读写版本、默认值和下游契约;Field ID 解决身份问题,不会自动解决业务语义变化。
参考资料
- Apache Iceberg:Table Spec - Schema Evolution and Column Projection:https://iceberg.apache.org/spec/#schema-evolution
- Apache Iceberg:Schemas:https://iceberg.apache.org/docs/latest/schemas/