Parquet Row Group 越大越好吗?文件大小和读取并行度怎么权衡?
面试怎么回答
我会区分文件、Row Group和Page。大文件能减少部分元数据和请求开销,但Row Group大小还影响列块读取、统计跳过和写入缓冲。较小行组可能提升选择性读取的细粒度,也增加元数据与调度成本;较大行组有顺序读取优势,但要关注内存和剪枝效果。最终结合排序分布、查询列、过滤条件与实际引擎任务切分做对照测试,不给一个通用最优值。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
把一堆 Parquet 小文件合成大文件后,目录看起来清爽了,某些查询却更慢。有人继续建议把 Row Group 调大。先别急:文件变少解决的是一种开销,行组怎么布局影响的又是另一组取舍。
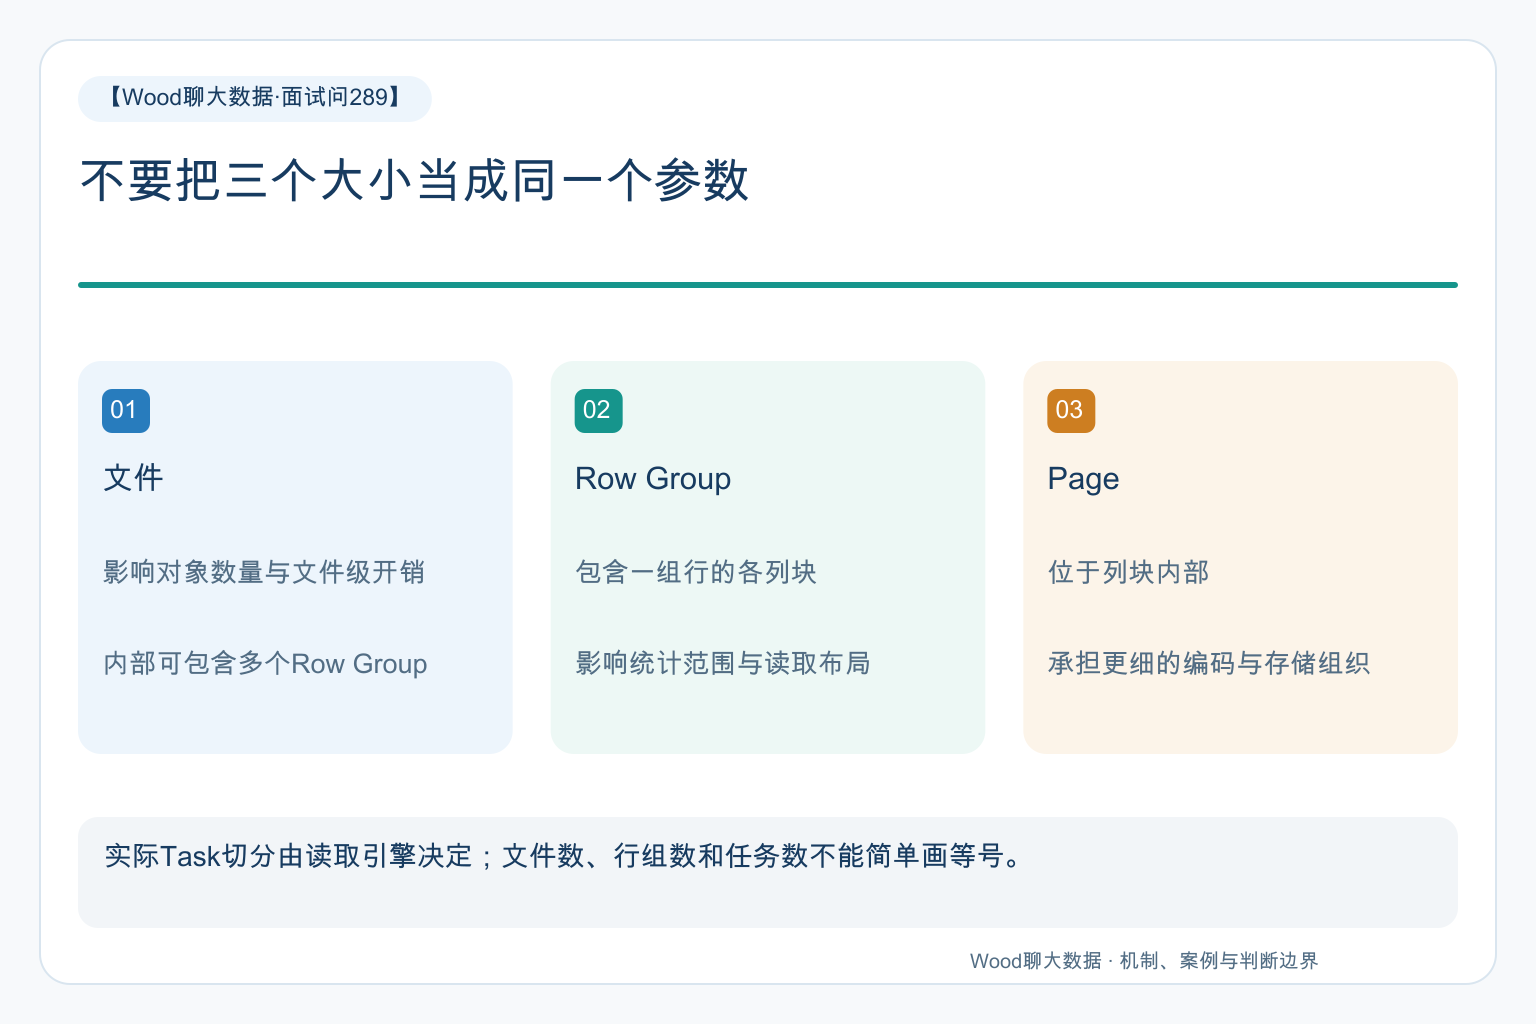
文件、Row Group和Page属于不同层级;布局应同时权衡元数据开销、跳读粒度、写入内存与引擎读取任务。
文件大,不代表里面只有一个读取单元
Parquet 文件内部按 Row Group 组织行,每个行组又包含各列的 Column Chunk,列块内部再分成 Page。
读少数列时,读者可以依据元数据定位需要的列块,而不必按行格式把每一列都完整读取。行组是这种布局的重要边界,但它不是操作系统文件,也不是HDFS Block。
因此讨论“调成几百MB”前,要说清这个大小指文件、目标行组缓冲,还是最终压缩后的实际字节。把三个口径混用,参数和验收就无法对应。
大行组与小行组,各自减少什么?
较大的行组可以提供较长的顺序读写区间,但写入侧也需要关注缓冲和内存压力。官方配置建议是设计参考,不是对所有云存储和执行引擎的最优承诺。
较小行组让统计信息拥有更细的覆盖范围。在数据有合适排序、过滤条件可利用统计信息时,可能跳过更多无关区间。
代价是行组和列块数量增加,元数据变多,读取与管理也更碎。若查询本来就要扫描大部分记录,小粒度未必换来收益。
跳读有效,首先要有可跳过的数据分布
假设每个行组的时间范围都覆盖整个月,查询某一天时,即使行组不大,时间最小最大值也可能都与条件相交,无法排除它们。
相反,按时间聚集的数据可能让行组边界与时间范围更接近,过滤一天只涉及一部分行组。这里改善来自数据排列和统计信息共同作用,不只是改变一个大小参数。
列类型、空值、统计信息是否存在,以及读取器是否支持对应优化,也要核对。不能看到文件格式叫Parquet,就承诺任何表达式都能下推和跳过。
一个典型场景:文件数量下降,选择性查询却回退
比如原表按日期有较好的聚集性,合并时把多天数据打散后重新写入大行组。目录中文件数下降,任务启动更快,但按一天过滤的报表扫描量反而上升。
最初怀疑缓存失效,继续增大计算资源;检查行组时间范围后发现,更多行组同时覆盖多个日期,原本能排除的部分现在必须读取。
旧验收只统计文件数和总存储量,没有保留过滤查询的扫描字节与延迟。修复应重新考虑分区和排序布局,再在真实查询集合上比较,而不是只追求更少的文件。
这并不意味着永远保留小文件。需要同时控制文件级开销与行组级读取效率,两者是可以分别设计的。
读取并行度还取决于引擎
一个文件可以包含多个行组,但是否拆成多个任务、是否合并多个行组读取,取决于引擎、读取器与切分策略。
所以“只有十个文件,最多十个任务”以及“有一千个行组,就会有一千个任务”都不适合作为通用结论。应查看实际执行计划、任务数和每个任务读取的范围。
测试可以固定数据量、列投影和过滤条件,对比几种布局,记录冷读与热读、扫描字节、请求数、任务长尾、写入峰值内存和压缩后大小。
至少包含全表聚合、少数列扫描和高选择性日期过滤。只跑一条全量COUNT,无法代表日常查询;只跑一个命中缓存的小查询,也无法证明存储布局优化成立。
面试里讲清楚“哪个层级解决哪种开销”,比报出一个脱离引擎与数据分布的万能行组大小更可靠。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。