Iceberg Position Delete 和 Equality Delete 有什么区别?
本文目录
面试怎么回答
Position Delete 用文件路径和行位置精确标记删除,通常需要写入端先定位目标行,读取应用更直接;Equality Delete 按主键等字段值删除,不必先找文件,适合 CDC,但读取需要做等值匹配,积累后读放大更明显。两者都受分区和 sequence number 约束,并需要定期重写数据文件合并删除。Iceberg V3 还引入了 Deletion Vector。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同样是删除 id=100 的一行,Iceberg 可以记住“某个文件的第 57 行已删除”,也可以记住“所有 id=100 的旧记录都删除”。
这就是 Position Delete 与 Equality Delete:一个绑定物理位置,一个按字段值匹配,写入成本、读取成本和适用场景都不同。
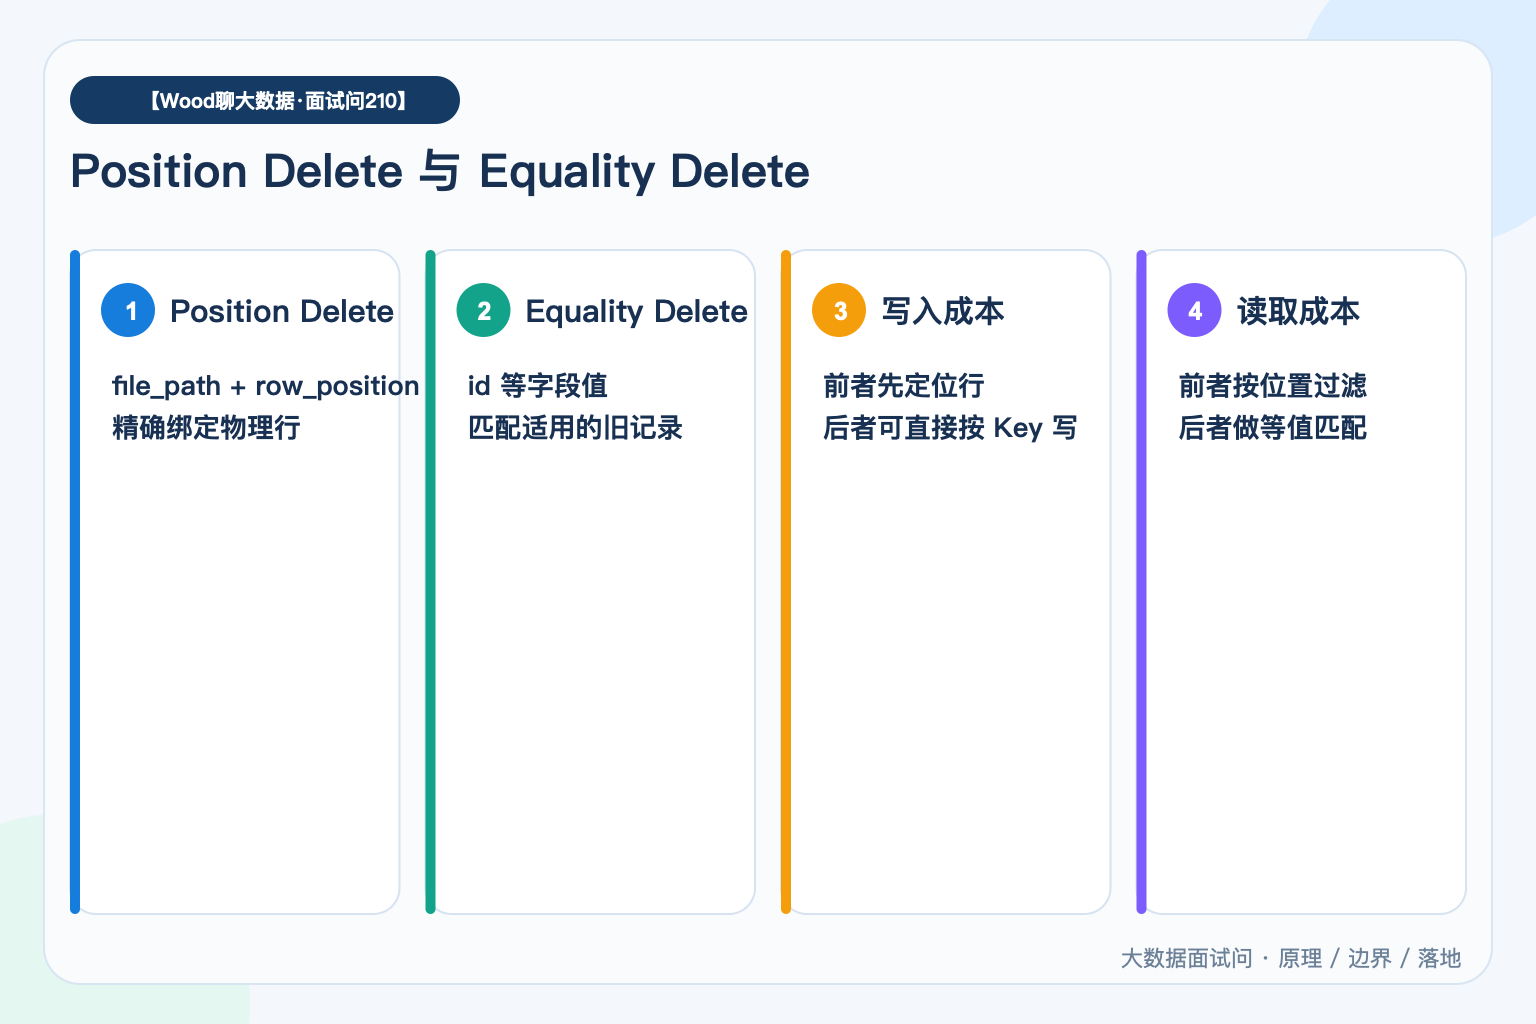
Position Delete 按文件路径和行位置精确删除,Equality Delete 按字段值匹配旧数据;前者读前要定位行,后者写入更灵活但读取匹配更重,V3 还引入 Deletion Vector。
Position Delete 绑定物理位置
它记录 data_file_path 和 row_position,精确指出哪个数据文件的哪一行不可见。适合写任务已经扫描到目标文件和行位置的 Copy-on-Write 或 Merge-on-Read 更新。读取时只需把对应位置过滤掉。
Equality Delete 按字段值匹配
它保存一个或多个 equality field,例如 id=100。读取旧数据文件时,只要这些字段值相等,就视为被删除。写入端不必先知道记录具体在哪个文件,适合 CDC 按业务主键到达的场景。
两者的成本方向相反
Position Delete 在写入前通常需要定位目标行,写成本更高但应用删除时更直接;Equality Delete 写起来轻,但读取需要按等值字段构建匹配并对候选数据文件应用,删除文件多或基数大时会增加读放大。
Sequence Number 决定作用范围
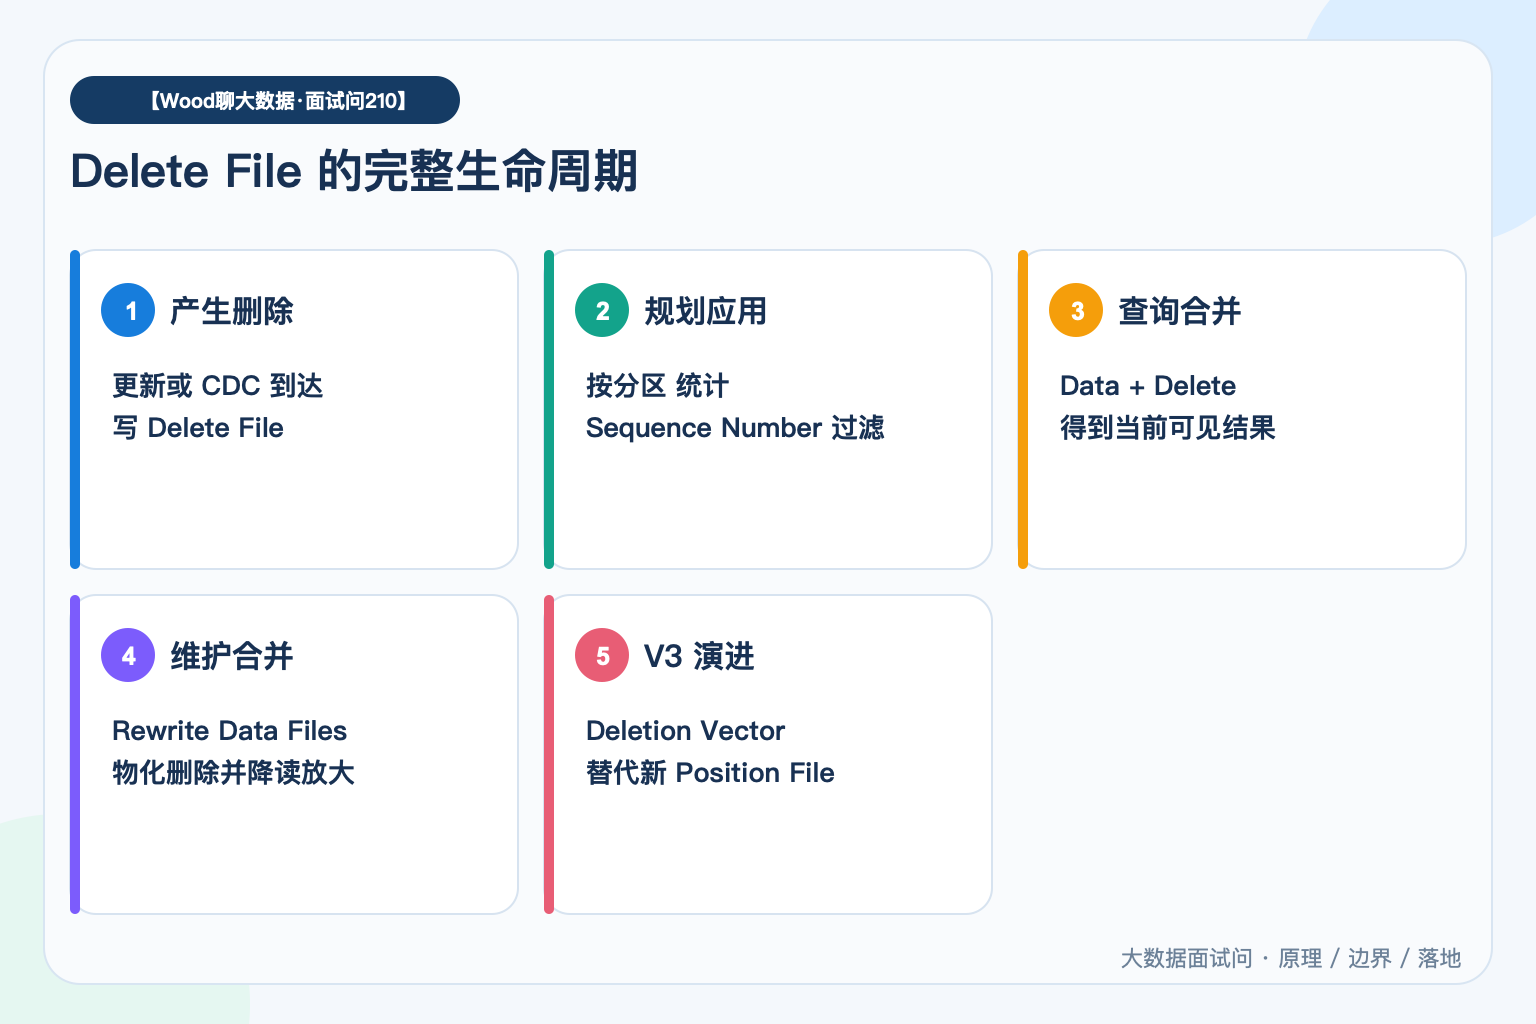
Delete File 不是无条件删除所有历史和未来行。规划器会根据数据与删除文件的 sequence number、分区和值域统计,判断它应作用于哪些旧 Data File。否则同一个主键后来重新插入,也可能被旧删除误伤。
维护任务最终要合并删除
持续更新会积累 Delete File,让每次查询都承担 Merge-on-Read 成本。需要定期 Rewrite Data Files,把删除结果物化进新的 Data File,并清理不再引用的 Delete File。只合并小数据文件,不一定能解决删除文件读放大。
Iceberg V3 还要认识 Deletion Vector
最新规范中,Deletion Vector 用位图记录单个 Data File 的删除位置,执行时比传统 Position Delete File 更紧凑;V3 中 Position Delete File 已被弃用,但已有文件仍可读取。面试回答最好先确认表格式版本与引擎支持。
参考资料
- Apache Iceberg Specification: Row-level Deletes:https://iceberg.apache.org/spec/#row-level-deletes