Iceberg、Hudi 和 Delta Lake 怎么选?
面试怎么回答
我不会只看三者都支持 ACID、Schema Evolution 和 Time Travel。先按主负载选:多引擎批量分析和开放表演进优先评估 Iceberg;CDC 高频 Upsert、增量消费和表服务能力优先评估 Hudi;Spark 或 Databricks 主栈优先评估 Delta。然后用真实 POC 比较并发、查询、维护、故障恢复和团队运维成本。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
湖仓选型最容易得到的答案是:“Iceberg、Hudi、Delta 都支持 ACID,选哪个都差不多。”
真正的差异不在功能清单有没有打勾,而在主写入模式、查询引擎、运维团队和生态约束能否长期匹配。
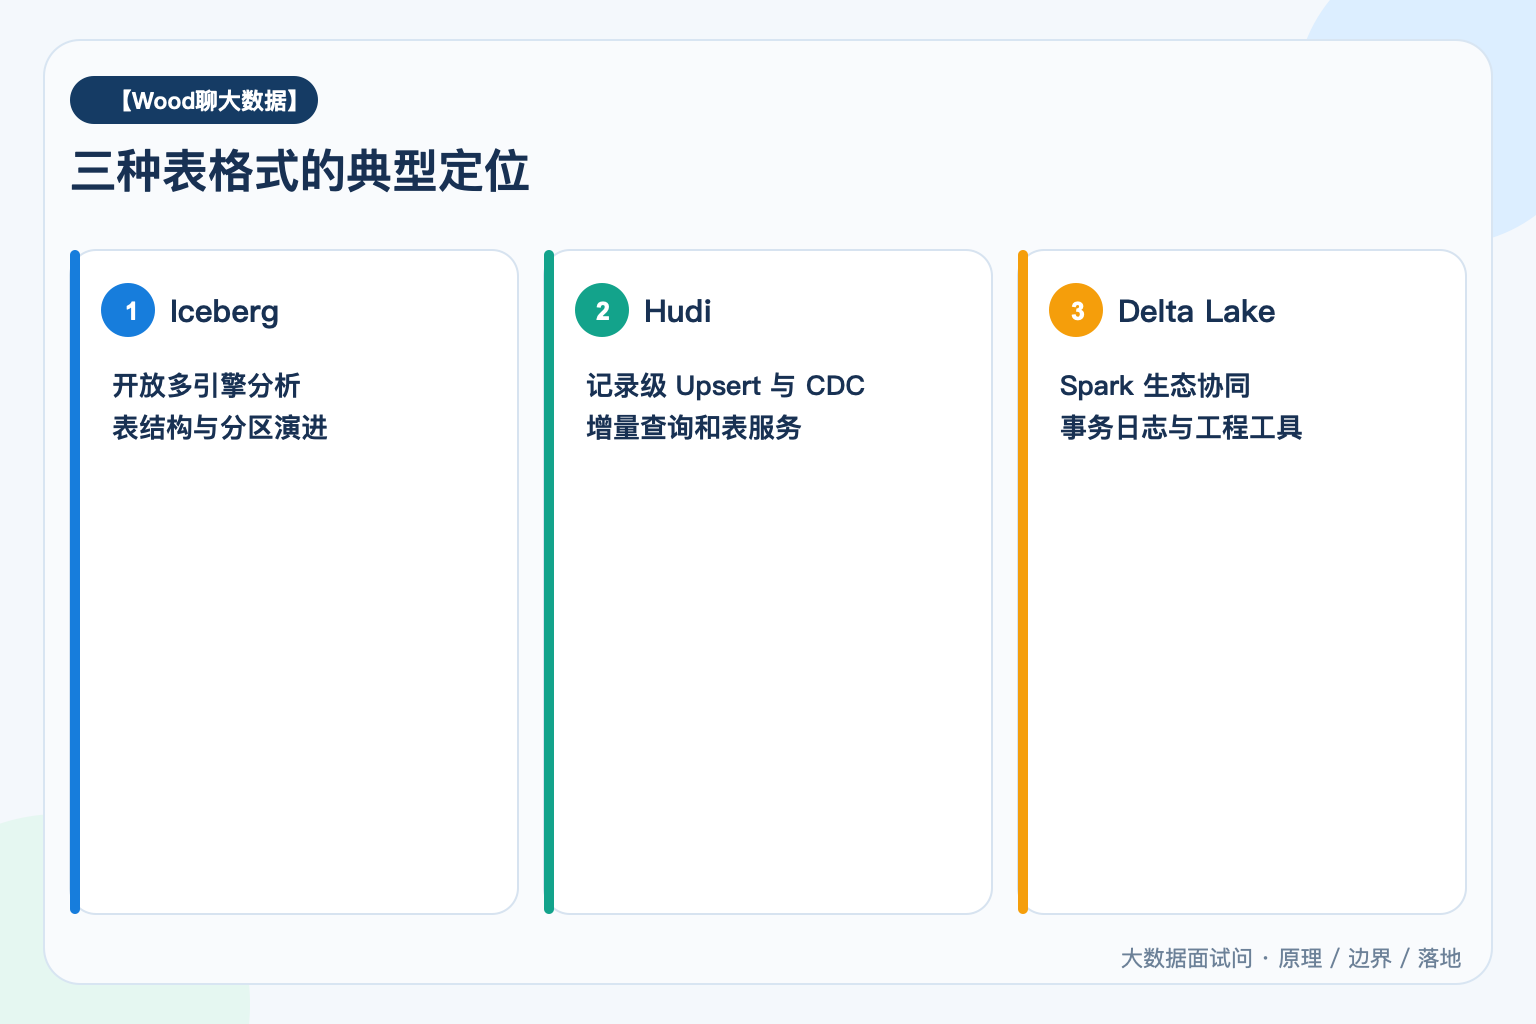
Iceberg 更强调开放的多引擎分析与表演进,Hudi 强调记录级增量写入和表服务,Delta Lake 与 Spark 生态及其事务能力结合紧密;选型应从工作负载和生态约束出发。
先把工作负载说清楚
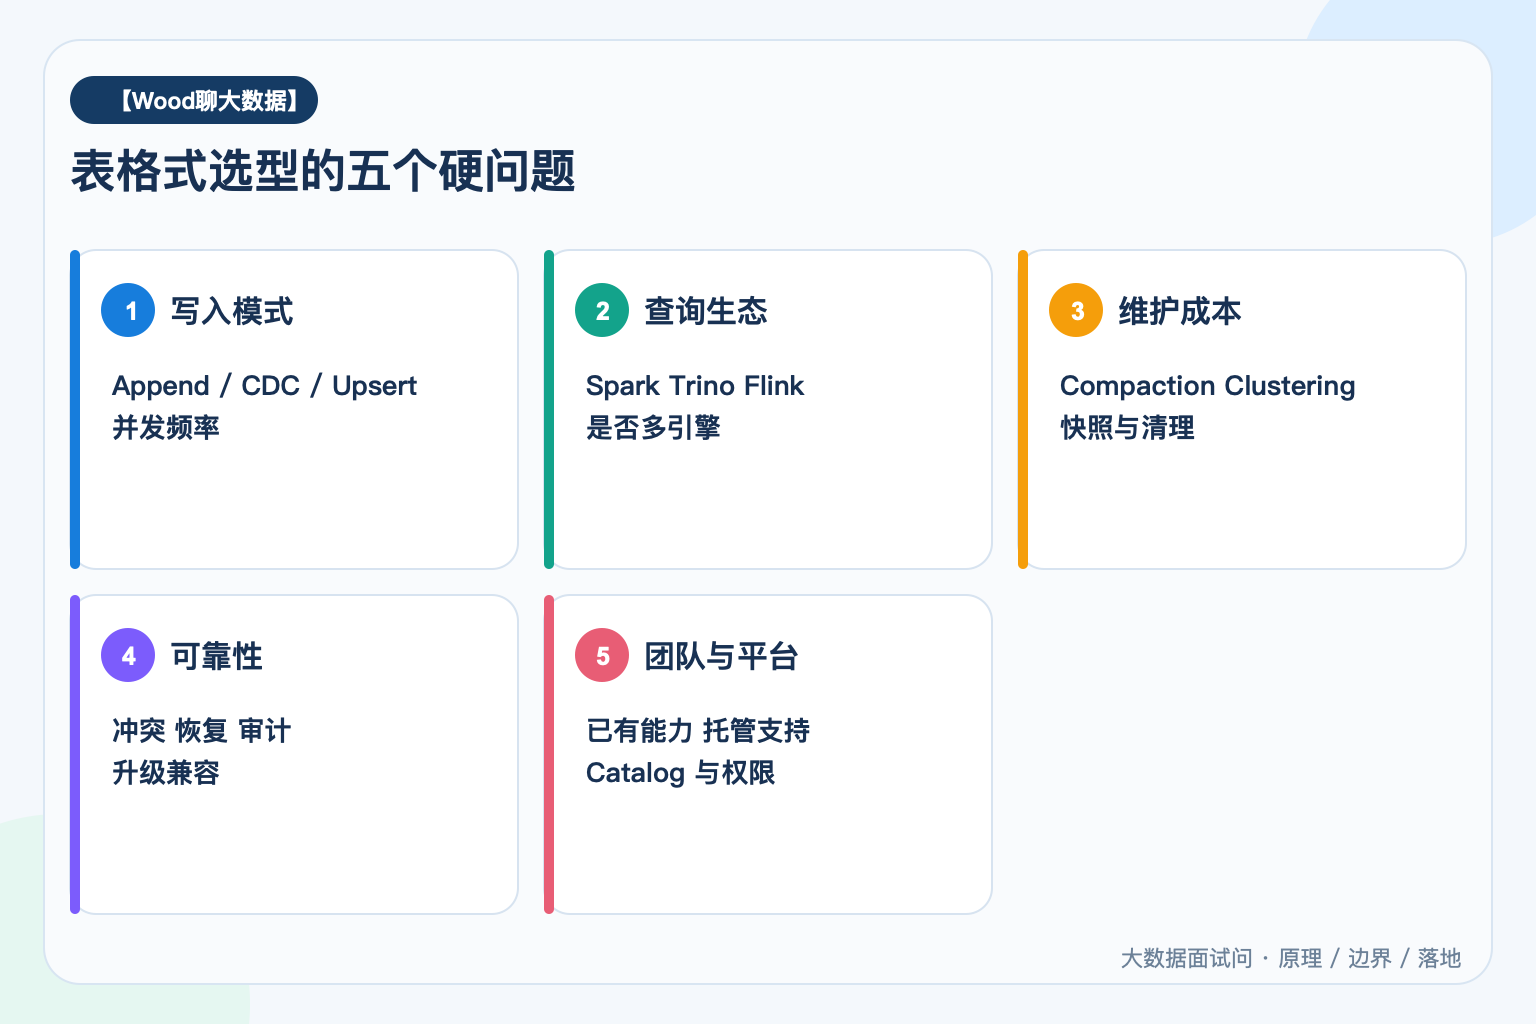
是批量 Append,还是 CDC 高频 Upsert?查询以 Spark 为主,还是 Trino、Flink、Hive 等多引擎并存?是否需要增量消费、行级更新、时间旅行、分支审计和分钟级新鲜度?没有这些输入,任何“谁最好”的结论都不可靠。
Iceberg 的典型优势
Iceberg 通过 Snapshot、Manifest、隐藏分区和 Schema 或 Partition Evolution 构建开放表格式,适合多引擎共享的大规模分析表。它的文件级元数据和并发提交语义清晰,但流式小文件、行级更新和元数据仍需要维护策略。
Hudi 的典型优势
Hudi 围绕记录键、时间线、索引、增量查询以及 Copy-on-Write 与 Merge-on-Read 组织能力,适合 CDC、频繁 Upsert 和需要增量拉取的场景。代价是索引、Compaction、Clustering、Cleaning 等表服务需要更强运维理解。
Delta Lake 的典型优势
Delta 以事务日志连接可靠批流写入,与 Spark 和 Databricks 生态协同成熟,常用能力包括 MERGE、Change Data Feed、OPTIMIZE 与 VACUUM。若团队核心引擎与平台已经围绕该生态,集成成本往往更低;多引擎开放程度仍要按实际版本和连接器验证。
不要只比较功能表
三个项目都在快速演进,同名功能的成熟度、限制和运维方式不同。要用自己的关键链路做 POC:写入吞吐、并发冲突、点更新成本、查询裁剪、小文件治理、故障恢复、引擎兼容和升级路径都应实测。
一个可执行的决策框架
多引擎分析与开放性优先,可重点评估 Iceberg;高频记录级更新和增量处理优先,重点评估 Hudi;Spark 或 Databricks 是绝对主栈,重点评估 Delta。最终还要加上团队经验、云平台托管能力、Catalog、权限和可观测支持,再决定主格式。
参考资料
- Apache Iceberg:https://iceberg.apache.org/docs/latest/
- Apache Hudi Technical Specification:https://hudi.apache.org/learn/tech-specs/
- Delta Lake Documentation:https://docs.delta.io/latest/index.html