物化视图什么时候用?如何设计刷新策略?
面试怎么回答
物化视图适合高频复用、计算昂贵、结构稳定且能接受一定延迟的查询。全量刷新简单可靠但扫描成本高;增量刷新要能捕获新增、更新和删除,并判断受影响分区或聚合。工程上我会定义源数据水位,用影子结果加原子切换保证一致性,失败时保留旧版本,同时监控刷新耗时、新鲜度、数据校验和命中率。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
业务希望复杂报表秒开,又要求源表一有变化就立刻可见。于是团队建了物化视图,却发现“查得快”和“数据新”并不会自动同时成立。
物化视图本质上是用存储、刷新和一致性成本,换取查询阶段少扫描、少 Join、少聚合。
物化视图适合高频、稳定、计算昂贵且允许一定新鲜度延迟的查询;刷新策略要同时设计变化捕获、一致性切换、失败恢复和可观测性。
先判断是否值得物化
高频复用、聚合或 Join 成本高、查询结构相对稳定,是适合物化的信号。如果查询低频、过滤维度变化很大,或基础表更新极其频繁,维护成本可能高于每次现算。先用查询日志和扫描量证明收益。
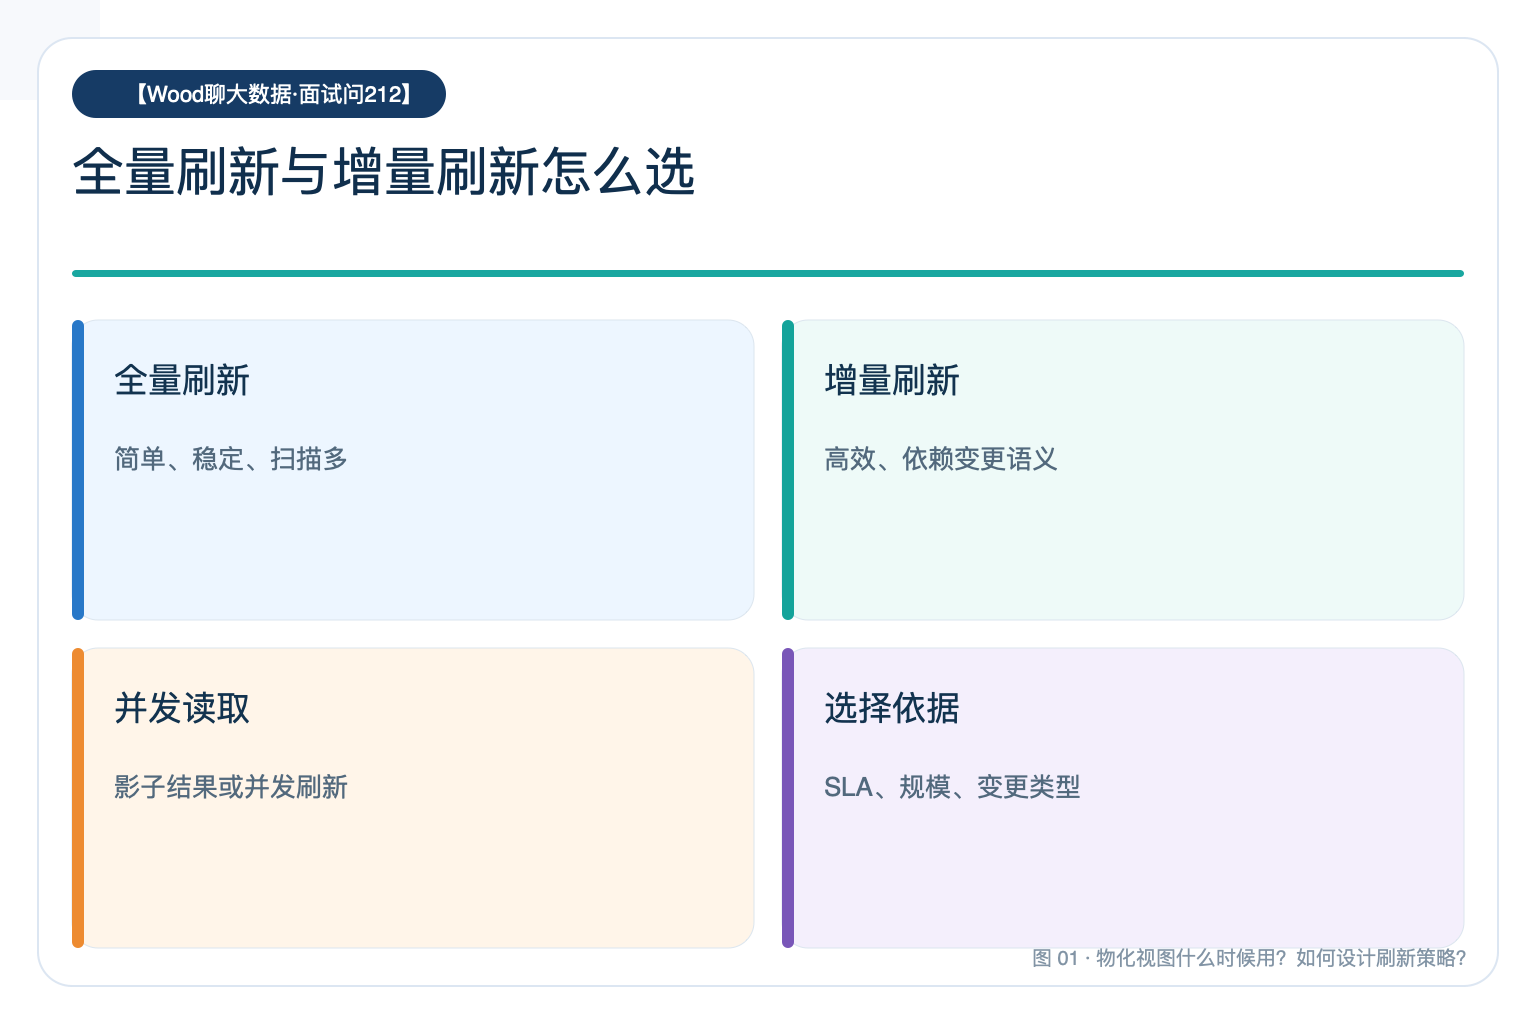
全量刷新简单但成本确定
全量刷新重新执行定义 SQL 并替换结果,语义清晰、实现容易,适合数据量可控或按日更新的场景。代价是每次都扫描全部基础数据,刷新窗口长时还要处理读写阻塞和旧版本保留。
增量刷新依赖可识别的变化
增量刷新不是加一个参数就完成。需要可靠获得新增、更新和删除,知道哪些分区或分组受影响,并让聚合可逆或可重算。SUM 容易增量维护,COUNT DISTINCT、复杂非等值 Join 和删除传播通常更难。
一致性切换比刷新动作更重要
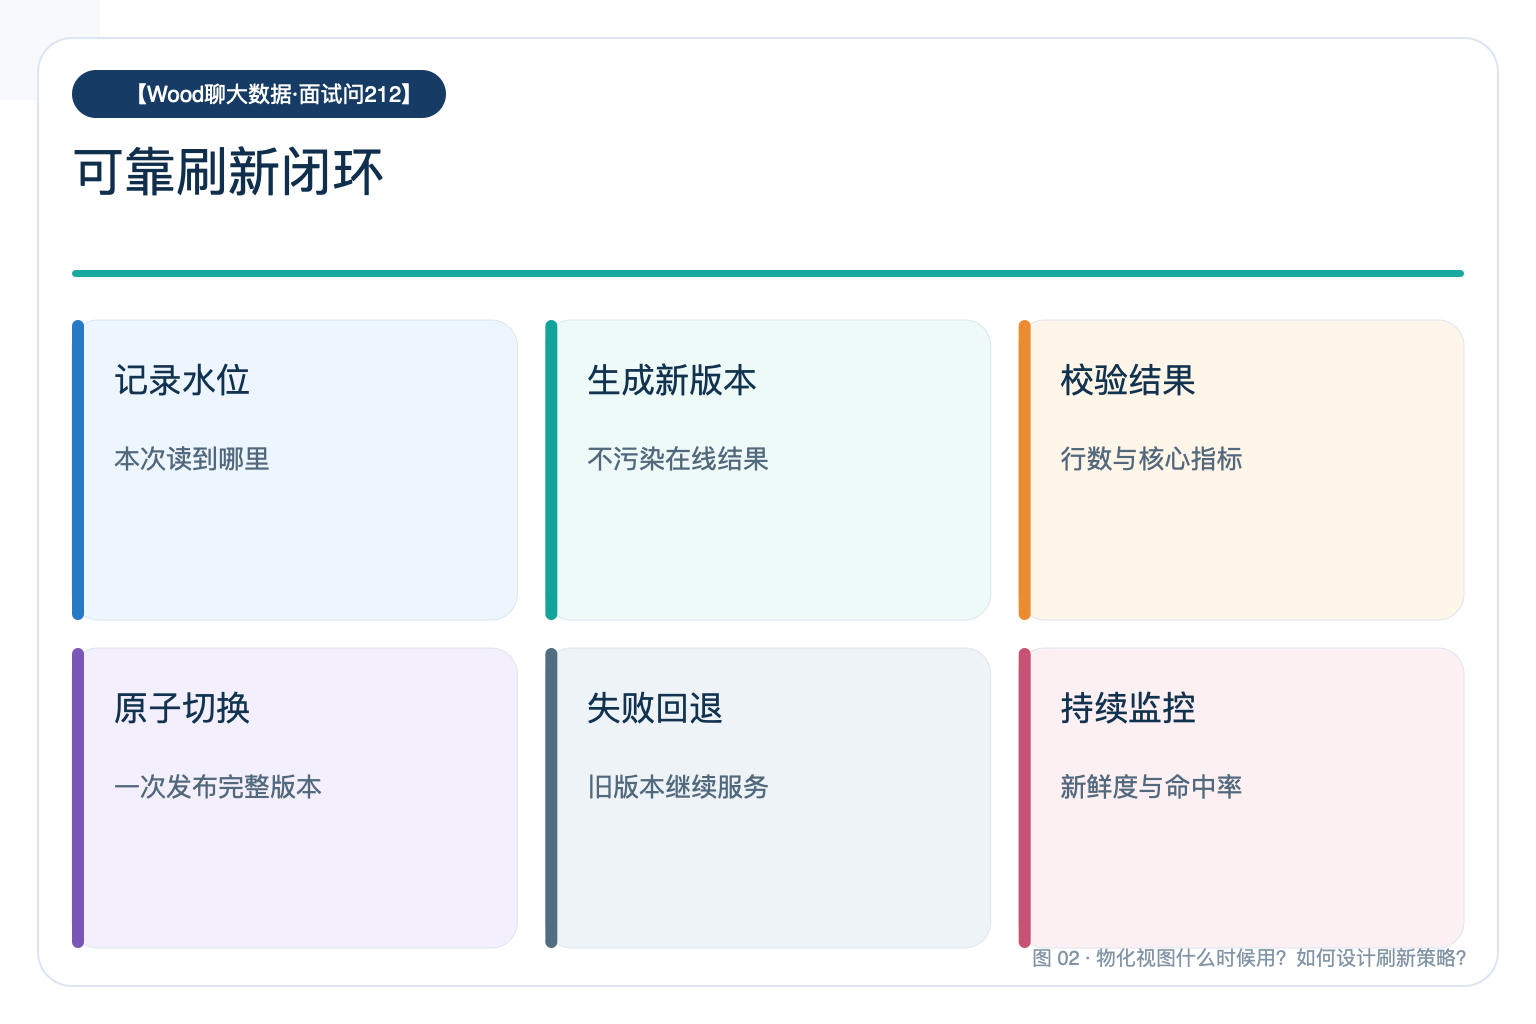
刷新过程中不能让用户看到一半新、一半旧。常见做法是影子表计算完成后原子切换,或由引擎提供并发刷新能力。还要定义刷新时点对应的源数据水位,避免多个基础表处在不同批次。
刷新失败必须能够恢复
刷新任务要幂等,记录本次输入水位、输出版本和校验结果。失败后应继续保留上一个可用版本,并支持从明确水位重跑。只监控任务成功不够,还要监控视图新鲜度、行数、核心指标和查询命中率。
别把物化视图当成万能缓存
缓存通常按请求结果和 TTL 管理,物化视图则有明确表结构、血缘和刷新语义。选择时要比较数据新鲜度 SLA、存储成本、刷新资源、查询改写能力和故障恢复,不是看到慢 SQL 就复制一份结果表。
参考资料
- PostgreSQL:REFRESH MATERIALIZED VIEW:https://www.postgresql.org/docs/current/sql-refreshmaterializedview.html