Iceberg 隐藏分区和分区演进是怎么实现的?
面试怎么回答
Iceberg 用 day、month、bucket 等 Transform 从业务列生成隐藏分区值,查询只过滤源列,规划器会自动映射到分区裁剪。修改 Partition Spec 时只是提交新的元数据规格,旧文件保留旧 Spec ID,新文件按新规格写入;查询时针对不同规格分别规划并合并结果。它让分区布局可以渐进演进,但不会自动重写历史文件,后续仍要按查询和文件情况安排 Rewrite 或 Compaction。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
Hive 分区变化常常意味着改写 SQL、迁移数据。
Iceberg 却允许新旧分区布局同时存在。
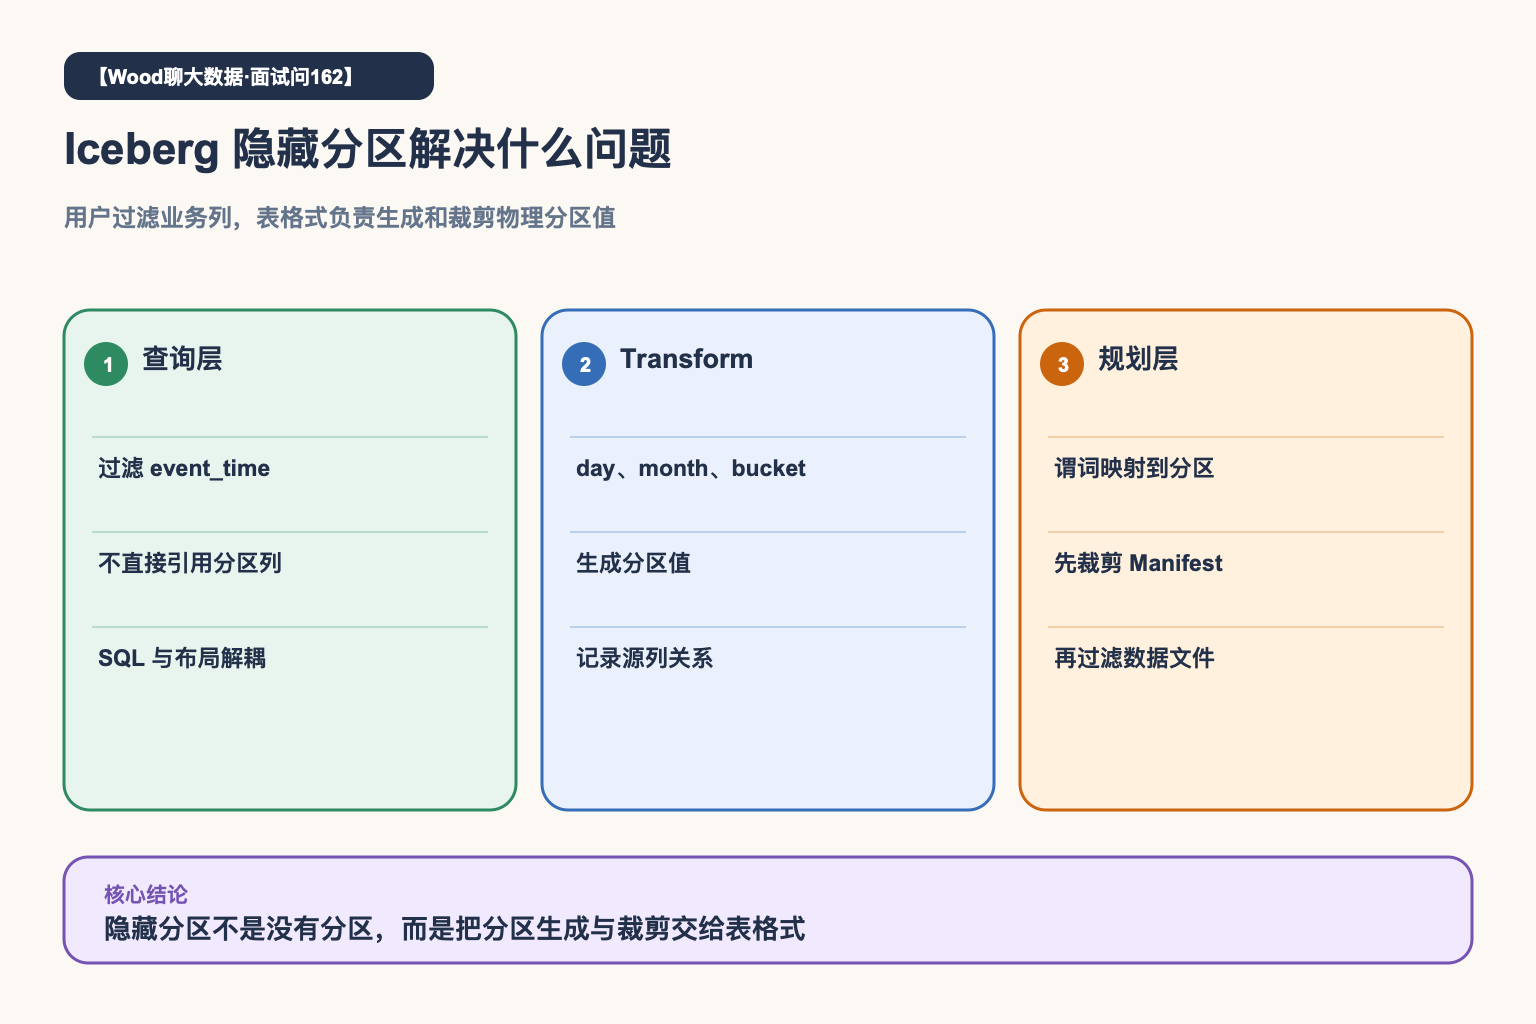
Iceberg 通过隐藏分区解耦查询列与物理布局,再用不同 Partition Spec 管理分区演进。
隐藏分区不是没有分区
传统 Hive 表常显式维护 event_date 分区列。写入方要计算 event_date,查询方也要记得同时过滤业务时间和分区列。
Iceberg 可以定义 day(event_time)、bucket(id, 16) 等 Transform。写入时由表格式根据源列生成分区值,查询时根据 event_time 条件自动推导可裁剪的分区。
用户只需要表达业务过滤条件,不必把物理分区布局写进每条 SQL。
分区规格可以演进
随着数据量变化,按月分区可能需要调整为按天,或者增加 bucket 分区来改善某类查询。
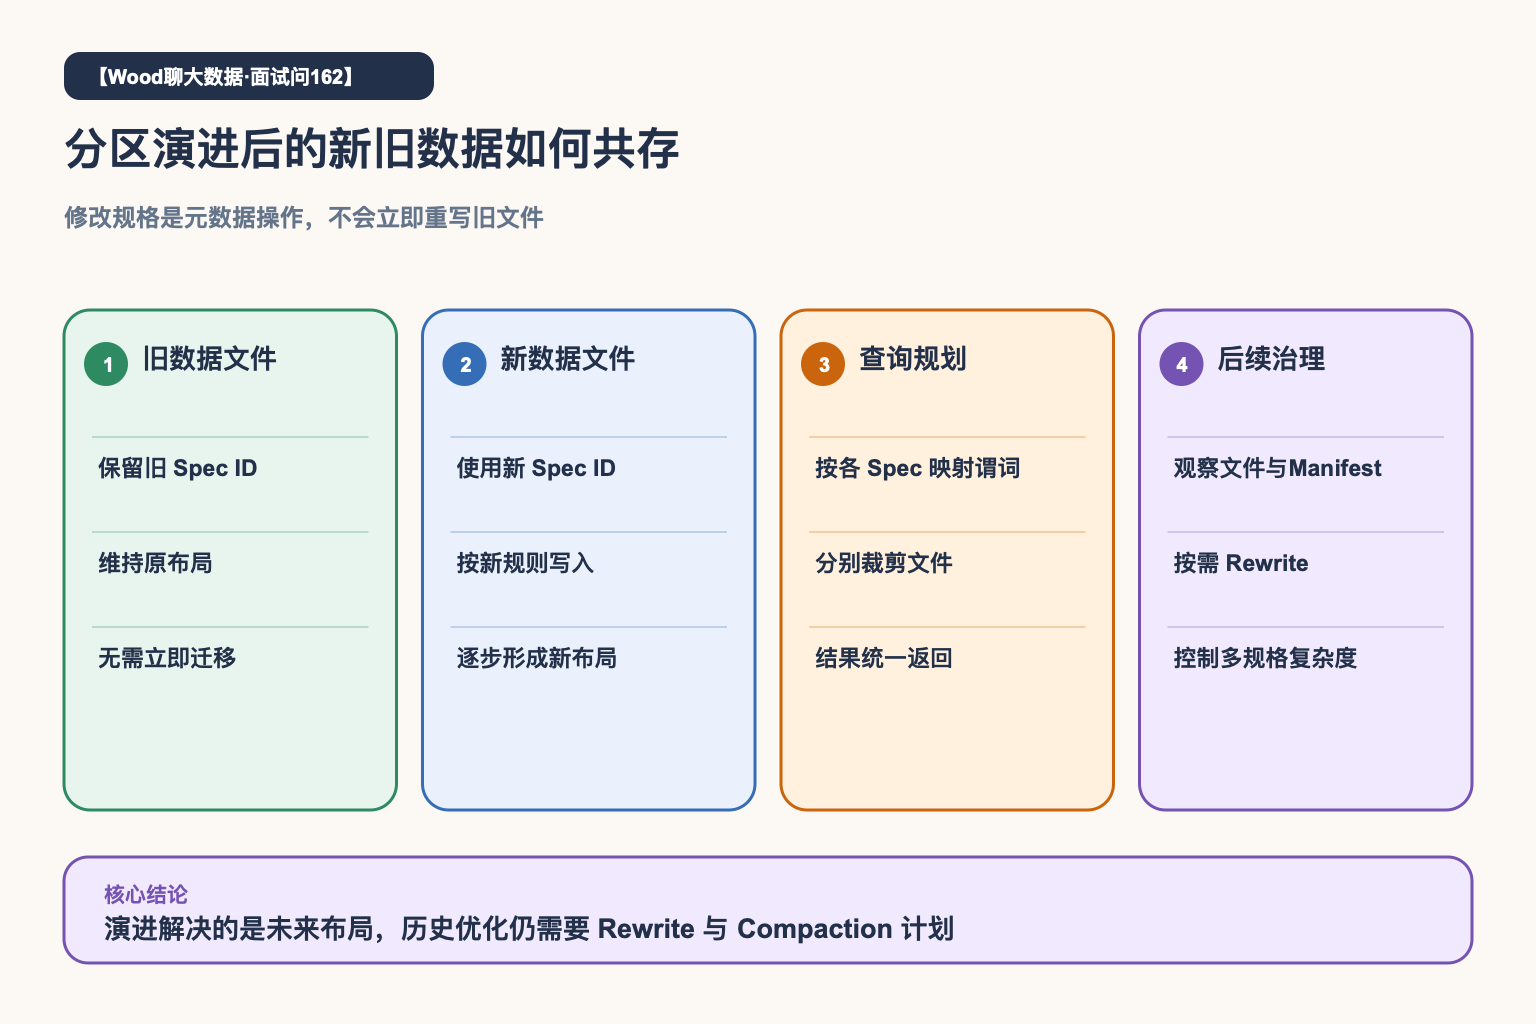
Iceberg 修改 Partition Spec 时,不会立即重写所有历史文件。旧文件继续保留旧 Spec ID,新写入文件使用新 Spec ID,两套布局可以在同一张表中共存。
查询时分别规划不同规格
扫描规划会根据每套 Partition Spec,把同一个业务谓词转换成对应的分区过滤条件,再分别裁剪文件。
例如旧数据按 month(ts),新数据按 day(ts),查询仍然只写 ts 的时间范围。规划器会针对两套布局产生不同裁剪逻辑,最终合并结果。
元数据演进不等于历史数据自动优化
修改分区规格主要是元数据操作,解决的是后续数据如何布局。旧文件不会自动变成新分区,也不会自动合并小文件。
如果历史数据仍是主要查询范围,可能还需要 Rewrite Data Files、排序或 Compaction。多套 Spec 长期并存也会增加规划和治理复杂度。
一个典型场景
日志表早期数据量小,按月分区足够。业务增长后,月分区内文件过多,时间范围查询扫描范围变大。
将新数据调整为按天分区后,近期查询很快受益;旧数据继续保留月分区。等热点历史范围明确后,再有选择地重写,而不是一次性迁移全表。
分区演进的价值,是让物理布局逐步调整,而不是承诺零成本地重构历史数据。