ClickHouse ReplacingMergeTree 为什么还有重复?FINAL 怎么用?
本文目录
面试怎么回答
ReplacingMergeTree 在合并阶段按完整 ORDER BY 键识别重复,再按版本选择记录,写入并不立即唯一。需要即时当前状态时评估 FINAL,它与强制物理合并的 OPTIMIZE FINAL 不同。建模上保证实体键不随状态和版本变化,来源版本可靠,分区及分片归属稳定,并测试晚到、冲突和删除场景。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
往 ReplacingMergeTree 连续写入同一订单的新旧状态,查询时却看到两行。开发怀疑主键没生效,准备每次写入后都强制合并。要先弄清这类表引擎在哪个阶段做替换。
ReplacingMergeTree 按完整排序键识别同一实体,在合并时按版本选取记录;即时正确查询要显式考虑 FINAL 等去重语义,并保证键、版本与分区稳定。
写入新版本通常先产生新的数据片段
ReplacingMergeTree 允许多条相同排序键记录进入数据片段,后台合并时才按引擎规则选择保留版本。合并时机和范围受系统调度影响,不能把后台最终去重当成每次查询已经唯一的承诺。
这里决定重复身份的是完整 ORDER BY 排序键,而不是单独声明的 PRIMARY KEY。分析型表的主键索引语义与事务数据库的唯一约束不同,排查应先读实际 DDL,再看重复记录每个排序字段是否相同。
版本列要表达业务先后,而不是随机到达先后
配置版本列后,引擎在相同排序键候选记录中比较版本。版本应来自能够确定源端变化顺序的信息,不能仅用低精度时间戳碰运气;相同版本出现冲突时,也要有明确处理约定。
如果把版本列加入 ORDER BY,每个版本就成为不同排序键,替换自然无法把它们识别成同一实体。会变化的状态字段也不宜随意放进用于实体身份的排序键,否则更新状态等于创建了新的键。
FINAL 在读取阶段应用合并语义
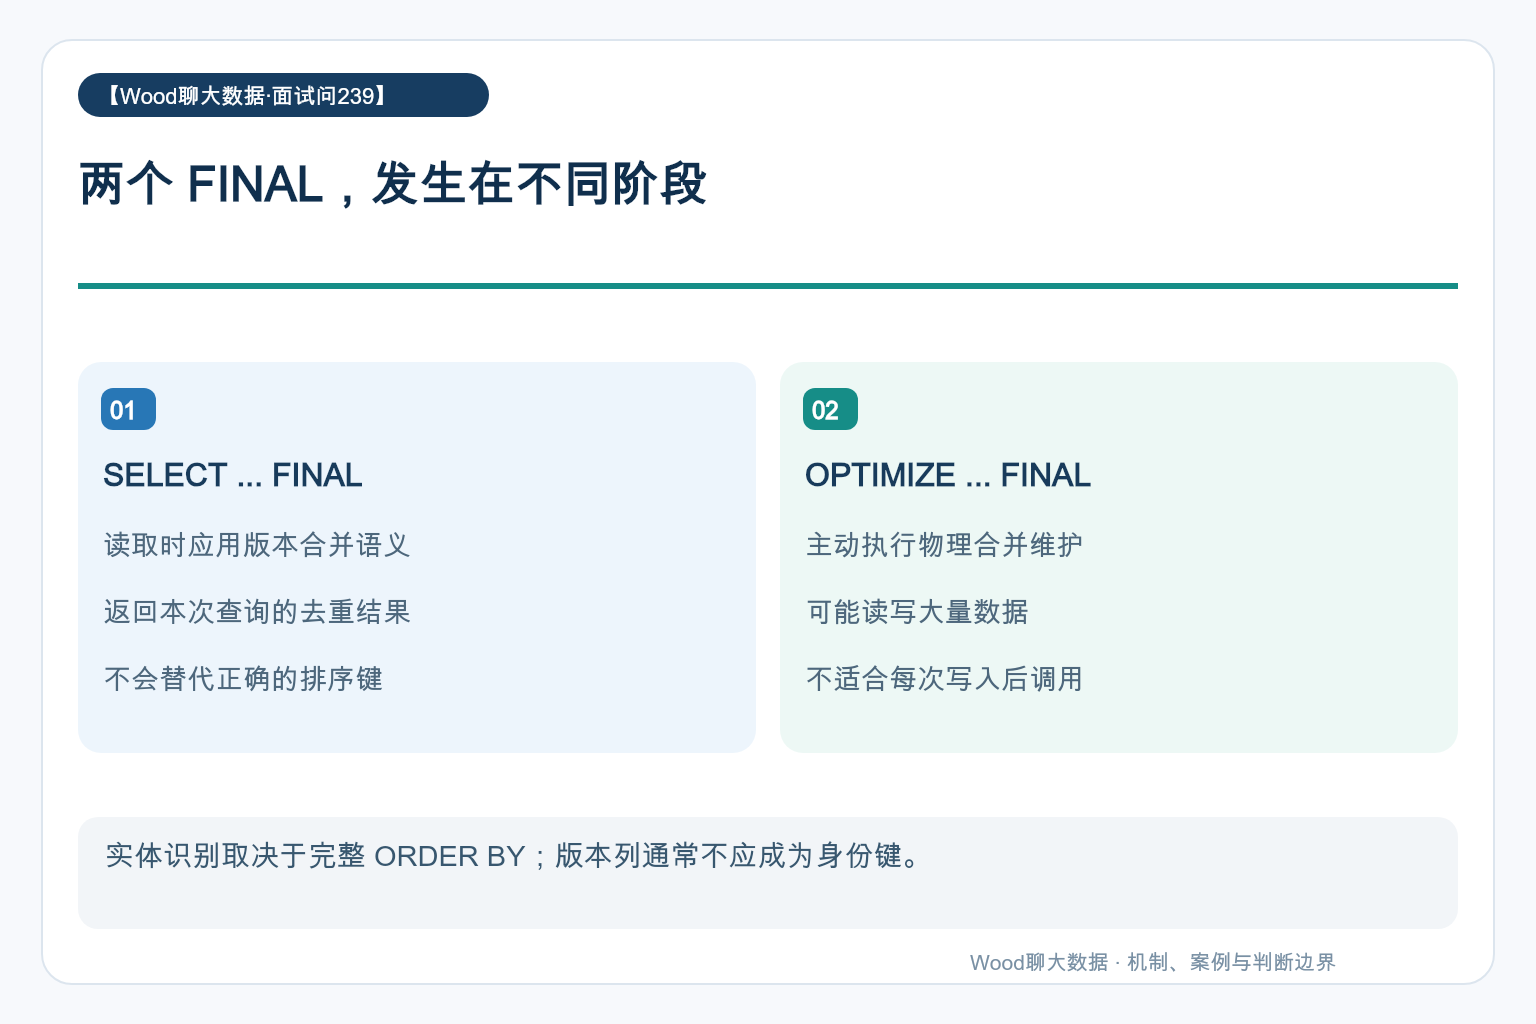
需要当前状态的查询可以评估 SELECT ... FINAL,让查询按照表引擎的规则处理版本;这会增加读取阶段的计算,实际代价受过滤范围、数据布局和版本分布影响。
FINAL 与 OPTIMIZE TABLE ... FINAL 不同:后者是主动推动物理合并的维护操作,可能消耗大量资源,不能要求每次写入后都执行。还可以评估按完整实体键选择最新版本的查询,但多字段、空值和删除语义必须一起处理。
一个典型场景:加 FINAL 也去不掉重复
比如同一订单两个版本分属不同状态,开发把状态放进 ORDER BY。加上 FINAL 后仍返回两行,最初以为引擎合并异常,比较完整排序键才发现它们根本不是同一替换组。
原验收只检查业务 id 相同,没有把完整键展开。修复需要调整稳定实体键,并评估历史数据迁移,不能指望换个查询关键字修复错误建模。对更新和删除都应构造明确的版本序列验证。
分区与分片要保证版本能相遇
后台物理合并不会跨分区进行,因此同一实体的不同版本应保持稳定分区归属。分布式表还要保证相同实体被路由到合适的同一分片,否则本地去重无法自动解决全局重复。
查询阶段是否跨分区处理与相关设置有关,不能靠这一点掩盖不稳定的数据布局。验收应覆盖晚到旧版本、相同版本冲突、状态变化和删除,观察查询前后结果及成本。性能优化建立在实体识别正确的基础上。