ClickHouse 增量物化视图为什么不随源表更新?和定时刷新有什么区别?
面试怎么回答
ClickHouse 增量物化视图更像插入触发器,只对新插入的数据块计算并写入目标表。源表更新、删除以及普通 JOIN 右表变化,不会自动让历史结果重算。追加型数据适合这种方式;需要反映持续修正的数据,可设计可去重的正负变更流,或使用周期执行完整查询的可刷新物化视图。还要验证回填边界和目标表聚合语义,不能只看源表已经正确。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
源表查出来已经是 80,汇总表还是 100。等后台合并、刷新查询、再查一次,结果仍然没变。名字里都有“物化视图”,不代表它们都在持续重算源表的最新完整结果。
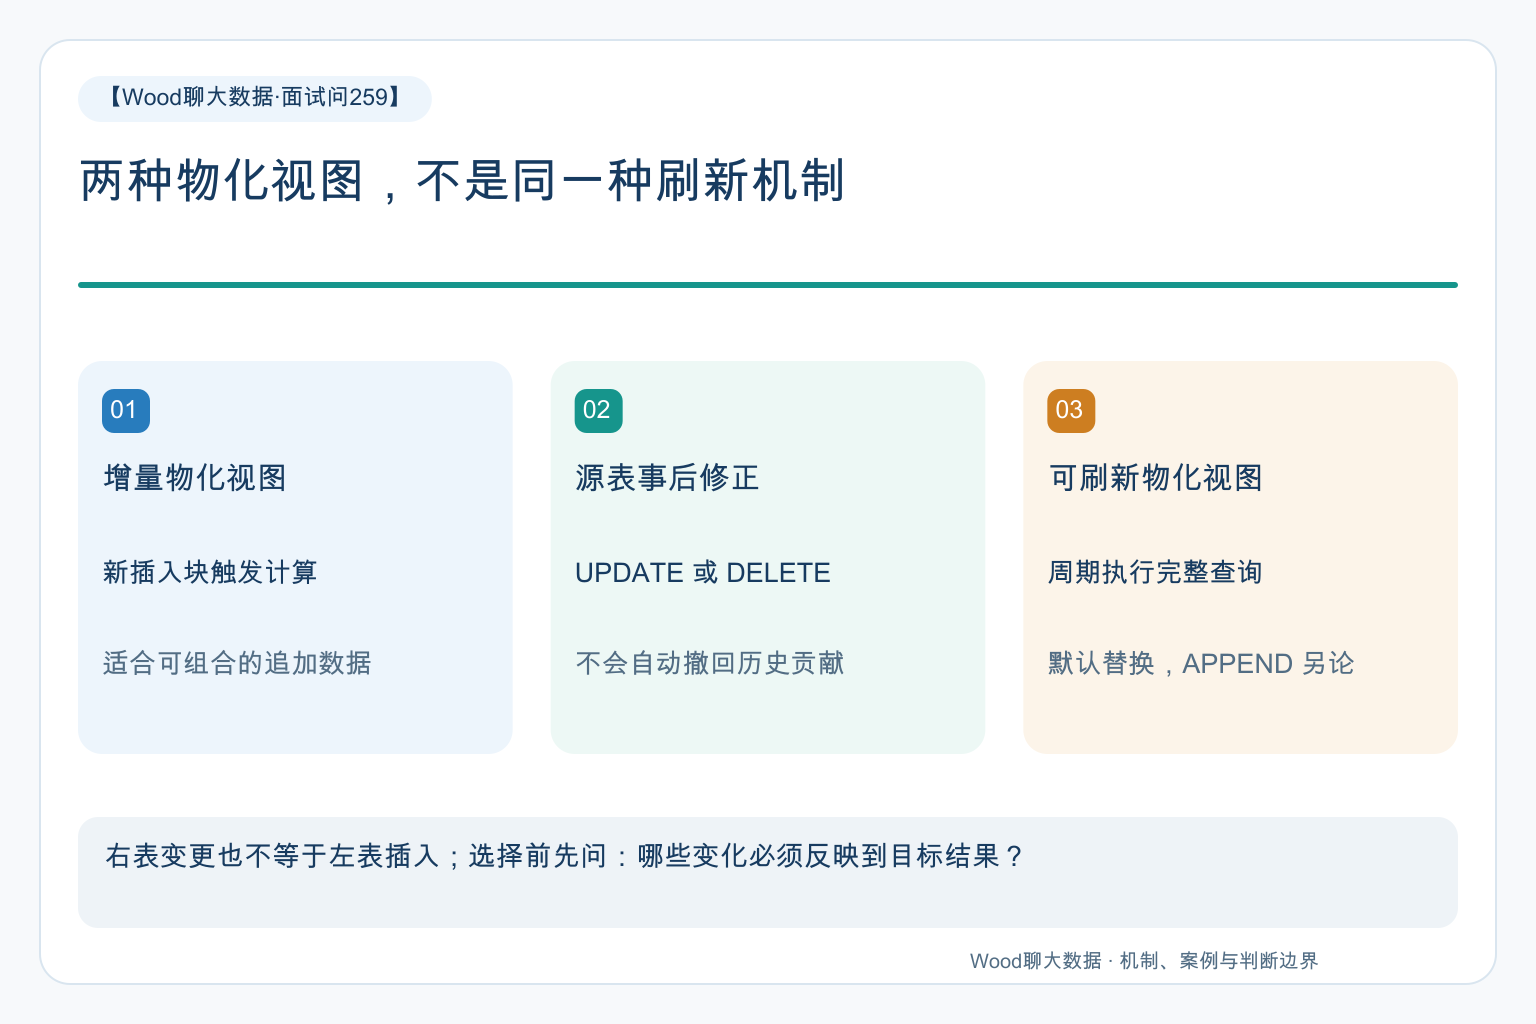
ClickHouse 增量物化视图处理新插入的数据块,不会自动重放源表更新;修正型数据要另设计变更传播或刷新。
先把它理解成插入触发器
ClickHouse 增量物化视图在源表有新数据块插入时,对这些新块执行查询,并把结果写到目标表。它将一部分查询成本移到写入阶段,很适合追加事件的过滤、转换和可组合聚合。
关键是“新插入的数据块”。查询虽然写着 FROM 源表,但这条触发路径不是每来一批数据就重新扫描全部历史。窗口计算、去重、关联或聚合能否这样拆开,需要按实际计算语义判断。
目标表还要有配套的存储与查询方式。比如局部聚合结果进入 SummingMergeTree 后,后台合并是异步的,读取时不能想当然地假设每个键永远只有一行,应按设计再次聚合。平均值也不能直接平均各批次的平均值,应保存可合并状态或和与数量。
源表修正,不会自动撤回过去的贡献
源表发生 UPDATE、DELETE 或后台合并,不会让普通增量物化视图自动重新处理历史贡献。原来进入汇总的 100,不会因为源表改成 80,就自然变成 80。
即使源表使用 ReplacingMergeTree,后来合并只留下最新版本,也不能推导下游 SUM 曾经累计的旧版本会被撤回。读源表时使用 FINAL,解决的是该查询的读时合并语义,并没有替已经写到目标表的贡献做冲正。
JOIN 也有类似边界。普通增量物化视图关联右侧维表时,驱动触发的是左侧源表的新插入;仅修改右表,不会让过去插入的数据全部重算。因此要先问指标需要“事件发生时维度”,还是“当前最新维度”。
可刷新物化视图,适合另一类问题
可刷新物化视图按计划周期执行完整查询,默认用新结果原子替换已有目标内容。这更容易表达需要完整数据、多个表最新状态的计算,但要接受刷新周期带来的延迟和重复计算成本。
APPEND 模式是另一种语义:刷新结果追加保存,而不是覆盖。它可以用于周期快照等场景,不能把默认替换的结论套到 APPEND 上。正式使用前还要检查部署版本支持的语法与限制。
选择时不要只问哪一种更快。先问数据是否只追加、历史会不会更正、维表变化是否要追溯,以及结果能晚多久。实时性和变更完整性需要一起考虑。
一个典型场景:新增测试全对,更正测试全错
比如源订单先写入金额 100,增量视图把它加进日汇总;随后订单金额被修正为 80,日汇总仍是 100。最初怀疑目标表合并没完成,但等待之后也没有变化。
根因是源表更正没有触发对历史贡献的撤回。原验收只做新增数据,新增路径当然正常,却没有测修改、删除和维表更新。改进要把这些变更类型写进验收矩阵,并检查目标结果,而不是只确认源表已变正确。
修正型数据,有哪些可选路线?
如果业务能产出完整、可去重的变更事件,对可加指标可以先撤回旧贡献,再写入新贡献,例如 -100 与 +80。但这要求拿到旧值、避免重复冲正,并保证迟到和回放规则,不能只把一条最新值当增量再加一遍。
如果更关注周期一致的完整结果,可以使用可刷新物化视图或受控重算。若只是展示维度需要最新名称,也可以考虑查询时关联,而不是把所有历史标签固化在写入路径里。
历史回填同样要有切分边界:建立实时路径前后的数据如何接续,哪些已进入目标,重复执行回填会不会二次累计。边写边无界全量灌入,很容易把“补历史”做成“历史加两遍”。