Parquet 怎么跳过不相关数据?有过滤条件为什么仍然扫描很多?
本文目录
面试怎么回答
我会从列投影、行组统计和更细索引三层解释。Parquet 能跳过有证据证明不匹配的数据,但条件下推不保证一定少扫;随机布局可能让每个行组的范围都很宽。还要检查 Page Index 或 Bloom Filter 是否被写出并被读取器使用,最后用扫描字节和跳过比例验证,而不只看执行计划中的开关。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
查询只找一个用户,返回一行,却读取了大量 Parquet 数据。看到执行计划里有过滤条件,很多人就以为底层一定只读命中的记录。实际上,“条件被下推”和“文件内容能被跳过”是两件事。
Parquet 依赖列投影、统计范围和可用索引减少读取;实际裁剪效果还取决于数据布局、谓词形式与读取器支持。
先把 Parquet 看成分层结构
文件中的记录按 Row Group,也就是行组,进行组织。一个行组里,各列的数据分别存放在对应的 Column Chunk 中,列块内部再由多个 Page 组成。文件元数据帮助读取器定位这些内容,不必把整个文件逐字节解开才知道布局。
只查询少数列时,列投影可以避开其他列;只关心部分记录时,则要依赖统计信息或索引判断某些区域是否一定不匹配。这两种减少读取的方法应分开理解:少读列不等于少读行,输出少也不等于物理读取少。
min 和 max 只有能排除候选时才有价值
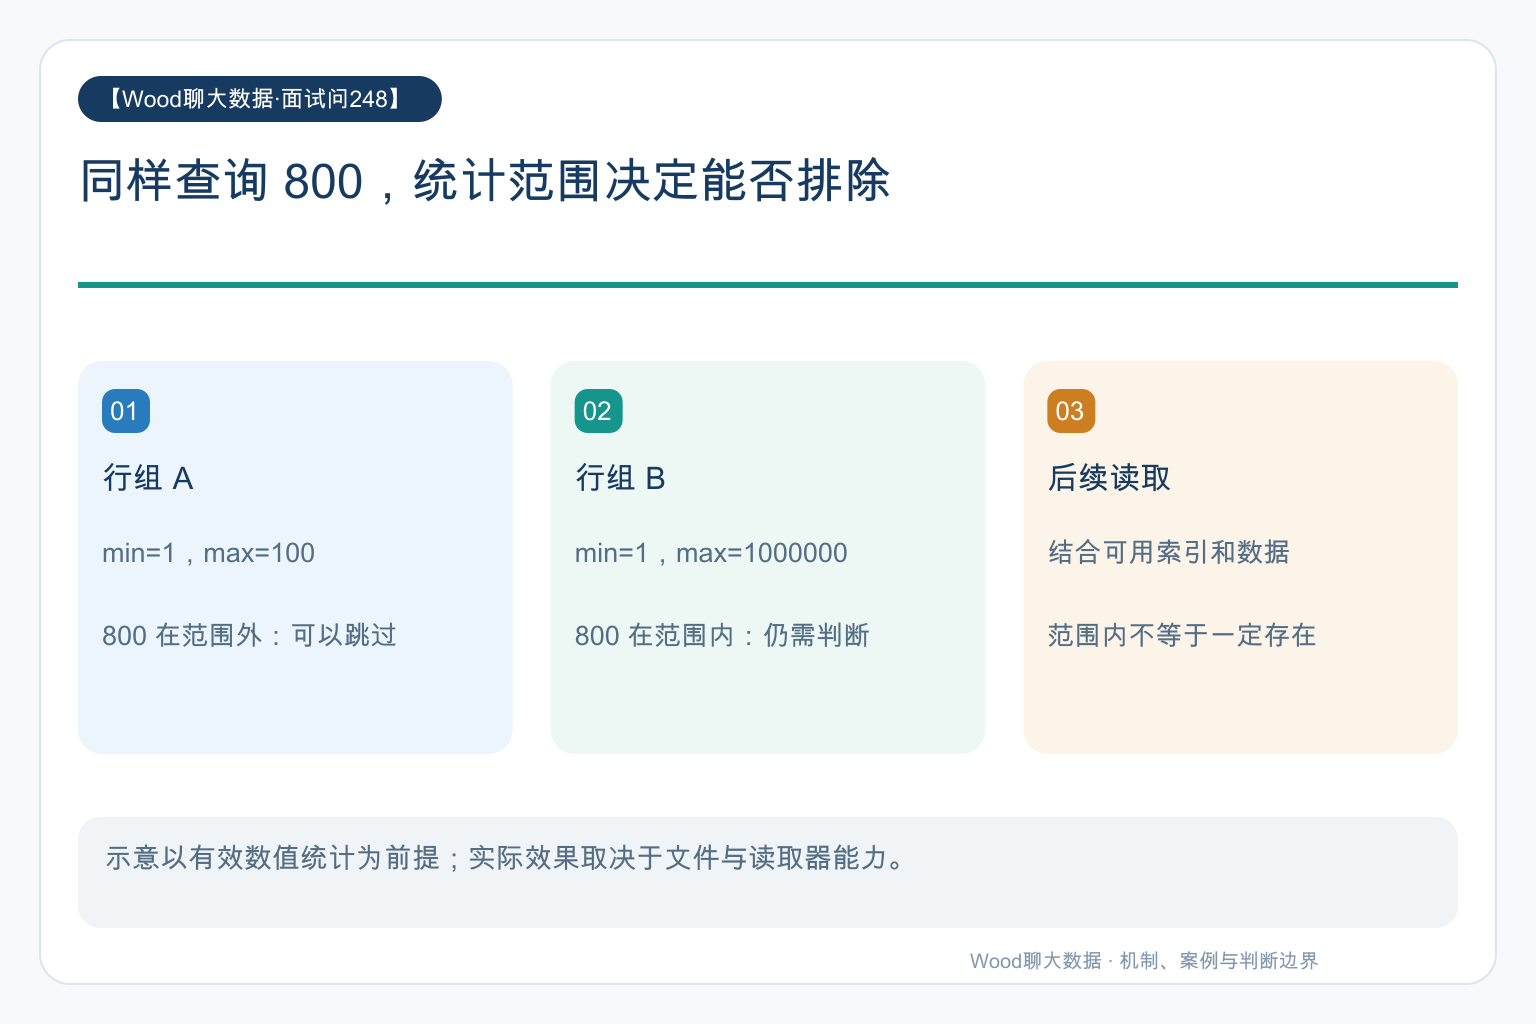
假设一个行组中 user_id 的范围是 1 到 100,查询 user_id = 800,读取器可据此排除该组。但如果另一个行组的范围是 1 到 1000000,800 虽然落在范围内,也不代表真的存在,只能说明不能仅靠范围把它排除。
随机打散写入时,每个行组的最小值和最大值都可能覆盖很宽范围。大量行组都“可能命中”,过滤条件即使已经传给读取器,也仍需读取不少数据。能否裁剪取决于数据分布,而不只是有没有 WHERE。
Page Index 和 Bloom Filter 补充不同能力
Page Index 可以提供更细的数据页统计和位置信息,使支持它的读取器进一步跳过不相关页。Bloom Filter 则帮助回答某个等值是否确定不在相应数据范围内,适合范围统计不够有区分度的某些等值查找。
它们不是每个文件必定都有,也不是所有引擎或读取路径都会使用。需要同时确认写入端是否生成、文件中是否存在、读取器版本是否支持,以及查询条件是否适配。不能根据“格式标准支持”就承诺当前集群已经生效。
一个典型场景:过滤下推成功,扫描量没降
比如按用户号查询订单,计划里已经显示下推条件,团队仍怀疑某个开关没打开。查看文件元数据后发现,写入顺序是随机混排,几乎所有行组都覆盖完整用户号范围,统计信息无法排除任何一组。
原来的验收只截图执行计划,没有记录扫描字节和跳过行组比例。问题不是 SQL 没传下去,而是物理布局没有提供足够的排除证据。可以评估在常用过滤列上排序或聚簇,再用同一查询集比较读写成本,而不是无限叠加参数。
排序也有代价,并且服务一个访问模式不一定服务所有访问模式。按用户排序可能有利于用户查询,却未必适合所有时间范围分析;应结合主流查询、写入频率和文件维护成本选方案。
谓词写法可能让证据用不上
如果把过滤列包进复杂函数、UDF 或不易转换的类型表达式,读取器可能无法将条件转换成可用的底层谓词。尽量明确类型和边界,再检查实际计划,不要笼统宣称“任何函数都会导致裁剪失效”,因为优化器能力存在差别。
NULL、NaN、字符串排序及统计信息是否完整,也会影响某些条件能否安全使用。缺少可靠证据时继续读取,是为了保证正确性;读取器不能为了少扫数据而把不确定的区域直接跳过。
行组不是越小越好
更小行组可能提高裁剪粒度,也会增加元数据和调度开销,并影响压缩及顺序读取效率。更大行组有利于批量处理,但范围可能更宽、一次读取和解码的压力也可能更高。
验收应固定数据版本与查询条件,区分冷缓存和热缓存,记录读取文件、行组、字节、解压 CPU 与结果一致性。同时把目录分区裁剪和 Parquet 文件内部裁剪分开统计,才能知道真正节省发生在哪一层。