RAG 知识库的数据链路怎么设计?
面试怎么回答
RAG 知识库我会拆成三条主线:离线索引负责采集、解析、切分、元数据和多路索引;在线链路负责权限过滤、召回、融合、重排和上下文组装;治理链路负责版本发布、删除、质量评估和可观测。重点不是单次向量化,而是让每个 Chunk 可追溯、更新可幂等、权限在召回前生效,并能把错误定位到数据、检索或生成阶段。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
公司要把产品文档、客服 SOP 和内部制度接入大模型。演示版只需要上传几个文件,生产版却要回答:文档更新后多久生效?权限怎么继承?旧内容怎么删除?错误答案能不能定位到原文?
这已经不是一个“调用 Embedding 接口”的问题,而是一条完整的数据链路。
我的核心结论是:RAG 知识库要同时设计离线索引链路、在线检索链路和治理闭环。向量化只是其中一步,真正决定能否上线的是数据可追踪、权限一致和增量更新。
第一条:离线索引链路
常见流程是:
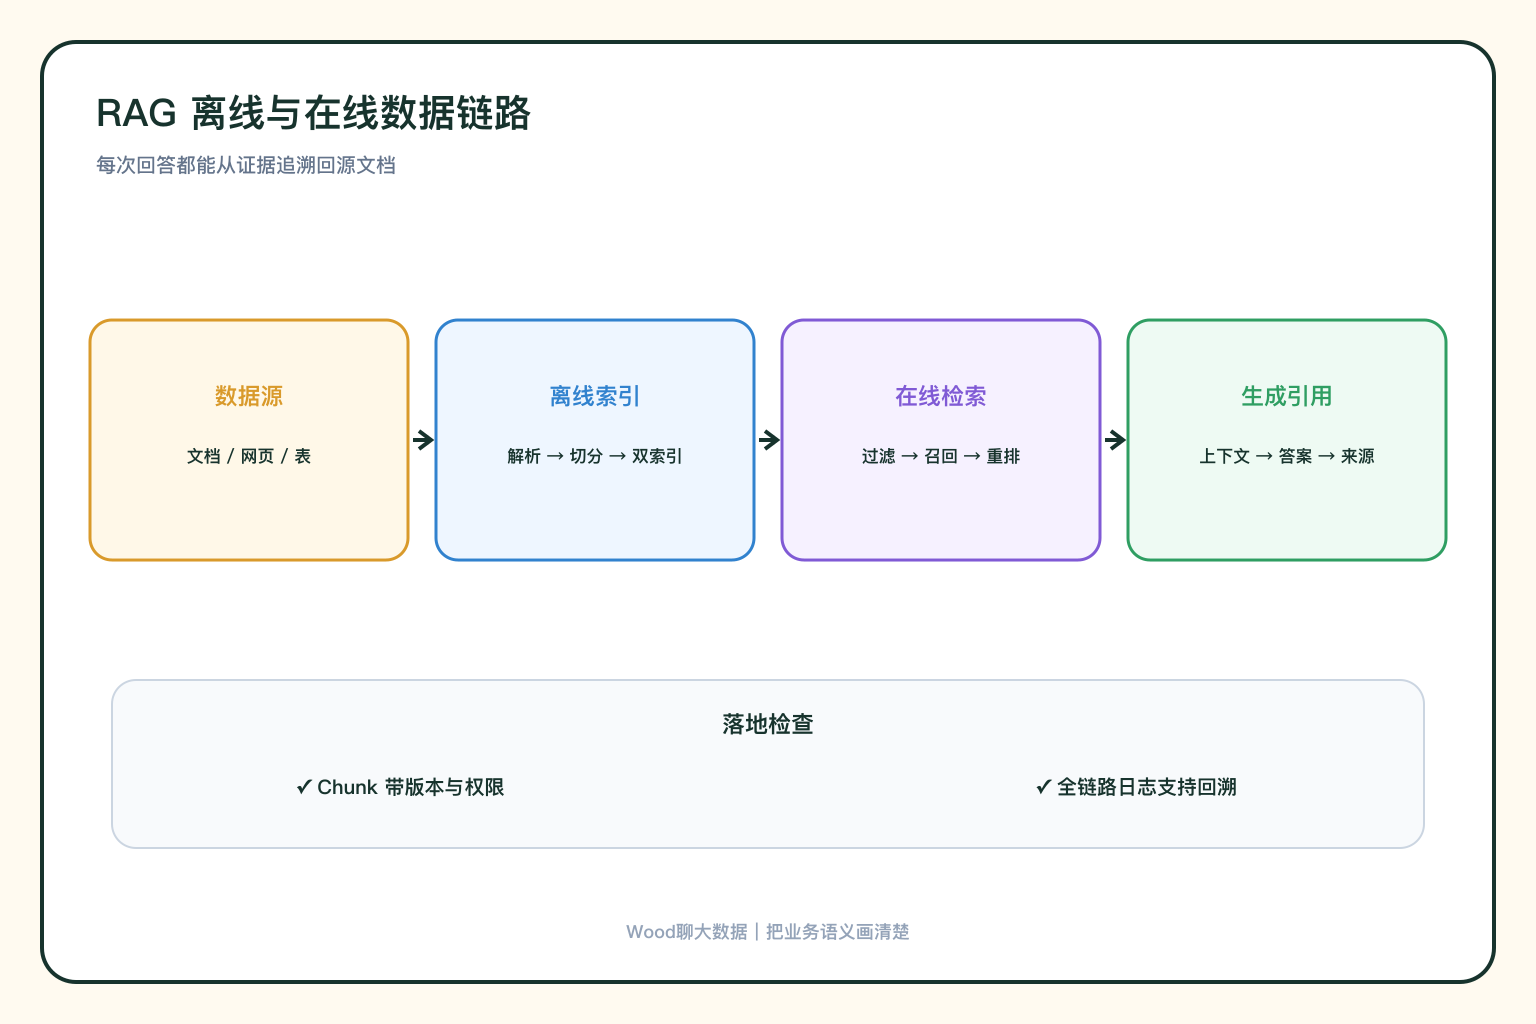
数据源 → 采集 → 解析清洗 → 切分 → 元数据补全
      → Embedding → 向量/关键词索引 → 发布
数据源可能是 PDF、网页、数据库、工单或云文档。采集时就应生成稳定的 document_id、来源地址、版本、更新时间和内容哈希。解析阶段要去掉页眉页脚、导航栏和重复模板,同时保留标题层级、表格结构和附件关系。
切分后的每个 Chunk 不能只有正文,还要携带 document_id、chunk_id、章节路径、权限标签、版本和有效状态。Embedding 模型、切分规则一旦变化,也要记录版本,否则索引重建后无法解释效果差异。
第二条:在线检索链路
在线请求通常经过:问题改写或意图识别、权限与业务条件过滤、关键词和向量召回、融合、重排、上下文组装、模型生成与引用返回。
不能先全库检索再在答案阶段判断权限。部门、租户、地区、文档有效期等条件应尽可能进入召回过滤,避免无权内容进入上下文。
检索结果还要控制 Token 预算。不是 TopK 越大越好:候选太少可能漏信息,候选太多会增加成本,并把互相冲突或低相关内容塞给模型。
第三条:增量更新和删除
文档更新时,如果只追加新向量,不删除旧版本,同一个问题可能同时召回新旧制度。
更稳妥的做法是以文档版本为单位生成新 Chunk 和索引,完成校验后原子切换有效版本,再异步清理旧索引。删除也要从源记录、Chunk、关键词索引、向量索引和缓存全链路生效。
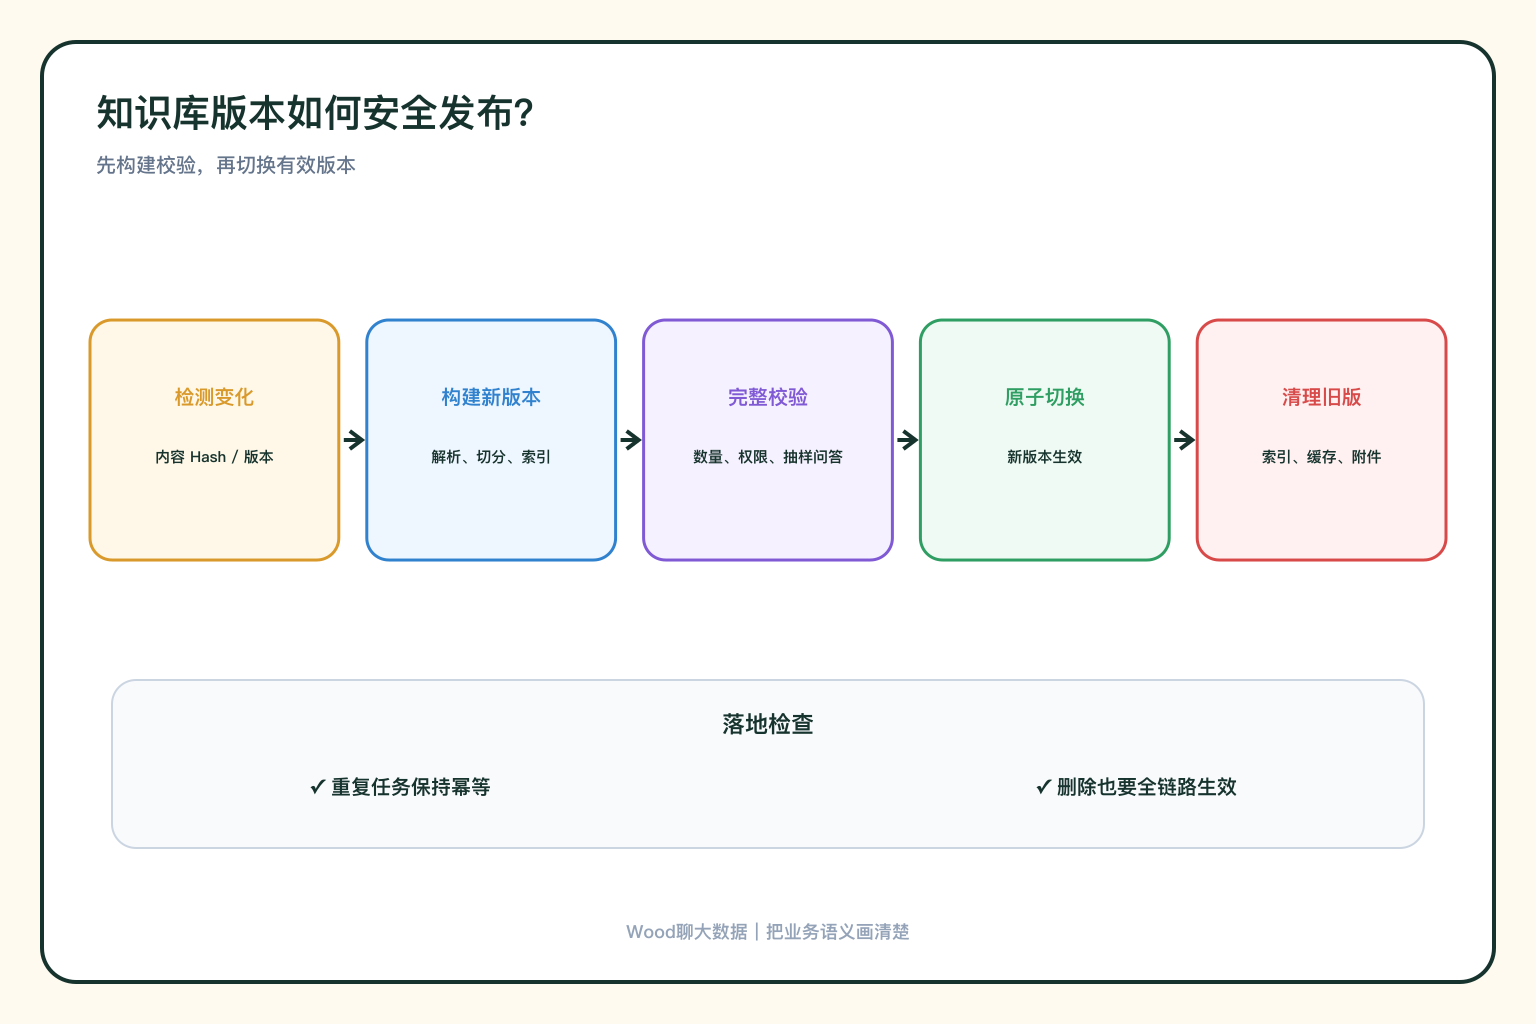
链路应支持幂等:同一个文档版本重复消费,不产生两套有效 Chunk。内容哈希可以判断是否真的变化,任务状态表则记录解析、向量化、索引和发布进度,便于失败重试。
第四条:质量和可观测性
我会分别监控四类指标:
- 数据层:采集成功率、解析失败率、重复率、更新延迟
- 索引层:Chunk 数、空内容率、Embedding 失败率、版本一致性
- 检索层:Recall@K、MRR、无结果率、权限过滤命中
- 答案层:事实正确性、引用完整性、拒答准确率、延迟与成本
每次问答最好保留查询、过滤条件、候选文档、重排分数、最终上下文、模型版本和引用。出现坏答案时,才能判断是源文档错误、没切到、没召回、排错序,还是模型没有忠实使用上下文。