RAG 如何做数据权限隔离?
面试怎么回答
我会把 RAG 权限放在模型之前处理。请求先通过可信身份得到租户、角色和资源范围;每个 Chunk 继承文档权限、状态和版本;检索时强制做 Metadata 或索引级过滤,不能只靠生成后拦截。同时缓存 Key、日志、重排服务和引用回源都要继承授权上下文,并对撤权和删除建立传播 SLA。最后用跨租户和缓存等负向用例持续验证不越权。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
检索质量再高,只要把别的租户、别的部门或已撤销文档召回一次,系统就不能上线。
RAG 的权限问题也不能靠一句“让大模型不要回答”解决,因为敏感内容一旦进入上下文,边界就已经被突破了。
权限必须在检索前和检索中生效,生成后审计只能兜底;身份、资源、索引和缓存都要在同一条授权链路里。
第一层:统一身份和授权上下文
每次请求都要携带可信的用户、租户、部门、角色和资源范围,这些信息应由认证与授权系统产生,而不是相信 Prompt 里用户自己填写的“我是管理员”。
权限模型可以是 RBAC、ABAC 或两者结合。关键是把最终可访问范围转换成检索层能执行的过滤条件,并记录授权决策版本,便于事后审计。
第二层:让 Chunk 继承资源权限
文档切分后,每个 Chunk 都要保留 tenant_id、document_id、权限标签、状态、版本和有效期。不能只在文档主表有权限,向量索引里却只剩文本和向量。
新增、修改、撤权和删除都要传播到检索索引。特别是撤权:业务库已经禁止访问,但旧向量仍可召回,是常见的数据泄漏窗口。
第三层:检索时强制过滤
最稳妥的边界是先按租户、权限和文档状态缩小候选空间,再做向量或关键词召回。具体系统也可能支持索引内过滤,但必须验证过滤比例很高时的召回和延迟。
检索后再过滤虽然实现简单,却可能导致 TopK 全被剔除、正确候选进不来;更重要的是,未经授权的内容可能已经进入中间日志或重排服务。
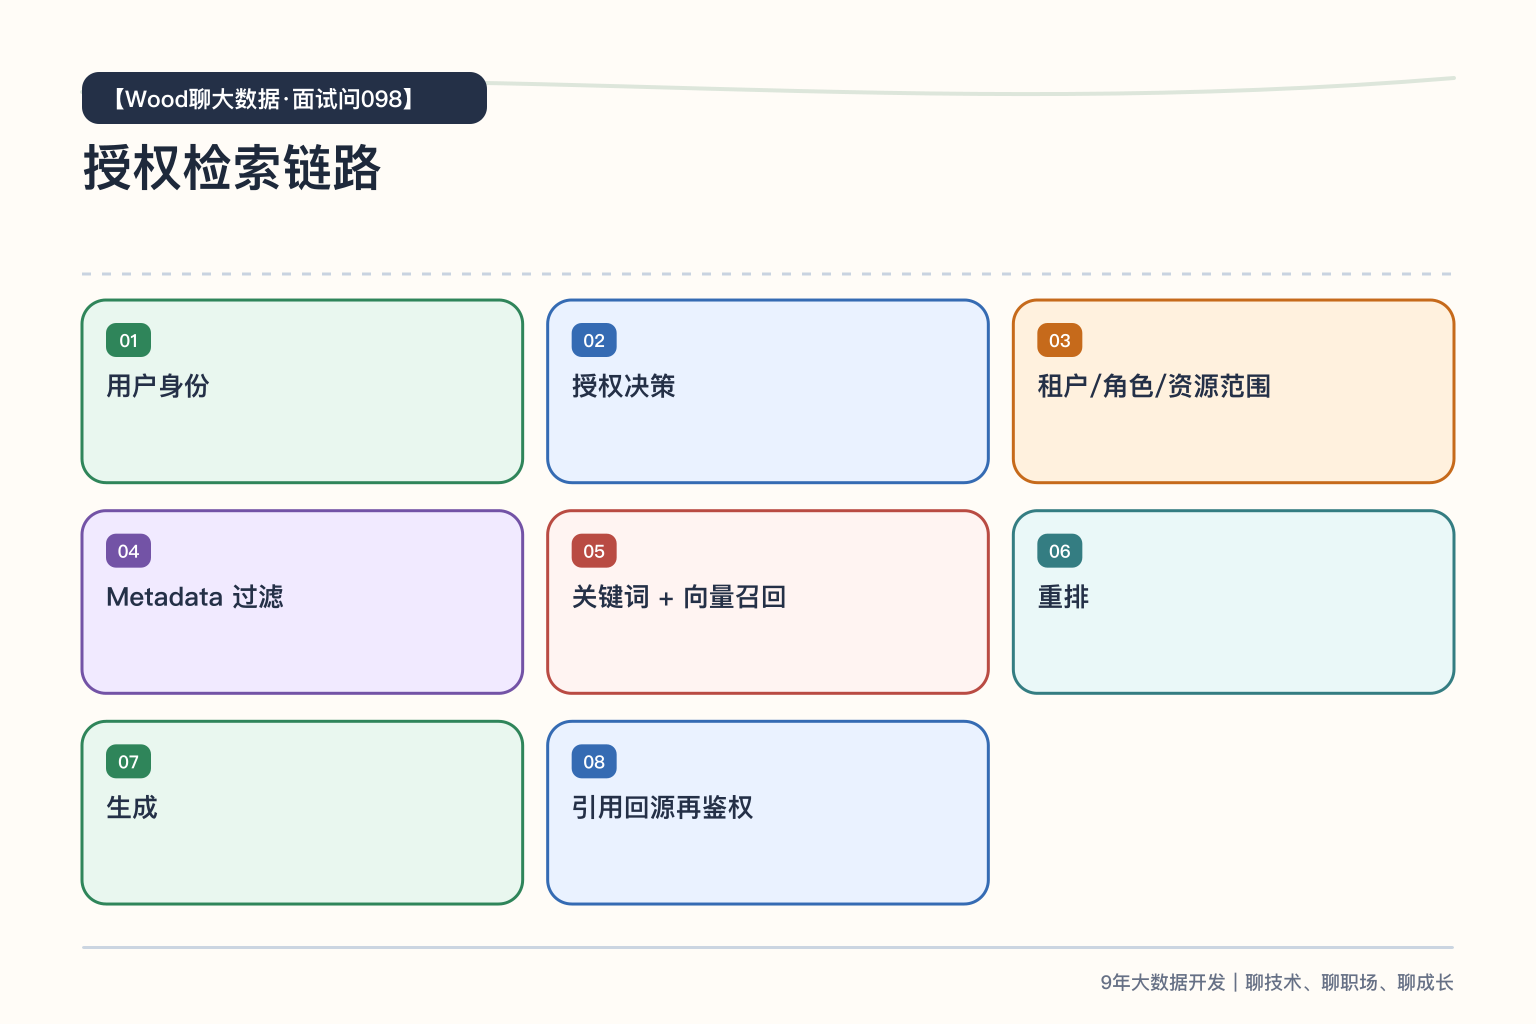
第四层:控制缓存、日志和引用回源
缓存 Key 必须包含权限上下文或资源版本,不能让管理员问题的答案被普通用户命中。Prompt、检索结果、模型响应和调试日志都可能包含敏感数据,需要脱敏、加密、限制保留周期和访问人群。
答案中的引用链接还要再次鉴权。即使模型只返回文档标题,用户点击回源时也不能绕过原系统权限。
一个典型反例
某知识助手在向量入库时记录了 department_id,但缓存只使用“规范化问题”作为 Key。财务用户先问过一个问题,其他部门输入相同问题后直接命中缓存,完全没有经过检索过滤。
检索层权限本身没错,漏洞出在旁路。修复需要让缓存绑定租户和权限摘要,并在权限变更后失效;同时检查日志、离线评测集和人工标注平台是否复制了敏感内容。
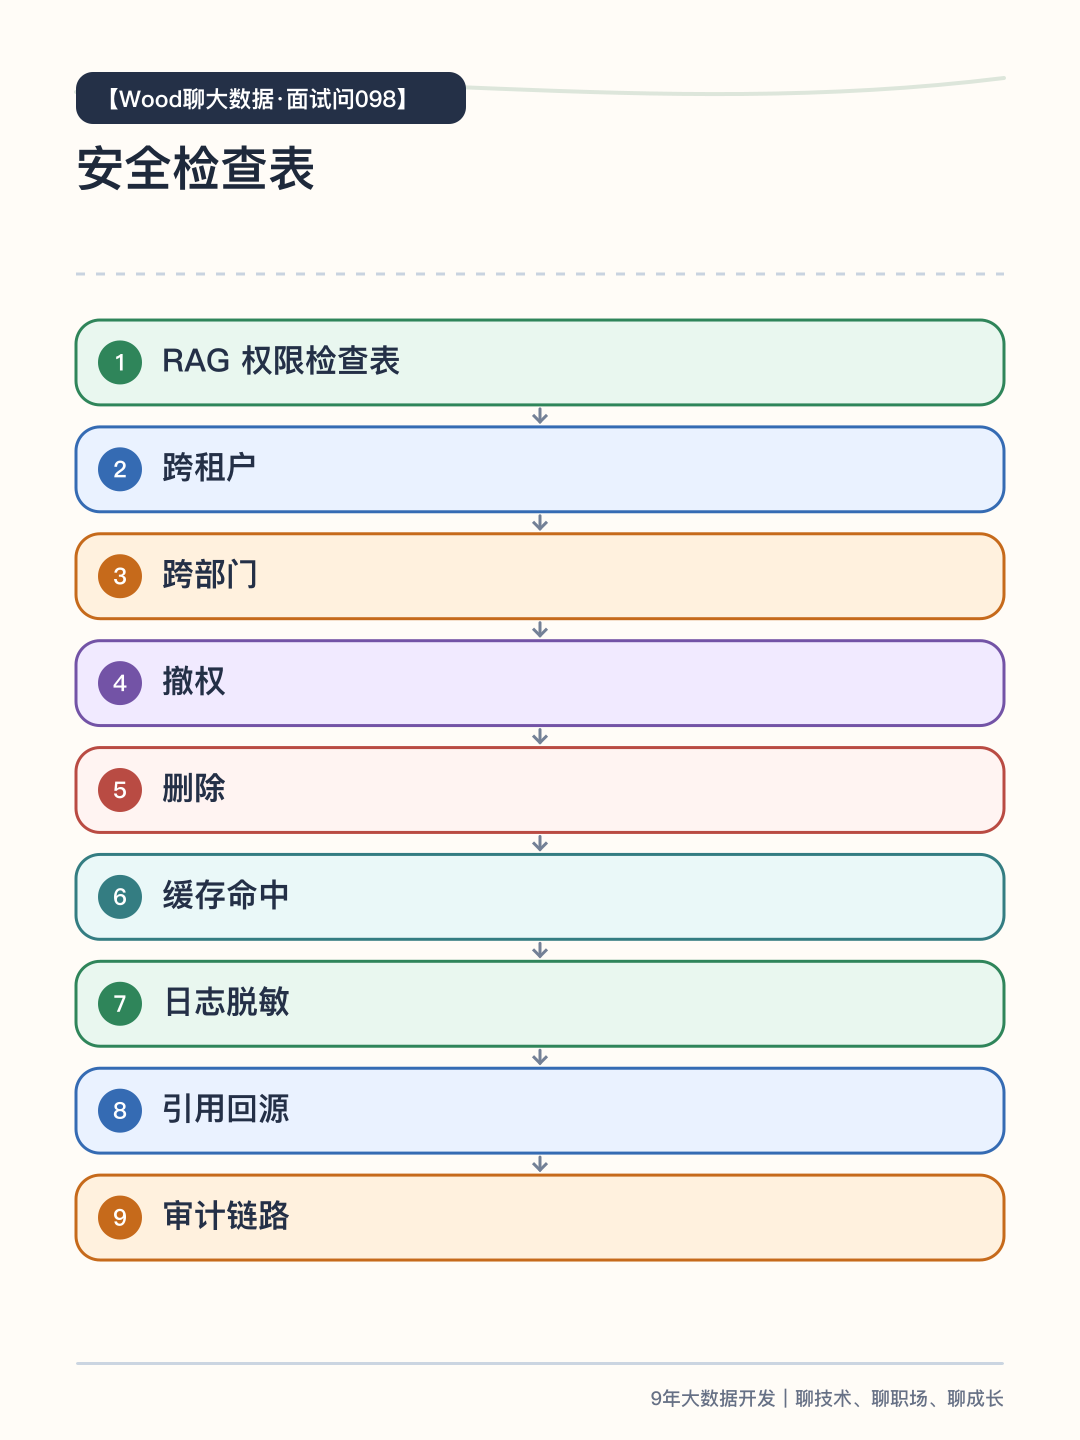
怎么验证权限真的有效?
建立跨租户、跨部门、撤权、删除、缓存命中、引用回源等负向测试。对每次回答保留可审计链路:谁发起、采用哪份权限、召回哪些资源、最终引用什么文档。
权限测试不能只看正常用户能否搜到,还要证明不该看到的人确实搜不到。