AI 特征平台如何保证训练和推理一致?
面试怎么回答
我通常从定义、时间、计算和服务四层保证一致。定义层统一实体、口径和版本;时间层用 Point-in-Time Join 防止未来数据泄漏;计算层复用转换定义或做双实现回放比对;服务层监控物化延迟、新鲜度、空值和离在线差异。Feature Store 的价值不是存特征,而是让训练时看到的历史状态和推理时读取的在线状态遵守同一份契约。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一个用户的“近 7 天活跃次数”,训练样本里是 12,线上推理时却是 8。模型、代码都没改,效果为什么还是掉了?
这类问题通常不在算法,而在特征链路:训练和推理看到的不是同一套定义、同一个时间切面、同一种数据新鲜度。
很多人会回答“建设 Feature Store,把特征统一管理起来”。方向没错,但 Feature Store 不是多建一张表,也不是加一个 Redis 就结束了。
真正要保证的是四个一致:定义一致、时间一致、计算一致、服务一致。
第一层:定义一致,先让同名特征只有一种含义
每个特征至少要登记实体主键、数据类型、业务口径、时间窗口、过滤条件、负责人和版本。user_active_7d 如果一边按自然日、一边按最近 168 小时计算,即使名字相同也不是同一个特征。
定义应当代码化和版本化。训练任务与在线服务引用同一个特征标识和版本,而不是各自复制一段 SQL 或 Python。变更窗口、空值、枚举和去重逻辑时,要能知道哪些模型会受影响。
第二层:时间一致,避免把未来信息带回训练集
训练样本不能直接拿“用户当前最新特征”回填历史标签。正确做法是 Point-in-Time Join:对样本发生时间 t,只关联 t 之前已经产生且仍在有效期内的特征。
这里要区分事件时间、处理时间和入库时间。迟到事件如果在标签发生后才到达,是否允许回补训练集,也要形成明确规则。否则离线 AUC 很漂亮,上线后却无法复现。
第三层:计算一致,减少离线与在线两套逻辑
离线链路常用 Spark SQL,在线链路可能用 Flink、Java 或 Python。语言不同并不可怕,可怕的是窗口边界、时区、去重键、空值和精度规则不一致。
常见做法有两类:一类是尽量复用同一份转换定义,由不同执行引擎运行;另一类是保留双实现,但用固定样本做回放比对。重点不是追求“只能有一份代码”,而是让差异可检测、可解释。
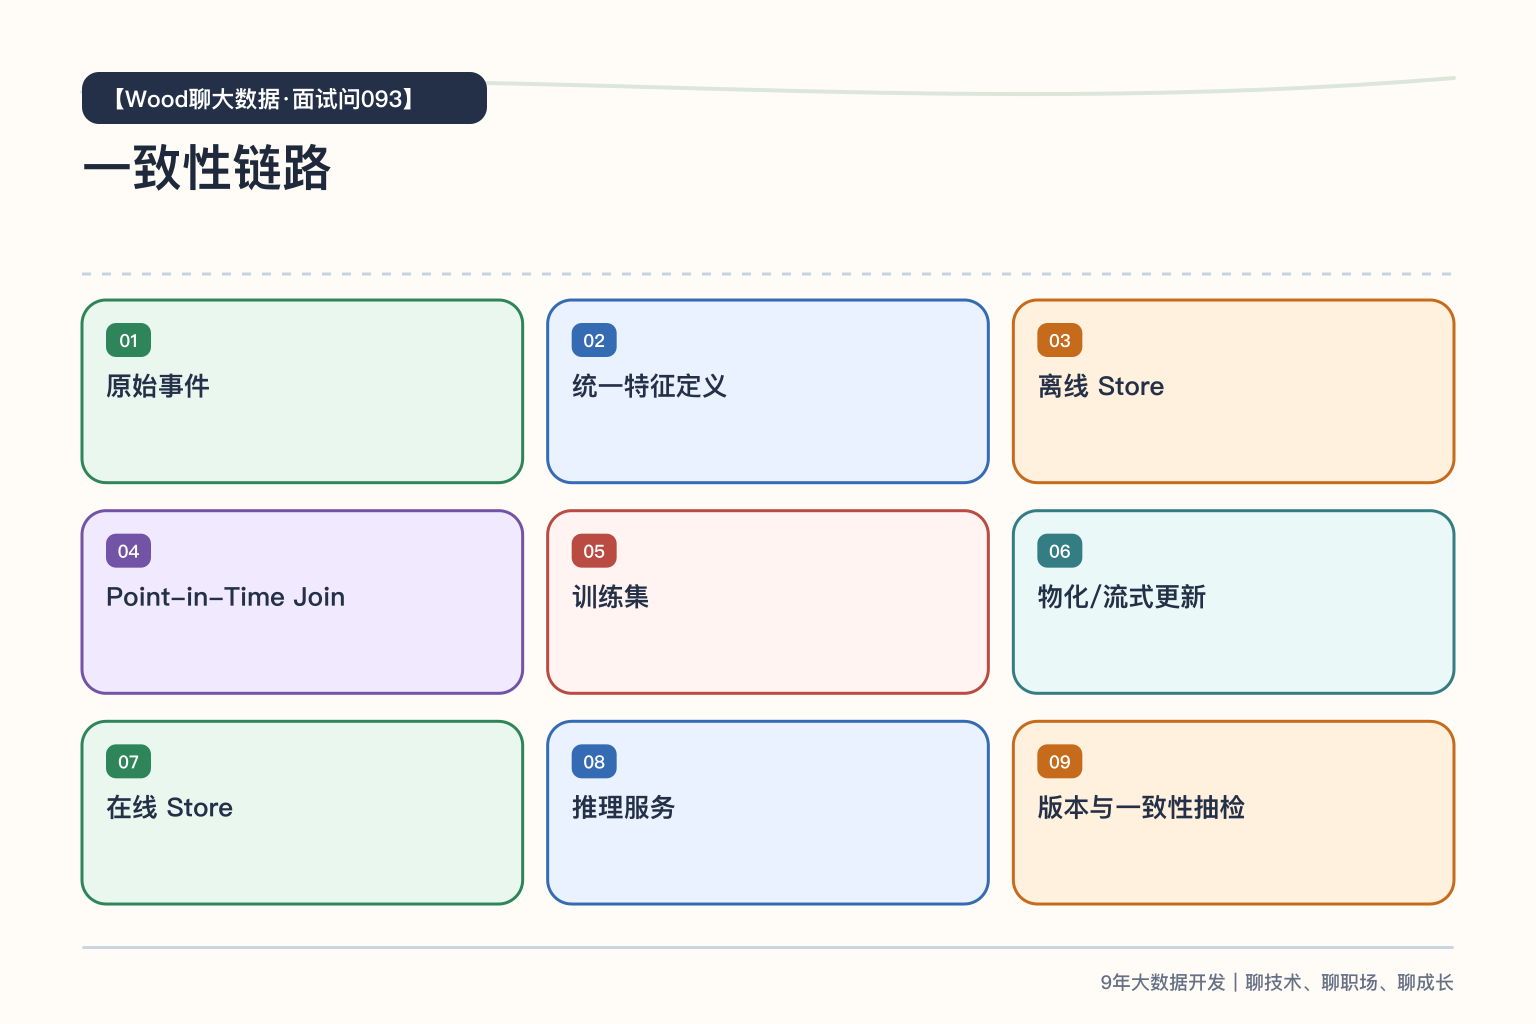
第四层:服务一致,检查新鲜度和读取语义
离线 Store 保存历史特征,支持训练和回溯;在线 Store 保存实体的最新值,支持低延迟查询。数据从离线或流式计算进入在线 Store 时,要监控 Materialization 延迟、版本、覆盖率和 TTL。
线上不能只监控接口延迟,还要监控特征新鲜度、空值率、默认值占比和离在线样本差异。接口 5 毫秒返回一个过期值,依然是错误结果。
一个典型场景
某推荐模型训练时,用户画像通过日批任务在凌晨更新;线上则读取实时累计值。离线使用完整自然日,在线使用滚动 24 小时,两边特征分布持续偏移。
最初大家怀疑模型版本,后来按实体抽样比对,才发现窗口定义和更新时间都不同。普通表级行数检查没有报错,因为两张表都“有数据”。
修复不能只补一次数据,而要统一窗口定义,为每条特征带上事件时间和版本,并建立离在线一致性抽检。