RAG 知识库如何做增量更新?
面试怎么回答
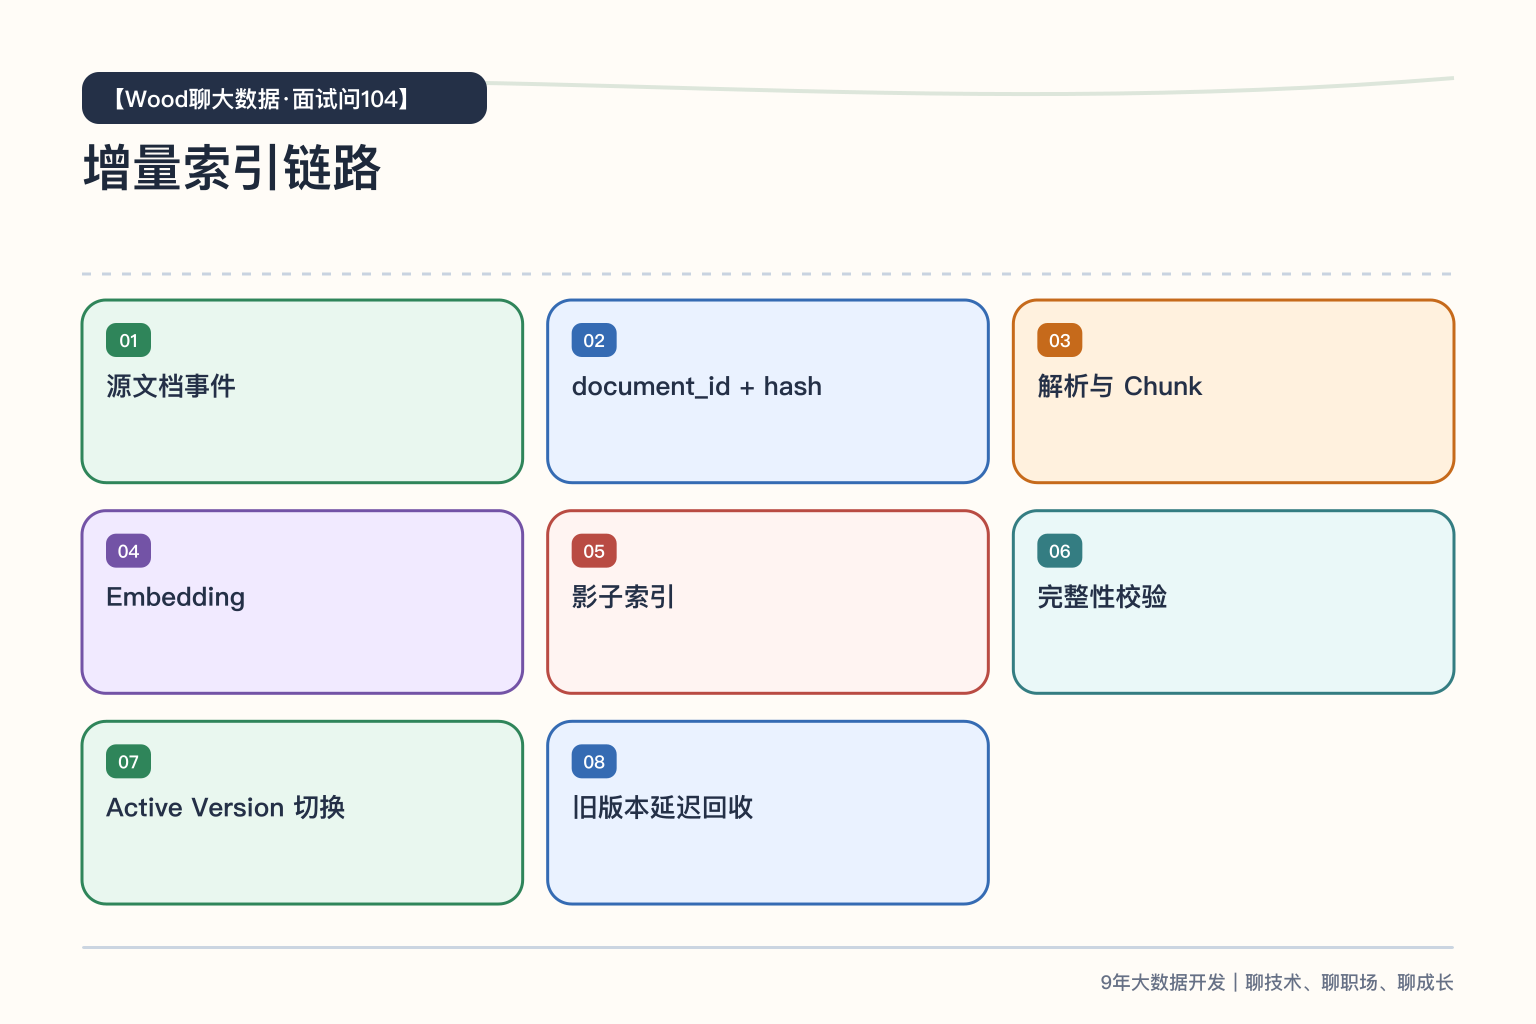
我会为文档建立稳定 ID、源版本和内容哈希,用事件或扫描识别新增、修改、删除和权限变化;Chunk 带文档版本、切分版本和 Embedding 版本。更新时先在影子版本完成解析、向量化和校验,再原子切换 Active Version,旧版本保留回滚窗口。删除与撤权先让查询不可见,再清理索引和缓存,并通过源端—索引对账保证最终一致。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
源文档上午已经修改,下午问答系统仍引用旧制度;搜索索引里甚至同时存在新旧两个版本。
RAG 的增量更新,难点不是重新生成一个 Embedding,而是让解析、Chunk、向量、Metadata 和删除状态保持一致。
要把一次文档变更设计成可追踪、可幂等、可切换、可回滚的索引事务。
第一步:可靠识别文档变化
来源可以是 CDC、对象存储事件、Webhook 或定时扫描。无论哪种方式,都要为文档建立稳定 document_id,记录源版本、更新时间、内容哈希和删除状态。
只比较文件名不够,同名文件可能内容变化;只比较更新时间也不稳,迁移或回灌可能改写时间。内容哈希可以帮助跳过无效重建,但权限或 Metadata 变化即使正文没变,也必须传播。
第二步:让 Chunk 具备稳定身份
重新切分文档后,如果每个 Chunk 都随机生成 ID,哪怕只改一段,也可能造成整篇删除重建。更好的做法是结合文档 ID、结构路径、内容指纹和切分版本生成稳定标识。
但稳定 ID 不是绝对不变。Chunking 规则或 Embedding 模型升级时,应明确产生新的索引版本,而不是把不同空间的向量混在一起。
增量任务还要保存事件偏移和处理批次,同一事件重复投递时保持幂等;某个 Chunk 失败时,只重试失败范围,而不是让整篇文档反复重建。
第三步:采用版本化写入和原子切换
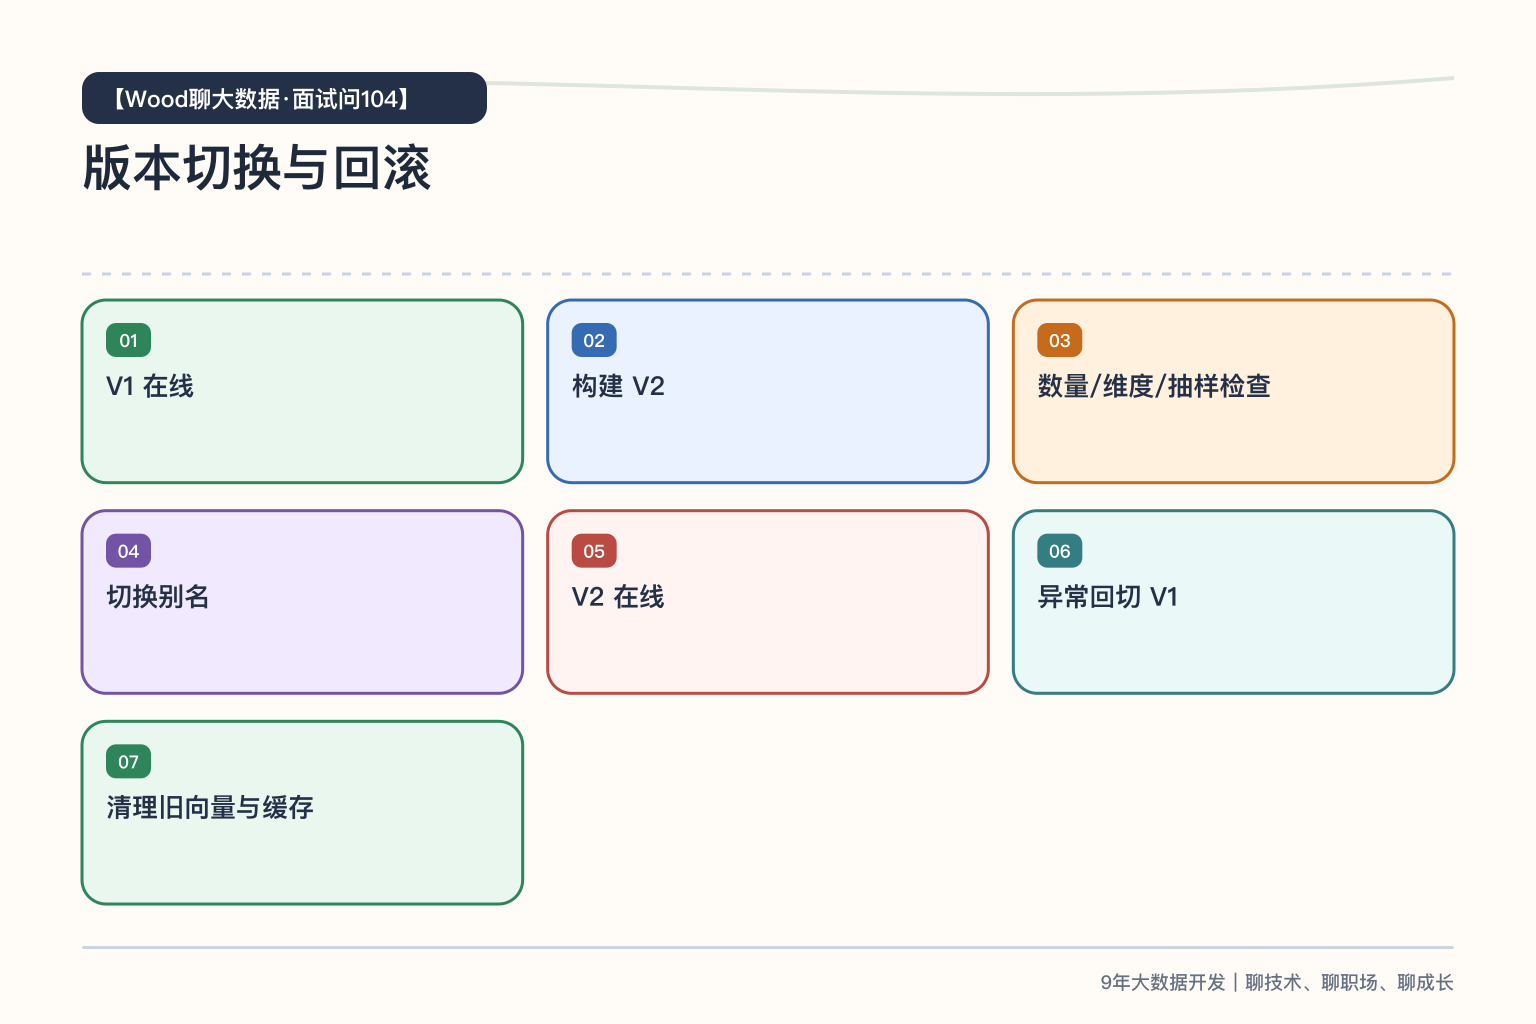
更新可以先写入新版本 Chunk 和向量,完成数量、解析状态、Embedding 维度和抽样检索检查后,再把文档的 Active Version 指向新版本。
旧版本不要立即物理删除,可保留短暂回滚窗口。查询必须只读取 Active Version,避免构建过程中同时召回新旧内容。
第四步:删除和撤权必须优先处理
新增延迟会影响新鲜度,删除延迟可能造成越权。文档删除、权限撤销、保密级别变化时,应先让查询不可见,再异步清理向量、关键词索引、缓存和评测副本。
为每个下游记录删除传播状态和 SLA,定期做源系统与索引的反向对账:源端不存在或已禁用的文档,检索端不能继续活跃。
一个典型反例
系统先删除旧 Chunk,再计算新向量。Embedding 服务短暂失败后,新版本没有写完,旧版本已经消失,知识库出现空窗。
如果反过来直接新增,又不做版本过滤,就会同时召回两份内容。正确做法是影子构建、完整性校验、原子切换,最后延迟回收旧版本。