Embedding 模型怎么选?
面试怎么回答
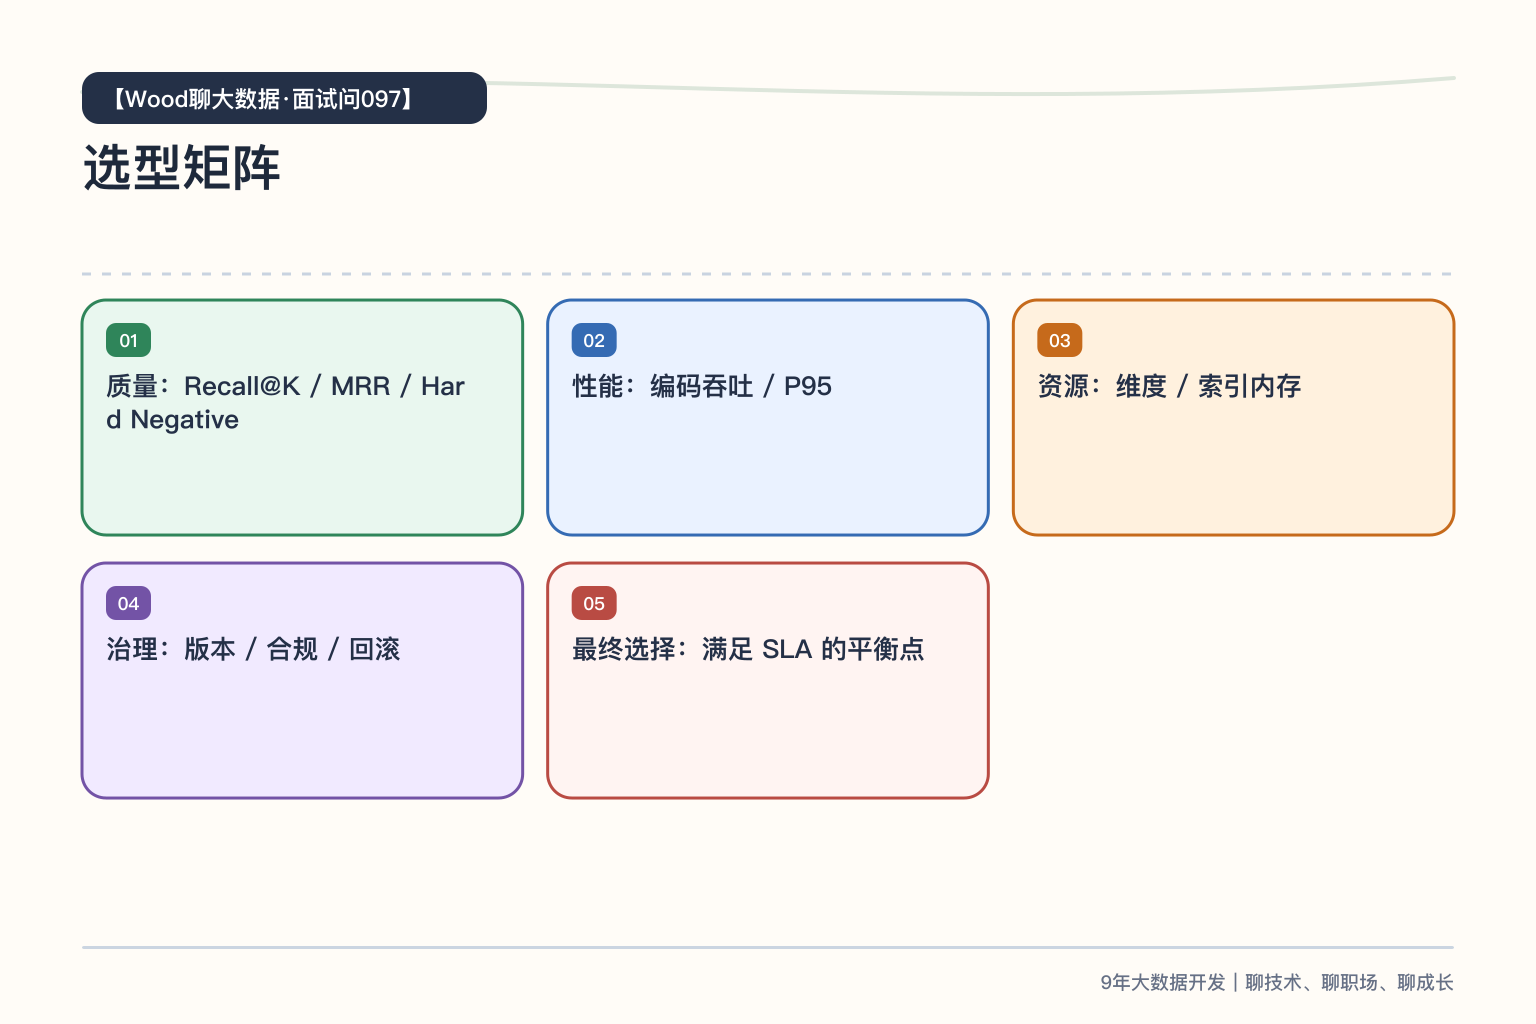
我会先明确语种、领域、Query 和 Document 长度、检索对象,再从真实日志建立带 Hard Negative 的评测集,用 Recall@K、MRR、NDCG 分桶比较。然后把维度、编码吞吐、索引内存、P95、成本和合规一起纳入。模型升级时记录版本并通过影子索引或双写回放,验证后再切流。Embedding 选型不是看榜单,而是在自己的数据和 SLA 下找质量与成本的平衡点。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
模型榜单第一,放进自己的知识库却不一定最好。
因为 Embedding 选型不是比较一个公开分数,而是看它能否理解你的语言、领域、查询长度和检索任务,同时满足延迟与成本约束。
先定义业务评测集和目标,再比较召回质量、向量成本、工程兼容和生命周期;不要先选模型,再为结果找理由。
第一步:明确检索任务
同样是文本向量,语义相似、问答检索、代码搜索、商品匹配和多语言检索的目标不同。Query 往往很短,Document 可能很长;有些模型还要求为查询和文档添加不同前缀。
先写清数据语言、领域词、文本长度、是否跨语言、是否需要图片或代码,以及最终是召回 Chunk、商品还是用户。任务定义不清,公开 Benchmark 再高也无法直接迁移。
第二步:建设自己的 Ground Truth
从真实搜索日志、客服问题、专家样例中整理查询—相关文档对,并加入容易混淆的 Hard Negative。例如“退款时效”和“退款条件”语义接近,但不是同一个答案。
评估 Recall@K、MRR、NDCG 等指标,同时按领域、长度、语言和难度分桶。还要在同一套 Chunk、过滤和重排条件下比较,否则模型差异会被链路变化污染。
第三步:比较工程成本
向量维度越高,通常存储、网络、索引内存和距离计算成本越高,但维度并不等于效果。要测批量编码吞吐、单条延迟、向量大小、索引构建时间和检索 P95。
如果使用外部 API,还要考虑费用、限流、数据合规和可用性;如果自部署,则要评估 GPU/CPU、模型加载、扩缩容和升级成本。
第四步:设计版本和重建策略
Embedding 模型升级后,新旧向量通常不应直接混在同一相似度空间里。索引需要记录 embedding_model、model_version、dimension 和生成时间。
上线可以采用影子索引或双写:新模型离线全量编码,回放真实 Query,对比质量和延迟,再逐步切流。还要准备回滚,因为重建数百万甚至数亿向量不是一个即时操作。
一个典型误区
团队只抽十几个问题肉眼测试,发现新模型回答“看起来更相关”就替换。上线后英文缩写和内部产品名召回下降,却很久没有被发现。
根因不是模型一定更差,而是评测样本没有覆盖真实分布,也没有按业务类型分桶。后来补齐专业词、短查询和无答案样本,才得到可解释的选择。