AI 应用的数据质量怎么保障?
面试怎么回答
AI 应用的数据质量我会分五层:源文档检查权威性、时效、权限和敏感信息;处理层检查解析、切分、Embedding 与多索引版本一致;检索层用标准证据集评估召回和排序;生成层评估事实、引用、拒答和安全;反馈层保存全链路日志并做根因闭环。最高优先级是权限和高风险错误,同时要避免把噪声反馈直接回灌成训练数据。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一个模型和提示词,昨天回答正确,今天突然引用了过期制度。模型没有升级,真正变化的是知识库里混入了旧版本文档。
AI 应用的质量问题,很多时候仍然是数据质量问题,只是链路从“表和指标”扩展到了“文档、Chunk、检索上下文和反馈数据”。
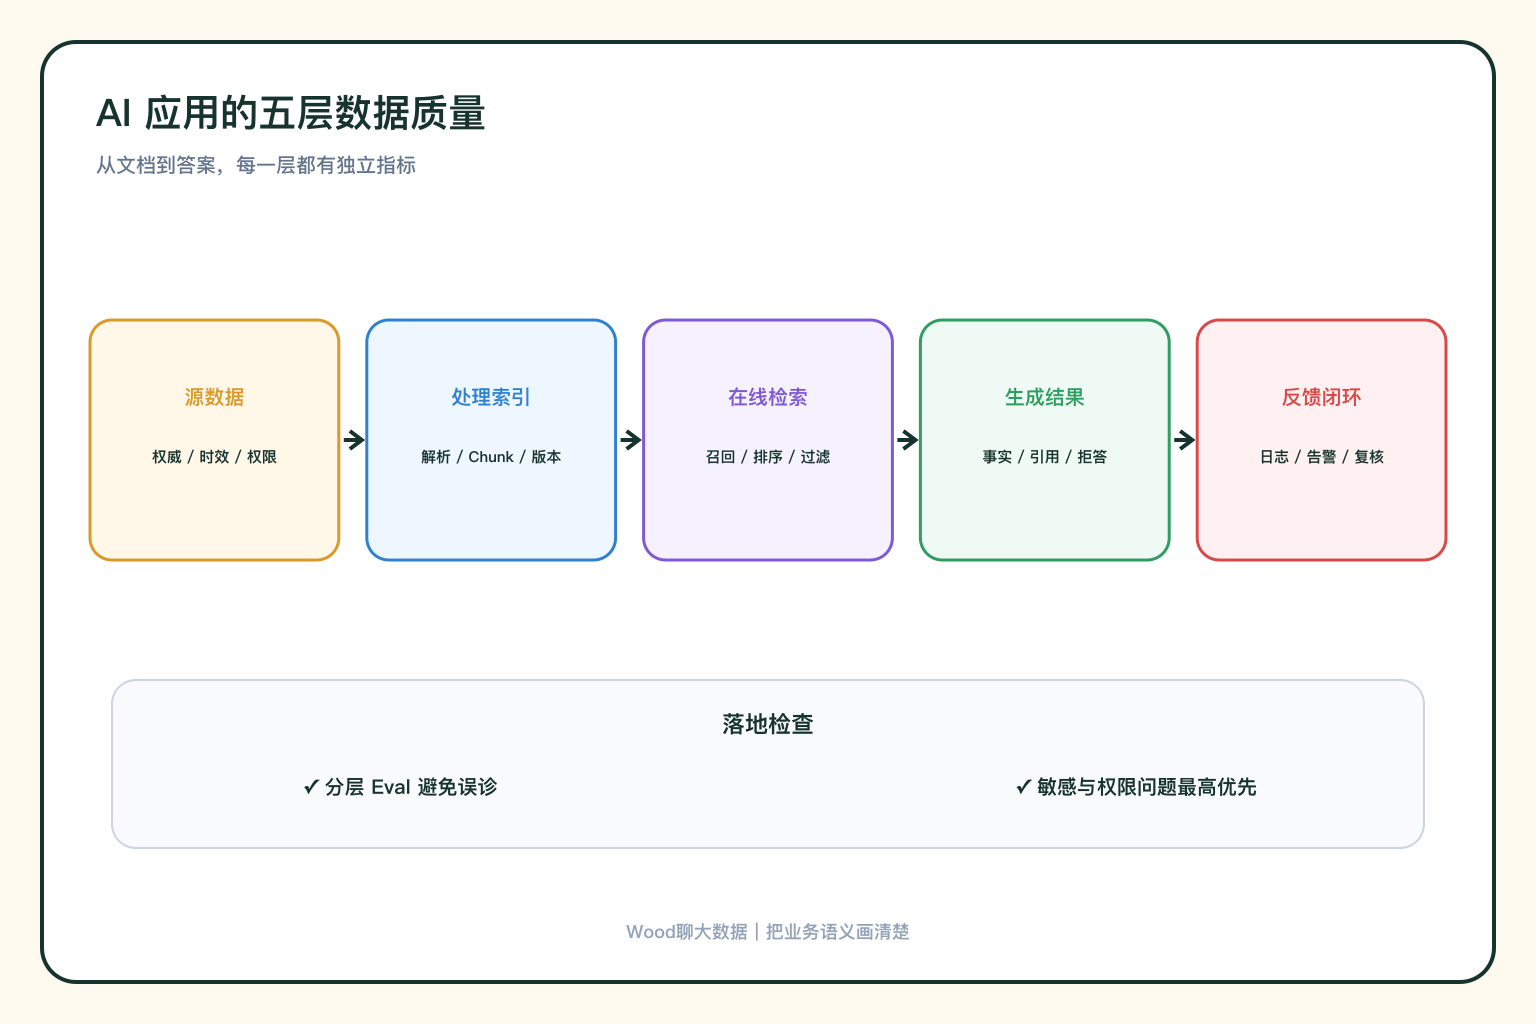
要保障 AI 应用质量,不能只检查输入文件是否存在,而要覆盖源数据、处理索引、在线检索、生成结果和反馈闭环五层。
第一层:源数据是否可信
先明确权威来源、责任人、更新频率、有效期和权限范围。重复文档、冲突版本、扫描件 OCR 错误、缺页和未脱敏内容,都可能被模型放大成答案问题。
核心检查包括:完整性、唯一性、时效性、一致性、敏感信息和权限标签。对于制度类资料,应有生效和失效时间,而不是只看最后修改时间。
第二层:解析和索引是否一致
文档采集成功,不代表内容可检索。要检查解析文本是否为空、标题层级是否保留、表格是否错位、Chunk 是否过短或过长、Embedding 是否成功,以及关键词索引和向量索引是否处于同一文档版本。
索引链路最好保存数据血缘:一个答案引用的 Chunk 来自哪份文档、哪个版本、哪次解析任务、哪个切分与 Embedding 版本。没有这条血缘,问题只能靠猜。
第三层:检索结果是否正确
检索质量不能只看“有没有结果”。需要一组问题—标准证据对,评估 Recall@K、MRR、NDCG、无结果率、重复结果率和权限泄漏率。
还要覆盖数字、否定条件、专有名词、跨段落问题、多语言和无答案问题。只用几个顺利 Demo,很容易高估真实效果。
第四层:生成是否忠实、可控
最终答案要分别检查事实正确、证据支持、引用对应、格式合规、敏感内容和拒答行为。答案语言流畅,不等于有依据。
当检索证据不足或互相冲突时,系统应允许回答“不确定”并返回需要补充的信息,而不是强迫模型给出确定结论。
第五层:反馈能否形成闭环
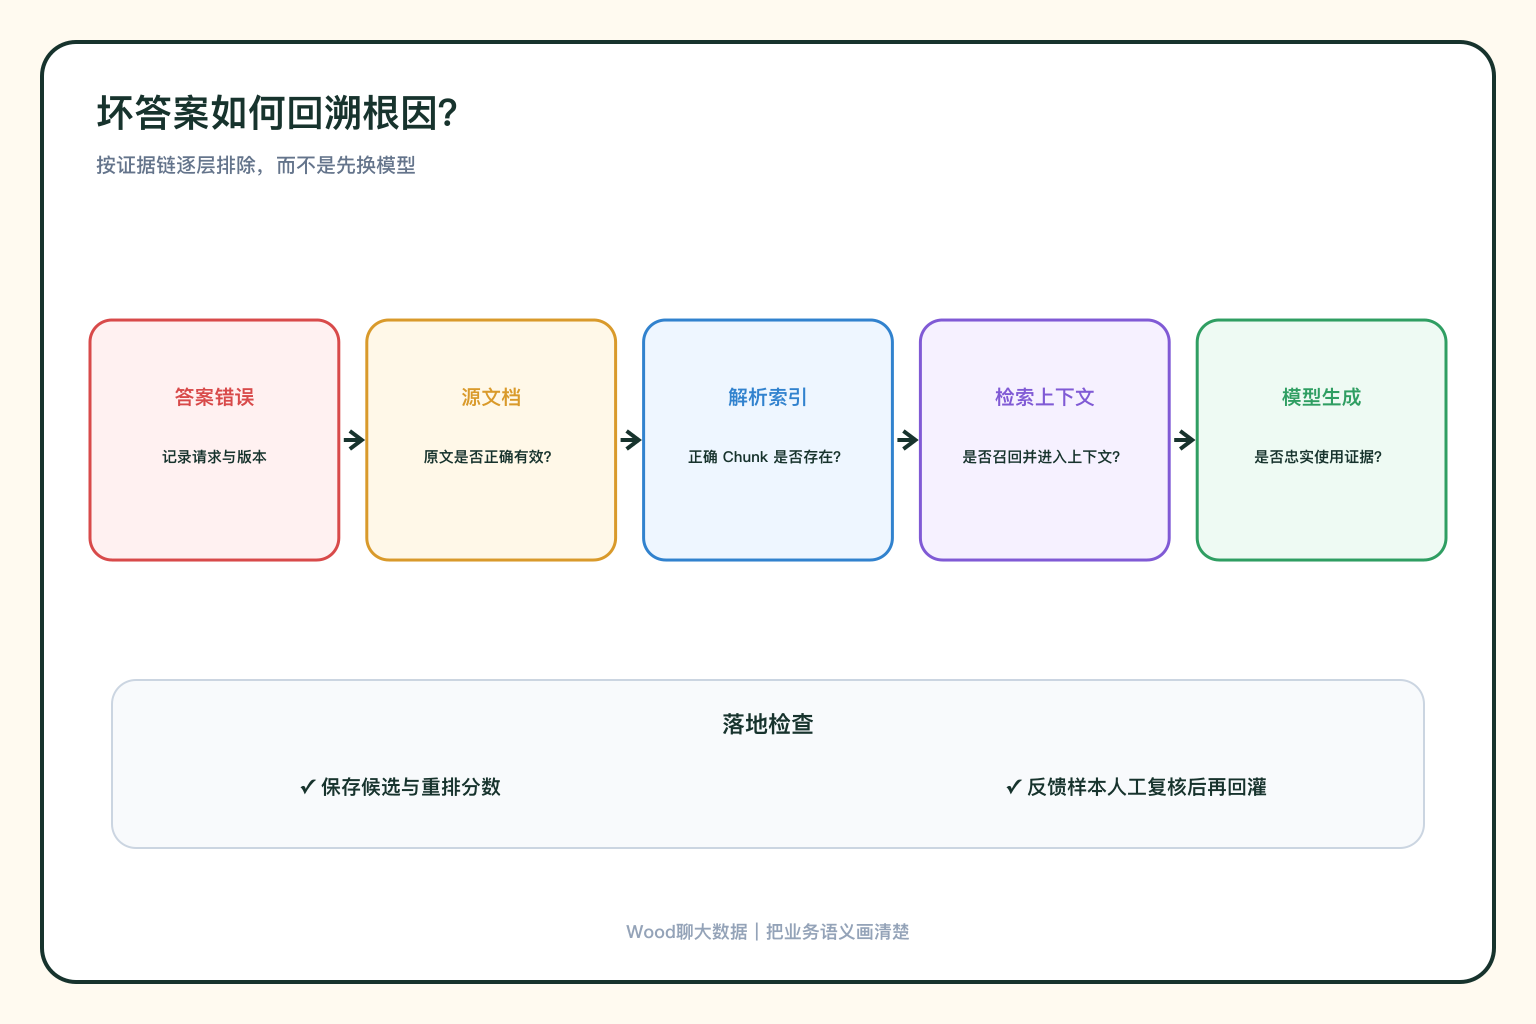
线上要记录请求版本、检索候选、过滤条件、重排结果、最终上下文、模型配置、引用和用户反馈。发生坏答案后按顺序判断:源文档错了吗?解析丢了吗?正确 Chunk 在索引里吗?召回了吗?进入上下文了吗?模型是否忠实使用?
反馈数据本身也要治理。用户点赞不一定代表事实正确,投诉样本可能偏向极端场景,自动生成的训练数据还可能把模型错误再次写回系统。
告警怎么分级?
权限泄漏、敏感信息和错误高风险建议属于高优先级;权威文档更新未生效、索引版本错乱属于链路故障;相关性下降和成本上升可以按趋势治理。每类告警要有责任人、影响范围、降级方案和复核动作。