大模型应用的可观测性怎么设计?
面试怎么回答
我会用统一 Trace 串联检索、重排、模型、工具和后处理;Metrics 监控错误率、长尾延迟、Token、缓存、成本和各阶段数量;Logs 保存带版本的诊断证据,并做好脱敏与采样;质量层把低评分、追问、工具失败和风险样本回流到 Evals。核心是既能回答“哪里慢、哪里错”,也能回答“为什么质量变差、影响哪些场景”。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
用户只反馈一句“今天回答变差了”,传统监控却显示接口成功率 99.9%、CPU 和内存都正常。
大模型应用的故障经常不是服务挂了,而是检索错、Prompt 变了、工具失败、模型输出漂移或成本突然上涨。
可观测性必须把一次请求拆成可关联的 Trace,并同时观察系统、模型、检索、工具、质量和成本。
第一层:Trace 还原完整调用链
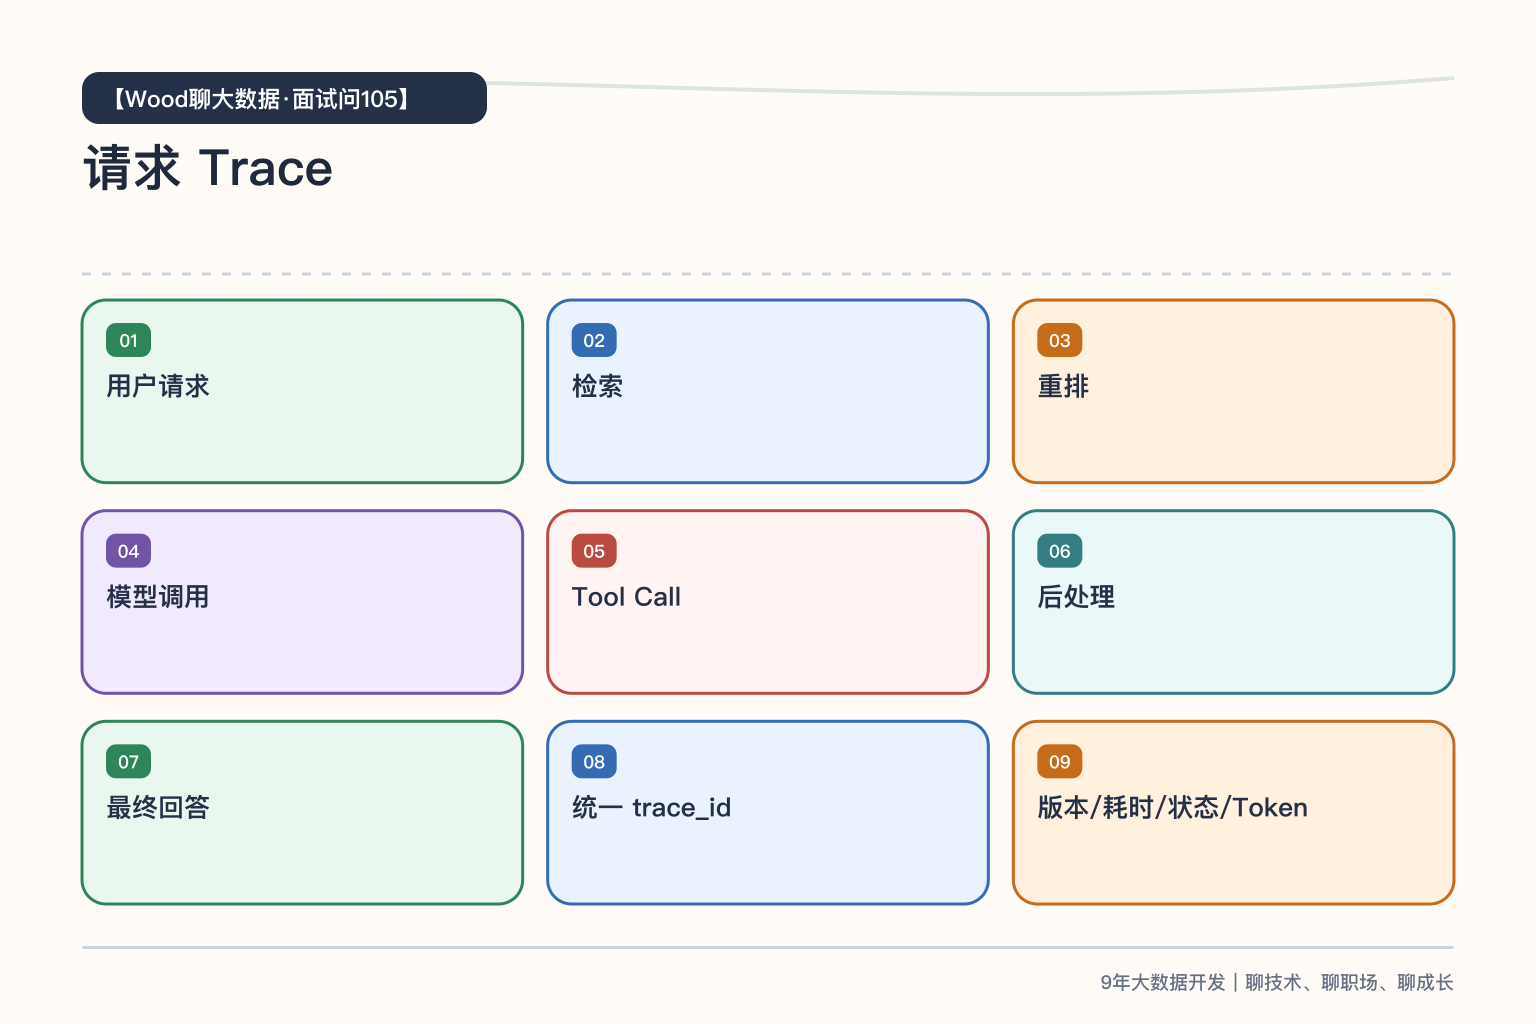
一次请求可能经过网关、检索、重排、模型、多轮 Tool Call 和后处理。每个步骤都应形成 Span,并通过统一 trace_id、session_id、request_id 串联。
Span 至少记录组件、开始结束时间、状态、重试、模型或索引版本、输入输出规模和错误类型。工具调用还要记录工具名、调用 ID 和副作用状态,便于判断是模型选错工具还是工具本身失败。
第二层:Metrics 监控容量、延迟与成本
系统指标包括 QPS、错误率、P50/P95/P99 和限流;模型指标包括输入输出 Token、缓存命中、首 Token 延迟、完成原因和单位请求成本;RAG 还要记录召回数量、过滤后数量、重排耗时和无结果率。
平均值很容易掩盖长尾。指标应按应用、场景、模型、版本、租户和错误类型分组,但要控制标签基数,不能把完整问题直接做 Metric Label。
第三层:Logs 保留可诊断证据
日志需要支持从 Trace 回看 Prompt 模板版本、检索引用、工具参数摘要、模型响应和安全策略结果。但原始内容可能包含隐私和业务数据,必须做脱敏、权限、加密和保留周期控制。
生产环境不一定长期保存所有 Prompt。可以按错误、低评分、高风险和随机比例采样,把可诊断性与合规成本分开设计。
第四层:质量观测不能只靠用户点赞
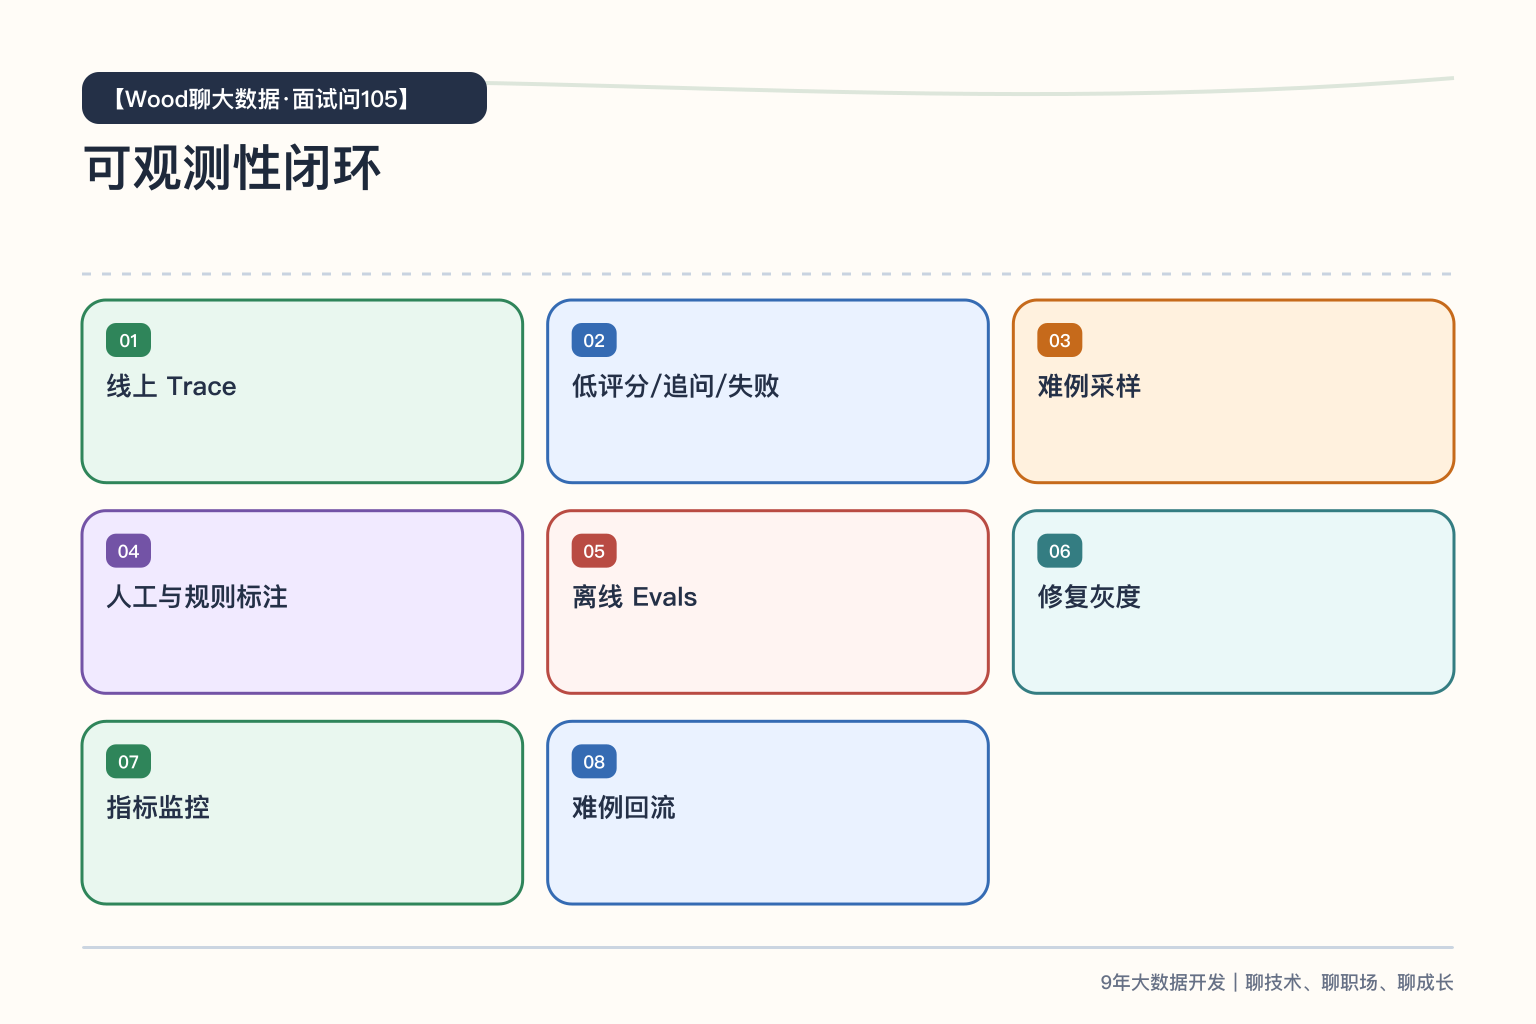
把离线 Evals 与线上采样连接起来。线上发现低评分、反复追问、转人工、引用缺失或工具失败的 Trace,进入难例池;固定版本后做回归,避免修复一个问题又破坏另一类问题。
对高风险场景,还要监控幻觉、越权、拒答和过期知识,并设置人工审计。
一个典型场景
模型接口没有报错,但某次部署后答案引用率下降。沿 Trace 对比发现检索结果正常,重排服务却因为字段改名一直降级为空,系统仍返回 200。
只看 HTTP 成功率无法发现这种“静默降级”。修复后应增加重排输入输出数量、降级次数和引用覆盖率告警,并把该 Trace 加入回归集。