RAG 的效果怎么评估?
面试怎么回答
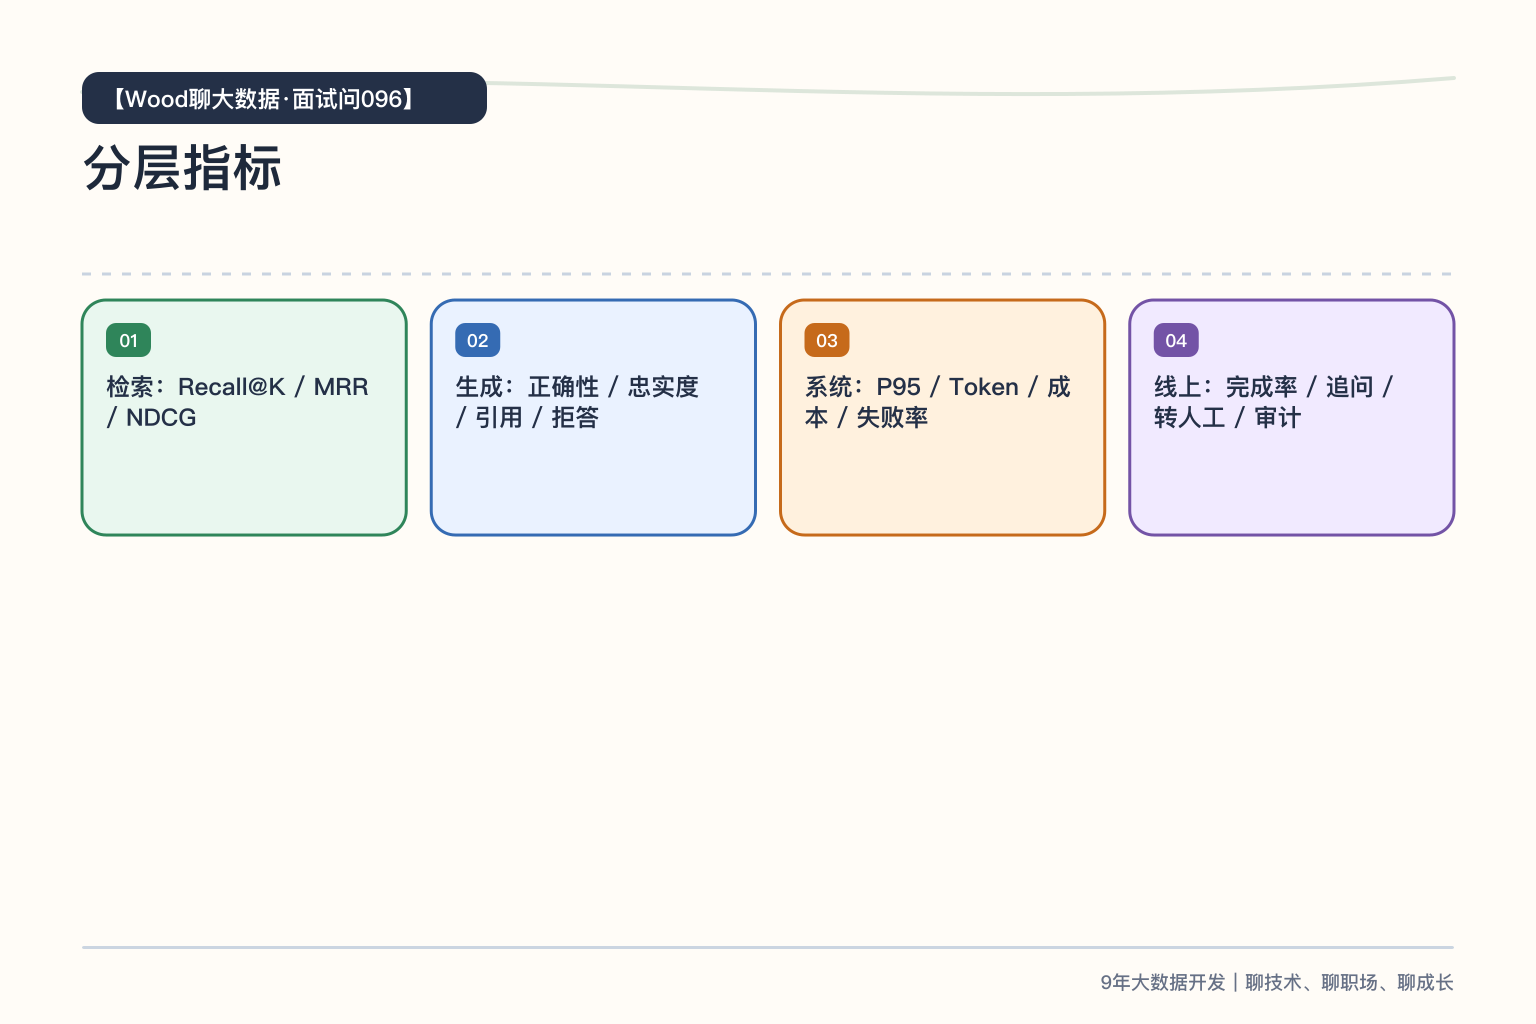
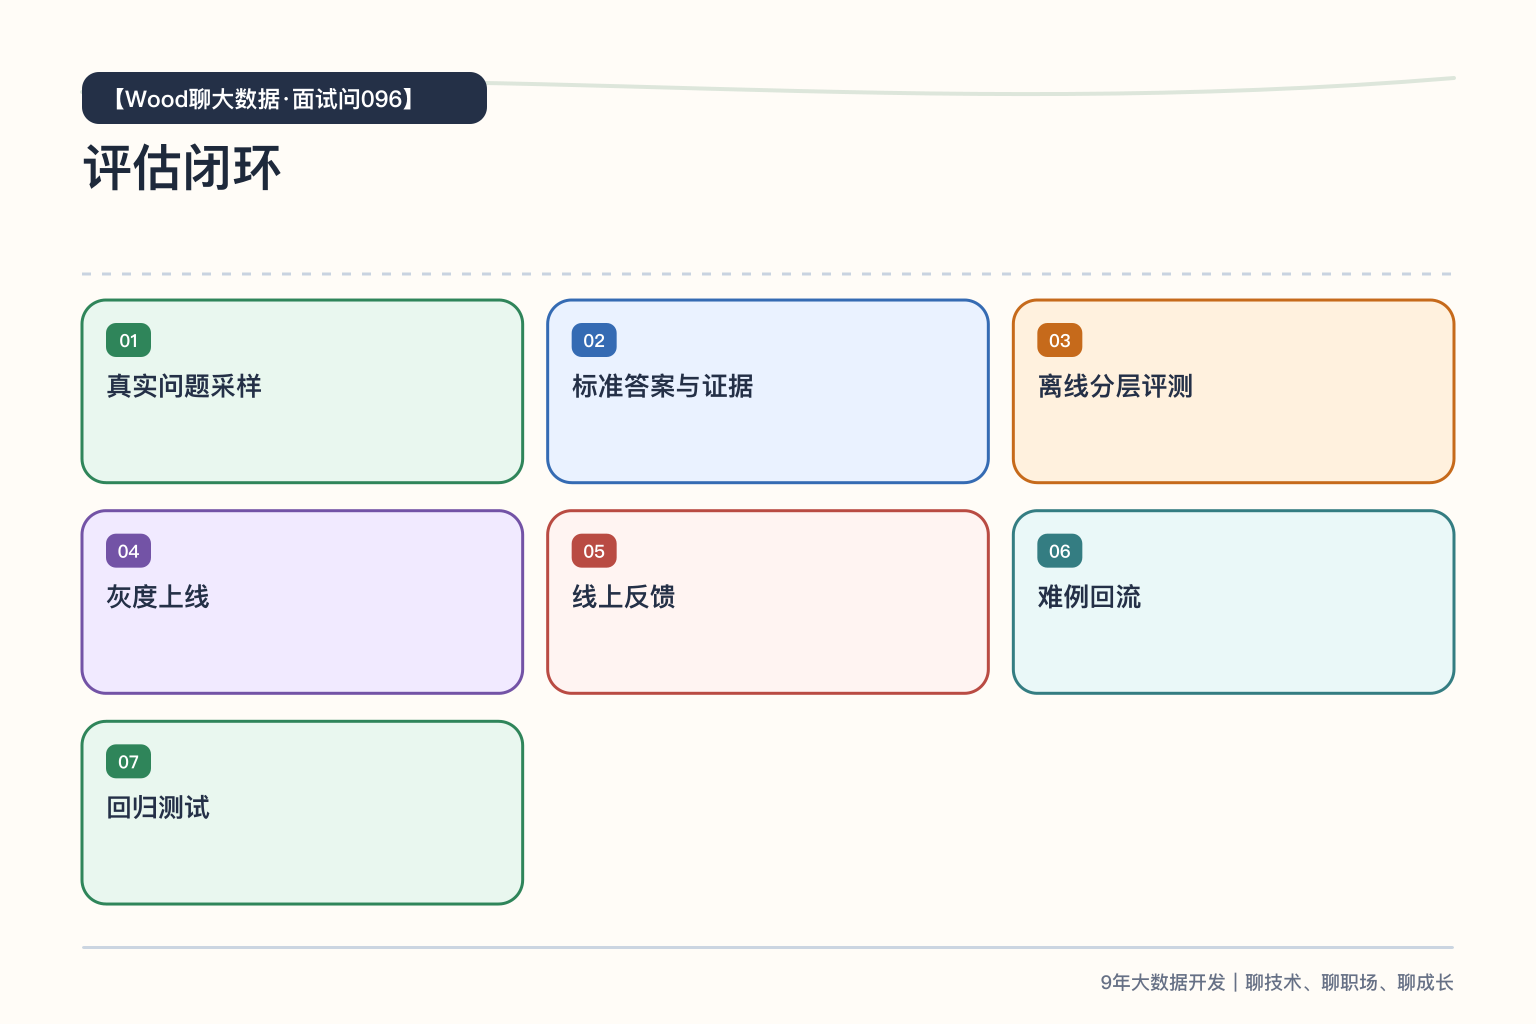
我会把 RAG 评估分成检索、生成、系统和线上四层。检索看 Recall@K、MRR、NDCG,确认正确证据是否进入候选;生成看正确性、忠实度、引用和无答案拒答;系统看延迟、Token、失败率和成本;线上看任务完成、追问、转人工和风险审计。关键是建立带标准证据的分桶评测集,每次变更做回归,再用线上反馈持续补充难例。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
“回答看起来挺像那么回事”,是最危险的 RAG 验收标准。
它既不能说明检索找对了证据,也不能说明模型忠实使用了证据,更不能代表真实用户愿意继续用。
RAG 评估必须把检索、生成和线上业务拆开:先知道错在哪一层,再决定优化 Chunk、Embedding、重排、Prompt 还是模型。
第一层:检索评估,证据有没有被找回来
先建设一份带标准证据的评测集:问题、可接受答案、相关文档或 Chunk、业务类型、难度和权限范围。
检索层可看 Recall@K、Precision@K、MRR、NDCG 等指标。对 RAG 来说,Recall@K 往往很关键:正确证据没有进入候选集,后面的模型再强也只能猜。
但只看平均值不够。要按短问题、长问题、缩写、精确编号、多跳问题、时效问题和无答案问题分桶,否则某类明显失败会被总分掩盖。
第二层:生成评估,回答是否基于证据
生成层至少检查四件事:答案正确性、对证据的忠实度、引用是否匹配、问题是否真的被回答。
可以结合规则、人工评分和模型评分。金额、日期、编号等结构化事实适合规则比对;开放问答可以用明确 Rubric 评分。模型充当裁判时要固定提示词、保留样本,并定期与人工结果校准,不能把另一个模型的意见当绝对真相。
还要专门设计“文档中没有答案”的样本,检查系统能否拒答,而不是编造一个完整答案。
第三层:系统评估,质量之外还要看代价
一套准确但响应 20 秒、成本不可控的系统仍然难以上线。系统指标包括端到端 P50/P95 延迟、检索耗时、Token 消耗、缓存命中、失败率和单位请求成本。
参数调优要看质量、延迟和成本的共同边界。例如 TopK 增大可能提高召回,却也会增加上下文噪声、Token 和生成时间。
第四层:线上评估,用户是否真的得到价值
线上关注任务完成率、追问率、转人工率、引用点击、用户反馈和留存。点赞率可以参考,但容易受交互和人群影响,不能独立代表答案正确。
对高风险场景还要采样审计权限越界、过期知识和幻觉。离线集保证可重复,线上指标验证真实分布,两者缺一不可。
一个典型反例
某次优化把检索 TopK 从 5 提到 20,Recall@20 上升了,于是团队认为效果更好。上线后回答反而更啰嗦,冲突文档增加,延迟和成本也上升。
问题在于只优化了召回,没有观察证据精度、生成忠实度和端到端体验。后来通过重排保留更少但更相关的证据,并按问题类型设置候选数量,整体结果才更稳定。