RAG 文档切分 Chunking 怎么设计?
面试怎么回答
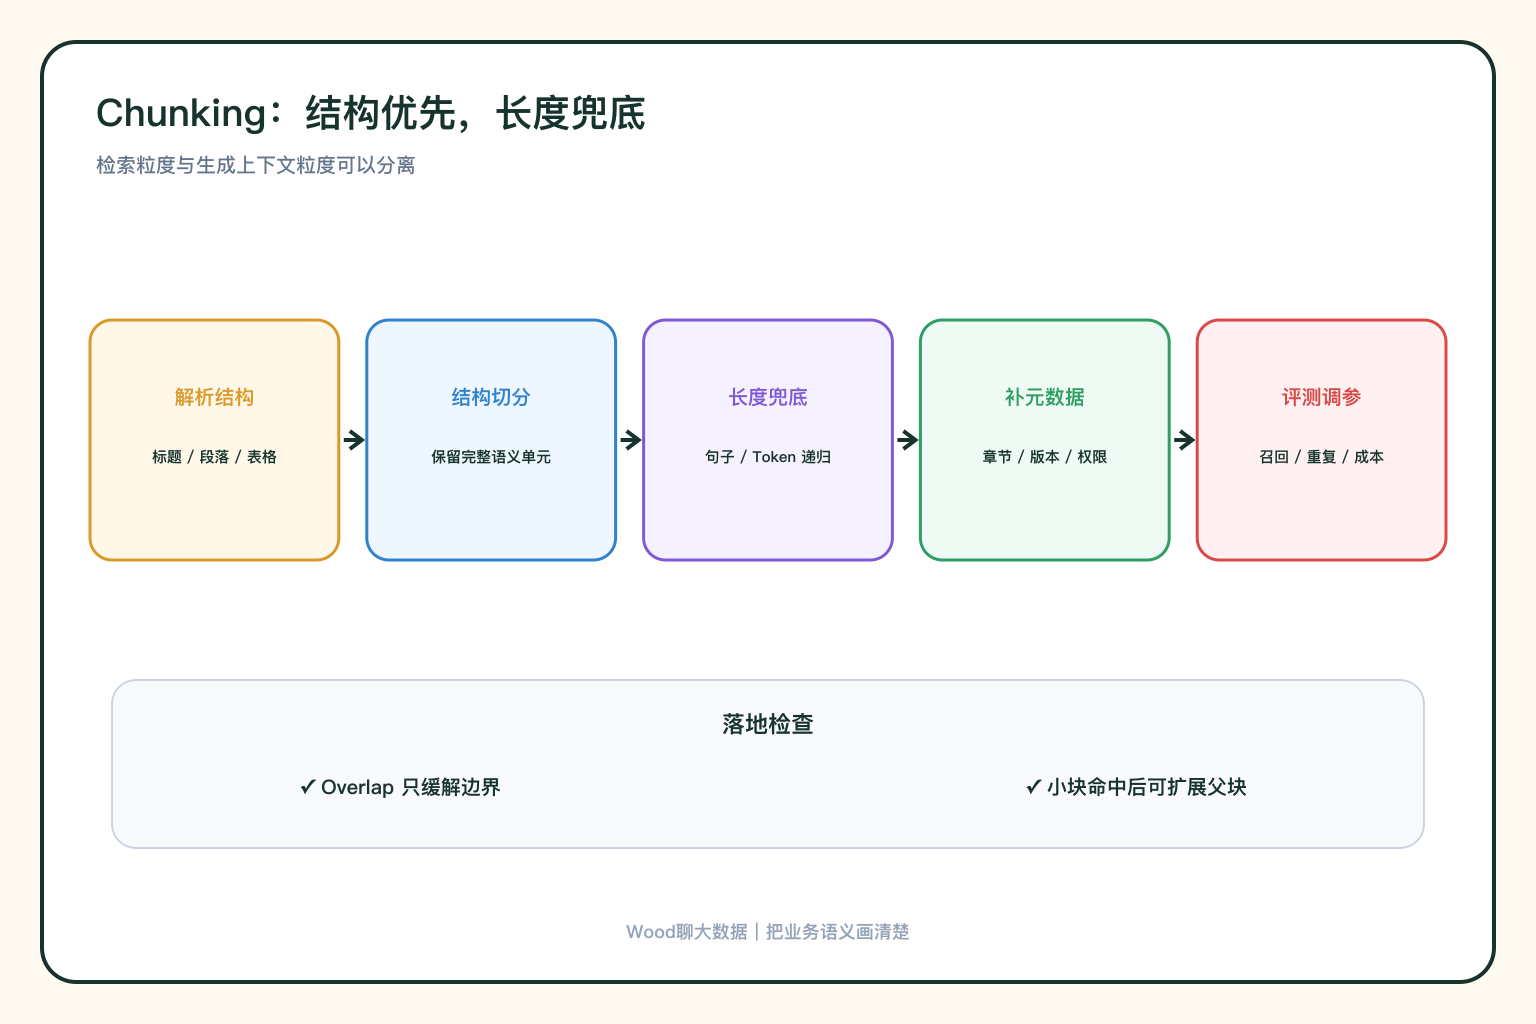
Chunking 要在语义完整、检索精度和 Token 成本之间平衡。我会优先按标题、段落、代码块和表格等结构切分,过长时再按句子或 Token 递归兜底;Overlap 只用于缓解边界丢失,不会盲目放大。每个 Chunk 保留文档版本、章节、位置和权限元数据,并用真实问题集比较 Recall@K、重复率、答案质量和成本,必要时采用小块检索、父块扩展。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
知识库已经成功入库,向量检索也能返回内容,但答案总差一点:制度的前提在上一个 Chunk,结论在下一个 Chunk;表格标题和数据又被拆开了。
问题不一定在模型,可能从切分时就把语义拆坏了。
Chunking 的目标不是把文本机械切成一样长,而是在检索粒度、语义完整性、上下文成本和更新维护之间取得平衡。
为什么太大和太小都不行?
Chunk 太大,一个向量同时表达多个主题,检索命中后还会带入大量无关内容;同时占用更多上下文 Token,降低可拼接的证据数量。
Chunk 太小,标题、条件和结论被拆散,单块信息不足以回答问题;相邻块大量重叠,还会增加索引体积,并让多个近似片段挤占 TopK。
所以不存在适用于所有资料的固定大小。平台默认值只能当起点,最终要根据文档结构、问题长度和评测结果调节。
先按结构切,再按长度兜底
对于 Markdown、网页和制度文档,优先按标题、章节、段落和列表边界切分;代码按类、函数或逻辑块;表格应尽量保留表头,并为拆开的行重复必要列名;对话则保留说话人和轮次。
当一个结构块仍然过长,再按句子或 Token 上限递归切分。不要直接每 N 个字符截断,否则容易在一句话、一个字段定义甚至一个 UTF-8 字符中间切开。
Overlap 不是越大越保险
相邻 Chunk 保留少量重叠,能降低边界信息丢失。但重叠过大会制造重复召回、增加 Embedding 和存储成本,也会让模型看到几份几乎相同的证据。
是否需要重叠,要看切分方式。机械定长切分更依赖 Overlap;如果已经按完整段落和章节切分,可以通过父标题、摘要或 Parent-Child Retrieval 补充上下文,不一定要复制大量正文。
元数据也是 Chunk 的一部分
一个可用 Chunk 至少应能追溯到:
- 文档和版本
- 标题与章节路径
- 页码或原文位置
- 业务分类和权限标签
- 切分规则与 Embedding 版本
检索时可以用小 Chunk 提高定位精度,返回模型前再扩展父章节或相邻块。这种“检索粒度”和“生成上下文粒度”分离的做法,往往比单纯放大 Chunk 更灵活。
怎么评估切分效果?
先准备一组真实问题和标准证据,至少包含精确字段、跨段落条件、表格、长文总结和无法回答的问题。比较不同切分方案的 Recall@K、重复召回率、上下文有效占比、答案正确率、延迟和成本。
如果正确证据根本没被索引,是解析或切分问题;索引里存在但没召回,是检索问题;已经召回仍答错,才继续看重排、提示词和模型。不要只用最终答案分数倒推所有问题。