向量数据库和传统数据库有什么区别?
面试怎么回答
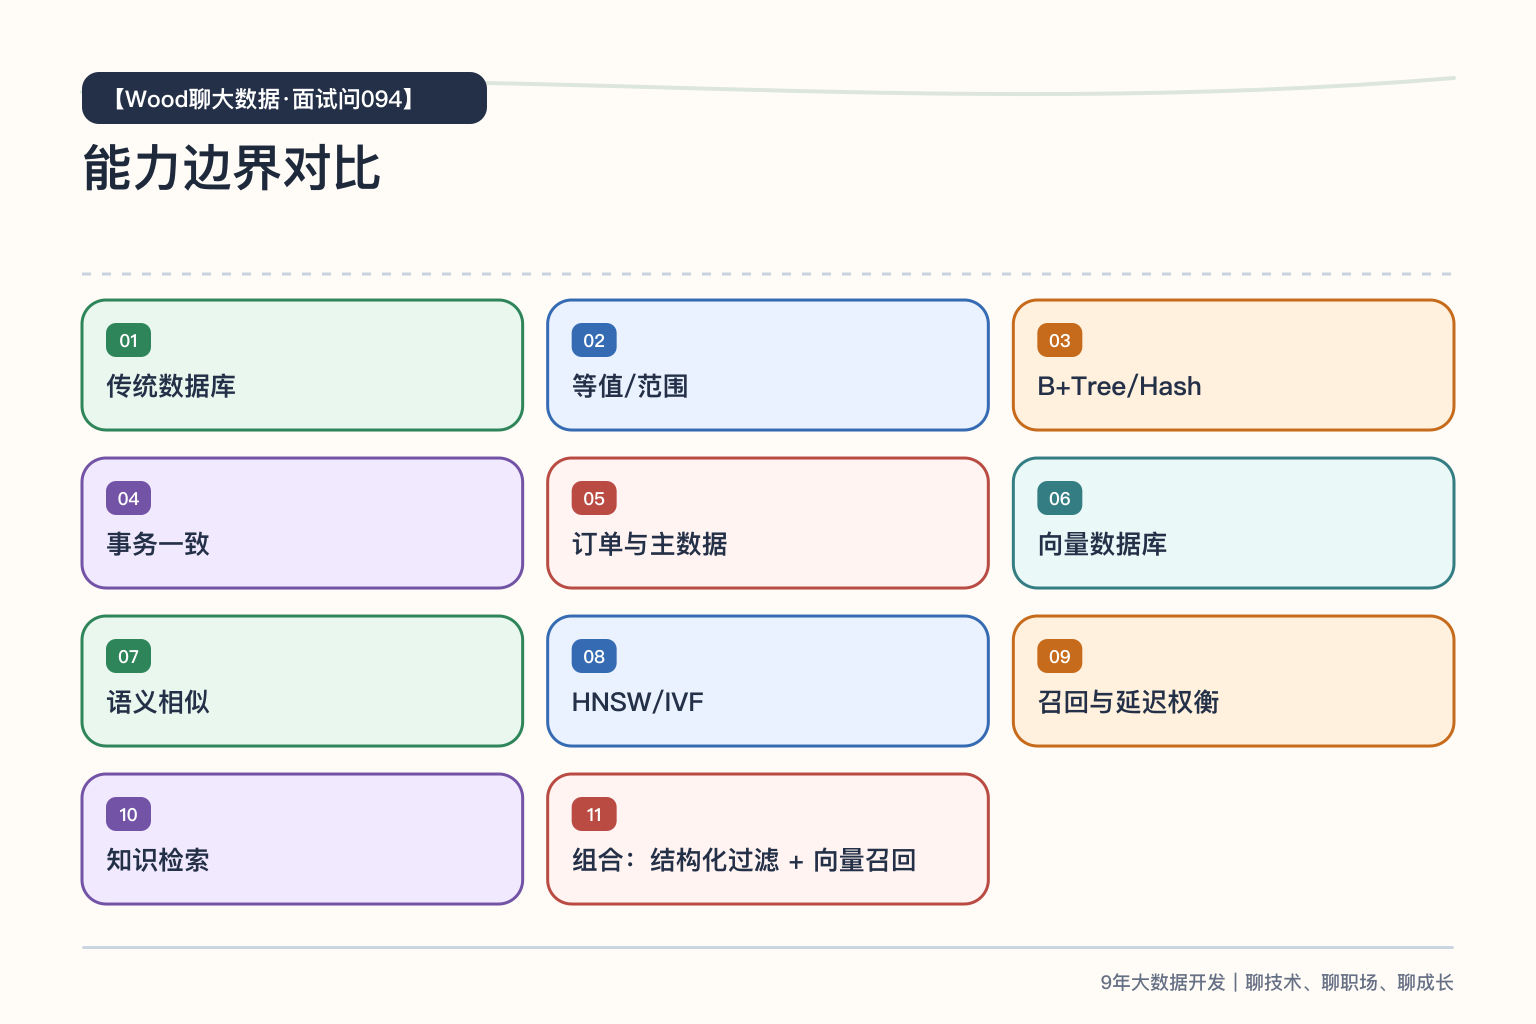
传统数据库主要做确定性条件查询和事务处理,常用 B+Tree、Hash 等索引;向量数据库主要做高维相似性检索,常用 HNSW、IVF 等近似索引,在召回率、延迟、内存和更新成本之间权衡。实际 AI 系统通常同时需要结构化 Metadata 过滤、权限控制和向量召回。数据量不大时可以先用现有数据库的向量能力,只有规模和性能确实成为瓶颈再独立建设。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
业务说:“把知识库放到 MySQL,再加一个向量字段,不就能做语义搜索了吗?”
这个方案能不能用,取决于你需要的是精确查找,还是在海量高维向量里快速找到“足够相似”的结果。
传统数据库擅长确定性条件和事务,向量数据库擅长相似性检索;生产系统通常不是二选一,而是让结构化过滤与向量召回配合。
查询目标不同
传统数据库回答的是:user_id = 1001、status = 'paid'、amount > 100。条件明确,结果强调精确、完整和一致。
向量检索回答的是:“哪些文档和这个问题语义最接近?”查询通常把文本、图片或音频编码成向量,再按照余弦相似度、内积或欧氏距离返回 TopK。它追求的是召回质量与响应速度的平衡,不一定扫描全部向量。
索引结构不同
B+Tree 适合有序字段的点查和范围查询,Hash 适合等值查找。高维空间存在“维度灾难”,普通树索引很难直接保持效率。
向量系统因此常用 HNSW、IVF、PQ 等近似最近邻索引,用少量精度换取更低延迟和更大规模。是否使用近似检索,要通过 Recall@K、P95 延迟、内存和构建成本一起评估。
数据模型不同
一个向量对象通常包含:向量、业务主键、原文或引用、租户、权限、时间、文档类型等 Metadata。检索时往往先做租户和权限过滤,再做向量召回,或者在索引内部完成过滤。
因此真正的难点不只是“存一串浮点数”,而是向量版本、Embedding 模型版本、Metadata 更新、删除传播和索引重建。
一致性诉求不同
订单扣款需要强事务语义,不能因为近似就少一笔。知识检索允许候选集合有轻微差异,但必须保证权限不越界、删除能生效、旧版本不会长期污染结果。
很多向量系统会在写入吞吐、索引可见性和检索精度之间做权衡。面试时不要把“向量数据库”描述成更快的关系数据库,它解决的是另一类访问模式。
一个典型场景
企业知识问答既要按问题语义找到相似段落,又要限制部门、租户和文档状态。只用关系库全文匹配,专业同义表达可能召回不足;只做向量搜索,又可能忽略精确编号和权限条件。
更稳妥的做法是:关系库保存权威业务状态,检索层维护文本、向量和可过滤 Metadata;请求先带上身份边界,再做关键词与向量混合召回,最后重排和回源校验。
什么时候不一定需要独立向量数据库?
数据量小、QPS 低、已有数据库原生支持向量索引,而且团队更重视运维简单时,先在现有数据库中落地完全合理。只有当规模、延迟、过滤、更新或多租户能力成为瓶颈,再拆独立检索系统。
技术选型不是看名词先进,而是看访问模式和约束。