AI Agent 的短期记忆和长期记忆怎么设计?
面试怎么回答
我会把 Agent 记忆分成短期上下文、长期知识和工作流状态。短期记忆保留当前目标、最近交互和未完成事项,过长时做结构化压缩;长期记忆保存有来源、作用域、版本和有效期的稳定事实,按需检索;工作状态单独记录工具调用、幂等键和外部 ID,保证可恢复。关键是支持权限、冲突、过期和删除,而不是无限累积聊天记录。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
把所有历史消息都塞回上下文,Agent 好像“什么都记得”;但会话一长,Token、延迟和无关信息也一起上涨。
另一种做法是每轮都只看当前问题,成本低了,却连用户刚刚确认的约束都忘了。
Agent 记忆不是一份无限增长的聊天记录,而是把当前工作状态、长期稳定事实和可检索历史分层管理。
第一层:短期记忆保存当前任务状态
短期记忆服务于正在进行的会话,通常包括最近几轮消息、当前目标、已经完成的步骤、工具返回、未解决问题和临时约束。
它的重点不是“原样保留所有内容”,而是让下一步决策不丢上下文。会话过长时,可以把已完成过程压缩成结构化摘要,保留关键 ID、结论、失败原因和下一步,而不是只生成一段泛泛总结。
短期状态还要区分用户原话、系统决策和工具事实,避免摘要把猜测改写成事实。
第二层:长期记忆保存稳定且可复用的信息
长期记忆适合保存用户偏好、业务术语、项目规则、反复验证过的事实和历史决策。它不应该自动收集每句对话,更不能把临时情绪或敏感数据无限期保存。
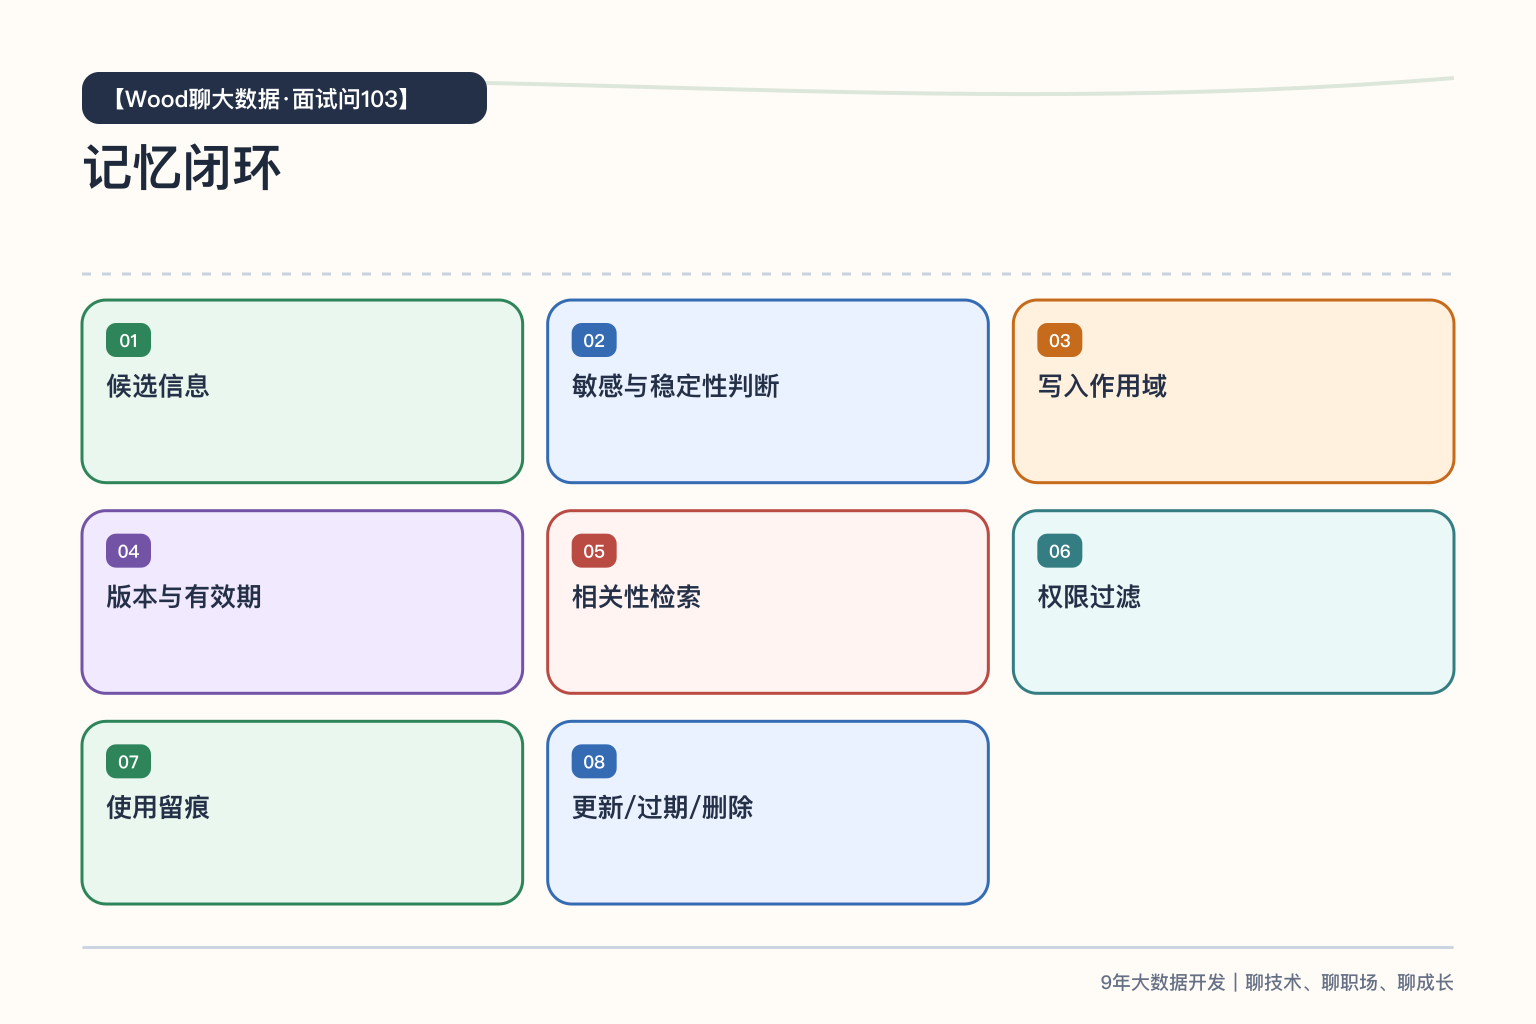
每条记忆最好带上来源、创建时间、有效期、作用域、置信度和版本。读取时先按用户、项目和权限过滤,再根据当前问题检索相关内容。
“写进去”只是开始,还要支持更新、冲突处理、过期和删除。
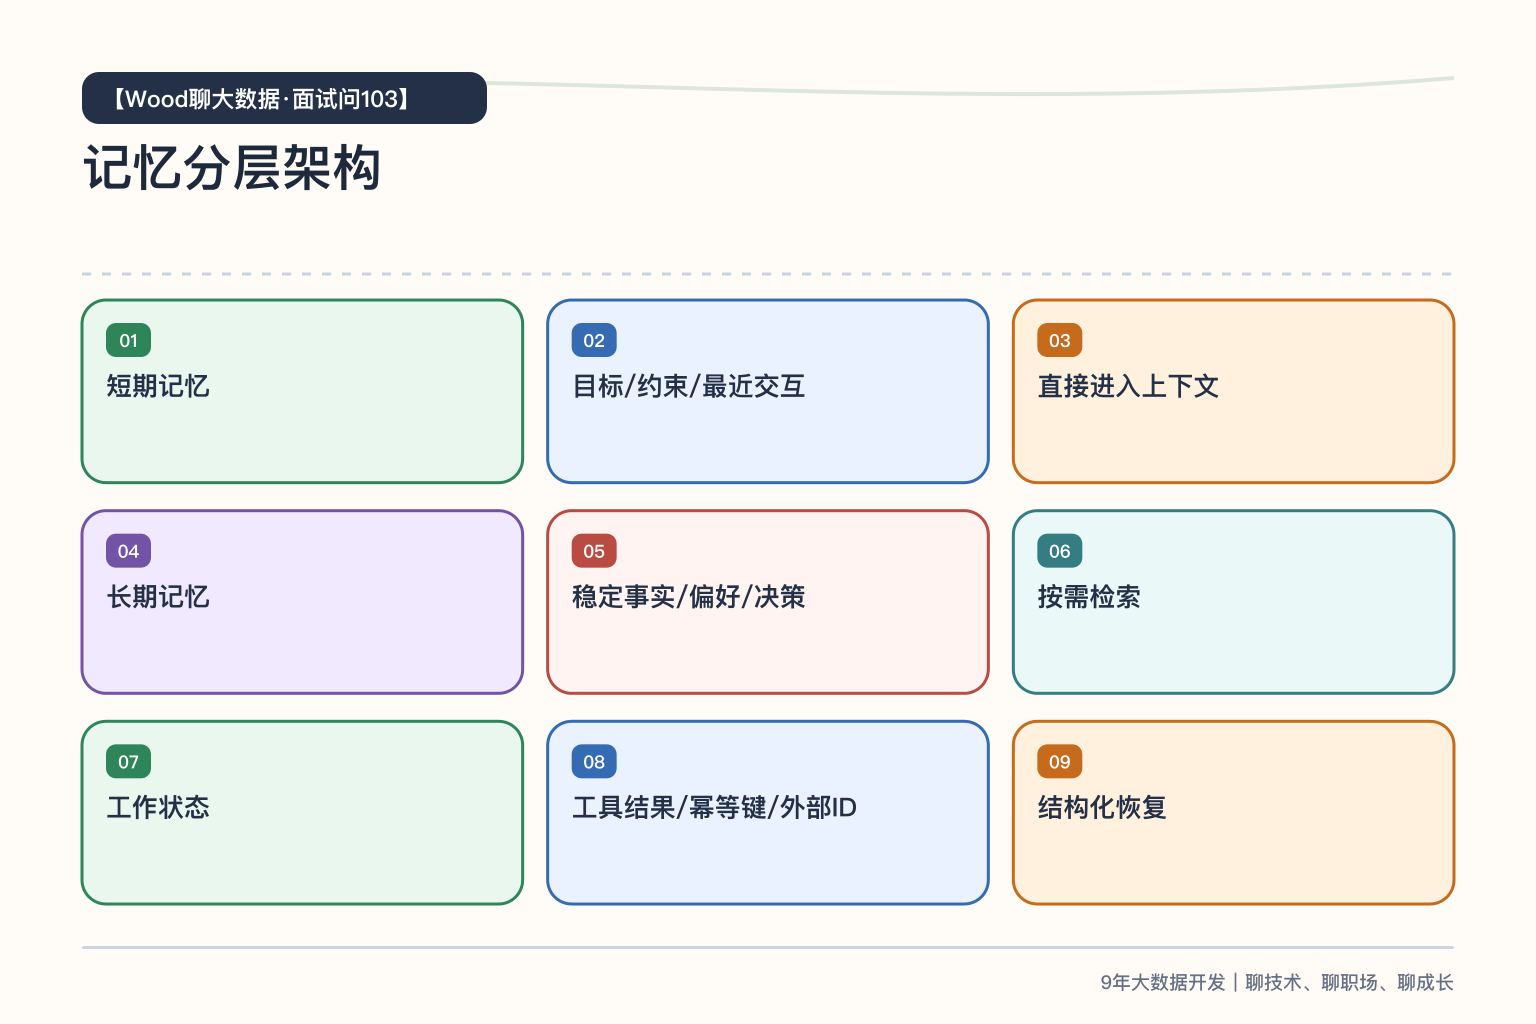
第三层:工作记忆保存可恢复的执行现场
工具型 Agent 还需要保存任务状态:计划、调用参数、幂等键、外部资源 ID、审批状态和重试次数。这部分更像工作流状态,不应只依赖自然语言对话。
例如创建订单后发生超时,Agent 必须知道请求是否可能已经成功,下一次应查询还是重试。只有聊天文本,没有结构化状态,很容易造成重复副作用。
什么时候检索,什么时候直接携带?
当前任务的硬约束和下一步应直接放进上下文;长期历史则按需检索。检索结果还要做相关性、时效和权限判断,不能因为“记忆库里有”就全部相信。
对于高风险操作,长期记忆只能提供背景,关键身份、金额和权限仍需从权威系统实时读取或让用户确认。
一个典型反例
某 Agent 把完整对话向量化,查询时召回“相似历史”。用户后来修改了项目规则,但旧规则因为内容更长、相似度更高,仍反复进入上下文。
问题不是向量检索不准,而是没有版本、有效期和覆盖关系。修复需要让新决策能够废弃旧记忆,并在答案中记录实际使用了哪一条记忆。