数仓分层怎么设计?
本文目录
面试怎么回答
我会先按业务过程确定数据粒度,再按职责设计分层。ODS 负责保留原始数据和可追溯性;DWD 围绕业务过程统一明细、主键和业务语义;DWS 沉淀能被多个下游复用的主题汇总;ADS 面向具体报表或接口交付。判断一张表放哪层,我主要看它是否保留业务事实、是否被多场景复用、是否绑定具体应用。最后还要补上主键、分区、时间口径、质量规则和 SLA。分层不是越多越好,核心是让公共口径只定义一次,并且每个结果都能追溯。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人的回答:
- ODS 放原始数据
- DWD 放明细数据
- DWS 放汇总数据
- ADS 放报表数据
这些定义都没错。
但如果只回答每一层叫什么,面试官很可能会继续追问:
为什么要这样分?一张表到底该放在哪一层?
因为数仓分层不是多建几层表,也不是把同一段 SQL 拆成几份。
真正要解决的是:
让不同加工阶段各负其责,让同一种业务口径只定义一次。
第一步:先定业务过程和数据粒度
设计分层之前,先回答两个问题:
- 这条链路描述的是什么业务过程?
- 一行数据到底代表什么?
比如订单主题里,一行可以代表订单、订单明细、支付记录,也可以代表用户一天的下单汇总。
如果粒度没有说清楚,后面的 Join、聚合和指标都会变得危险。
订单表和订单明细表直接关联,可能把订单金额重复计算;支付记录和退款记录混在一张宽表里,也可能让一行数据失去明确含义。
所以我通常会先写清楚:
业务过程 + 主键或唯一键 + 时间口径 + 一行数据的含义。
分层是后面的事,粒度才是第一份契约。
第二步:按职责决定每一层做什么
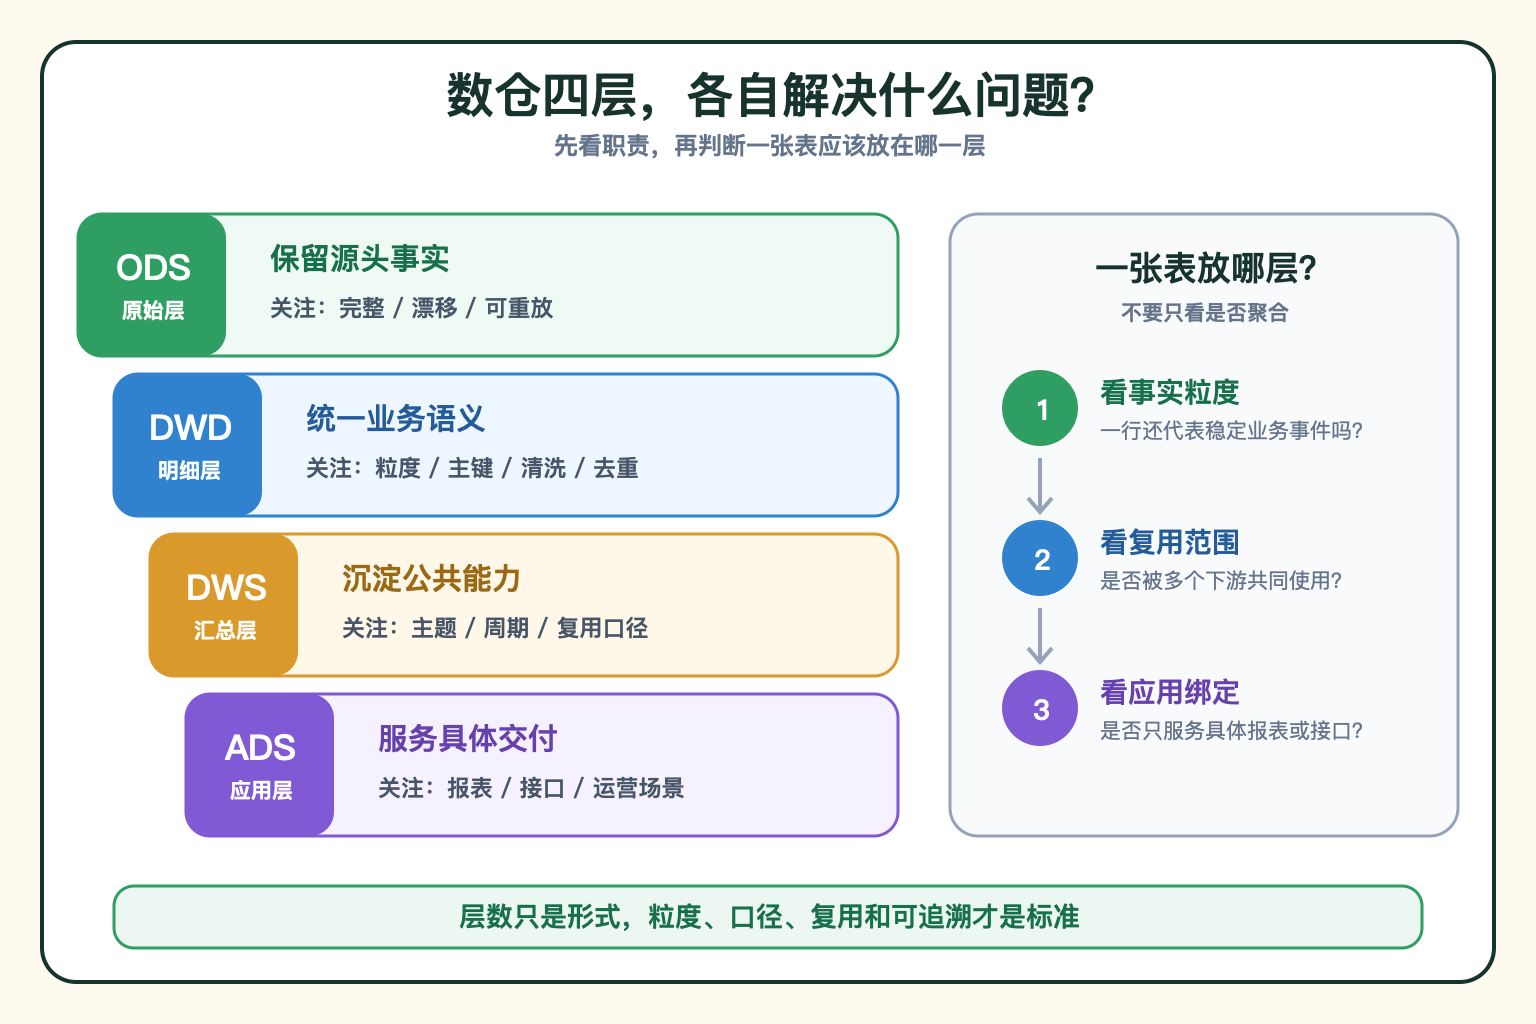
ODS:保留源头事实
ODS 的核心任务是接住源系统数据,尽量保留原始结构和可追溯性。
这一层重点关注采集是否完整、字段是否漂移、数据能否重放,而不是提前塞入大量业务判断。
DWD:统一明细语义
DWD 围绕业务过程建设事实明细,完成必要的清洗、去重、标准化、主外键处理和公共维度补充。
这一层最重要的是统一粒度和口径。下游再使用“有效订单”“支付时间”“渠道”等字段时,不应该各自重复解释。
DWS:沉淀可复用汇总
DWS 按稳定的分析主题和公共维度做轻度或周期汇总,例如用户日、商品日、渠道日。
它解决的是多个应用重复扫描明细、重复计算公共指标的问题。
但不是所有指标都要提前汇总。只服务一个临时报表、变化频繁的计算,强行放进 DWS 反而会增加维护成本。
ADS:面向具体交付场景
ADS 服务报表、接口、看板或运营名单,表结构可以贴近消费端。
这一层允许组合公共指标,但不应该悄悄重新定义核心业务口径。否则两个看板都叫“成交金额”,结果却不一样。
第三步:用复用性和稳定性判断表放哪层
判断一张表的位置,我不会只看它“聚合了几次”,而会看三个维度。
是否保留业务事实
如果一行仍代表一个稳定业务事件,更接近 DWD。
是否被多个下游复用
如果相同维度、周期和口径会被多个应用使用,更适合沉淀到 DWS。
是否绑定具体交付
如果字段和过滤条件明显服务某张看板、某个接口或某次运营动作,更接近 ADS。
这三个判断比“明细一定是 DWD、聚合一定是 DWS”更可靠。
因为现实里也会有明细型 ADS、轻度汇总的 DWD 衍生表。关键不是表名,而是职责有没有越界。
第四步:补上分层之间的数据契约
只画 ODS、DWD、DWS、ADS 四个框,还不算真正完成设计。
层与层之间至少要明确:
- 主键、分区字段和数据粒度
- 全量、增量还是拉链处理
- 业务日期与更新日期的含义
- 核心指标的唯一口径
- 数据质量规则、SLA 和责任人
没有这些契约,分层越多,问题只会藏得越深。
真正好的分层,应该让上游变化能被发现、公共逻辑能被复用、下游结果能被追溯。
一个典型场景
比如订单、支付、退款数据要同时支持经营看板和渠道分析。
一种常见做法是两个 ADS 各自直接 Join ODS,再分别计算支付金额和退款金额。
刚开始上线很快,但过一段时间后,其中一个报表按支付成功时间统计,另一个按订单创建时间统计;一个先扣退款,另一个把退款单独展示。
最后两个页面都写着“成交金额”,数字却对不上。
问题不在某条 SQL 写错了,而在公共明细和指标口径没有沉淀。
更合理的做法是:
ODS 保留原始订单、支付、退款记录 → DWD 统一事件粒度和状态语义 → DWS 沉淀复用的日汇总 → ADS 只做面向页面的组合与展示。
这样改动一次公共口径,所有下游都能沿同一条链路生效。
为什么分得越多不一定越专业?
每增加一层,都会增加调度依赖、存储成本、故障节点和理解成本。
如果某一层没有明确职责,只是把数据原样复制一次,它并没有带来复用或治理价值。
小规模业务可以少分,复杂业务也可以在标准分层之外增加 DIM、公共汇总或数据集市。
但无论层数多少,都要能回答:
这一层消除了什么重复,固定了什么口径,又为谁提供了什么稳定能力?
我理解的数仓分层
数仓分层的本质,是对数据加工职责做边界设计。
先用粒度守住事实,再用 DWD 统一明细语义,用 DWS 沉淀公共能力,最后让 ADS 贴近交付。
层数只是形式,粒度、口径、复用和可追溯才是判断设计好坏的标准。