数仓杂项维度什么时候用?
面试怎么回答
杂项维度用于收拢多个没有自然归属的低基数标志、状态和小分类,事实表只保留一个组合代理键。它能避免事实表堆满描述字段,也避免建立大量微小维表。实现时通常只维护实际出现的有效组合,并设置未知组合;高基数、自由文本、快速变化属性和有明确业务归属的字段不应放入,还要监控组合数量是否异常增长。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
订单事实表里塞了十几个字段:是否首单、是否礼品、支付类型、风控状态、配送方式、优惠标识……每个字段取值不多,却把事实表越堆越宽。
这种零散、低基数的描述属性,可以考虑用杂项维度收拢。
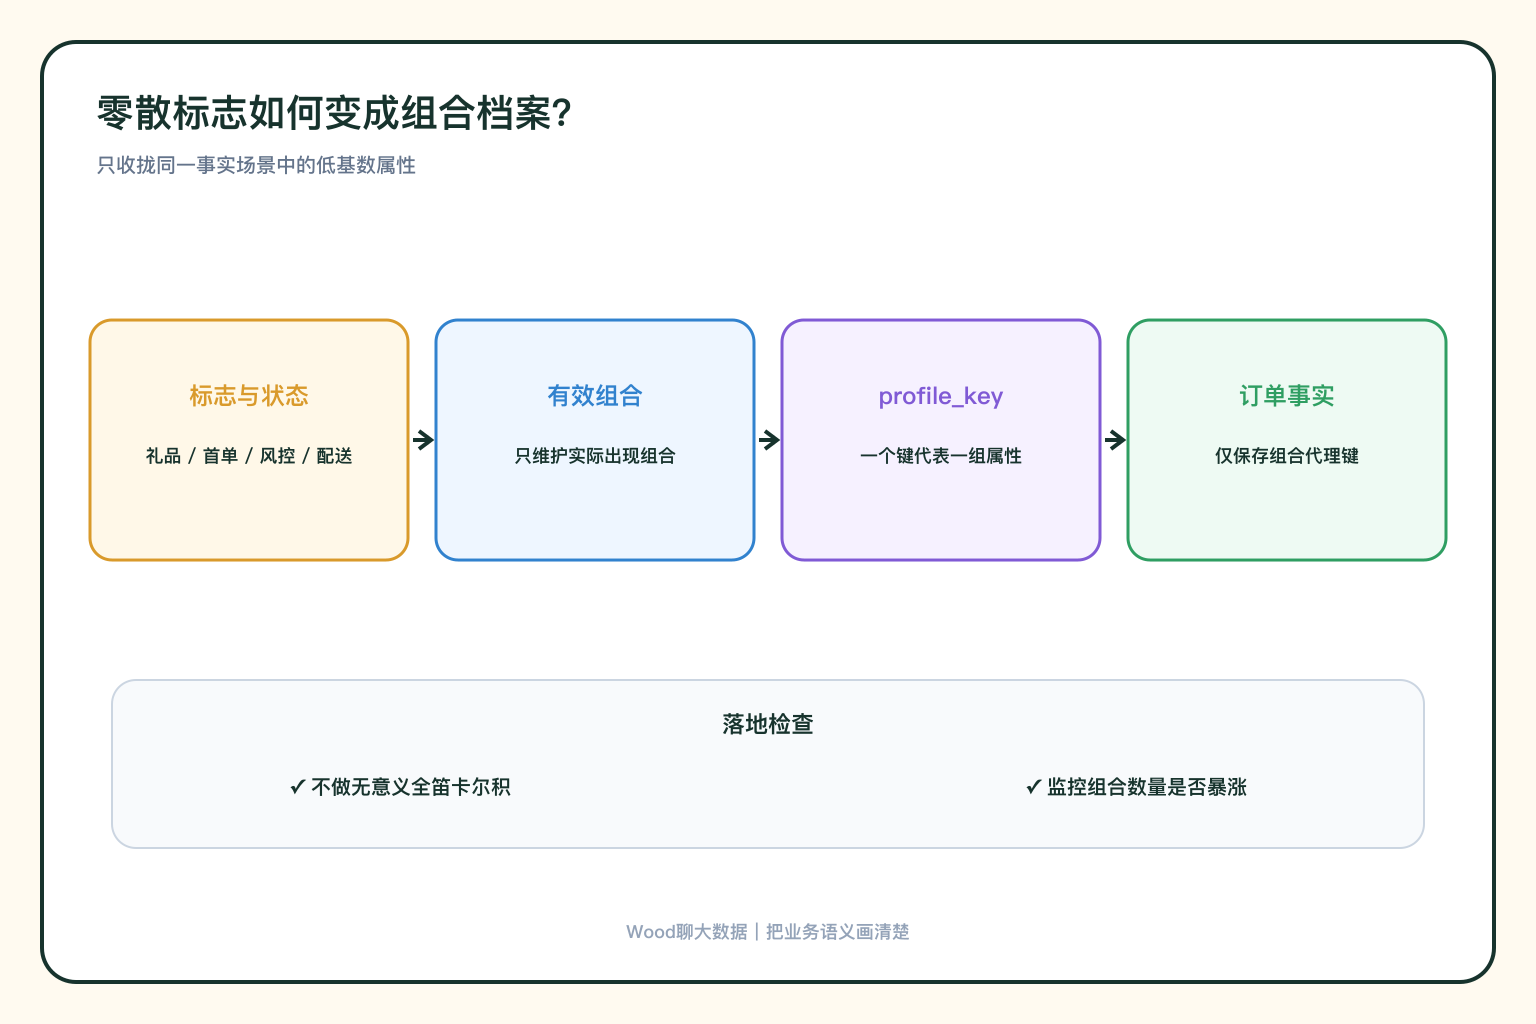
杂项维度,也叫 Junk Dimension,是把多个没有自然归属、低基数的标志位、状态码和小型分类组合成一张维度表,事实表只保存一个组合键。
为什么不为每个标志建一张维表?
如果给 is_gift、is_first_order、risk_level 分别建维度表,会产生大量只有几行的小表。查询一次事实却要 Join 多张小维度,可读性和管理成本都不好。
如果全部留在事实表,虽然查询直接,但事实表会混入大量描述字段,公共含义、显示名称和枚举映射也容易散落在不同脚本里。
杂项维度提供中间方案:
dim_order_profile
  profile_key
  is_gift
  is_first_order
  payment_type
  risk_level
  delivery_type
事实表只保留 profile_key。
组合行怎么生成?
并不一定要把所有属性做完整笛卡尔积。5 个属性每个 10 个取值,理论组合已经有 10 万种,其中大量组合可能永远不会出现。
更常见的做法是只维护业务实际出现的有效组合,并为组合生成代理键。同时设置一行“未知/未提供”组合,承接源数据缺失。
加载事实时,要根据各属性值查找对应组合键;如果新组合出现,则按维度加载规则创建。为了防止重复,组合属性应有唯一约束或稳定哈希,但哈希碰撞、NULL 标准化和字段顺序都要处理清楚。
哪些字段不适合放进去?
高基数编号、自由文本、时间戳不适合,因为会让组合数接近事实行数,维度失去复用价值。
快速变化的属性也要谨慎。某个状态频繁变化且需要完整历史时,更适合作为独立维度、微型维度或事实事件建模,而不是不断制造新的杂项组合。
有明确业务主体的属性,例如客户等级、商品品牌,也不该因为取值少就塞进杂项维度。它们属于已有维度的业务描述,应留在自己的上下文中。
杂项维度不是垃圾桶
名字叫 Junk,不代表可以把暂时不知道放哪里的字段全部丢进去。入选字段至少要满足:描述同一事实场景、低基数、没有更自然的维度归属,并且经常一起用于筛选或分组。
还要维护字段定义、枚举含义和组合增长监控。如果维度行数突然暴涨,通常说明混入了高基数或未标准化字段。