多张事实表怎么关联?Drill Across 如何避免指标放大?
面试怎么回答
多事实分析我先声明各表粒度,找到一致性维度支持的共同报告粒度,再让每侧独立聚合成一键一行,最后用全连接或键并集合并。这样避免明细多对多放大,也能保留单侧存在的业务。无法支持的维度不能直接下钻,分摊要另建规则;验收同时检查键唯一、覆盖范围和每项指标回卷守恒。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
一张报表同时展示商品销量、退款金额和广告消耗。三张事实表各自查都对,关联以后每个指标却都变大了。这里更值得讨论的是,跨业务过程的指标应该在哪个粒度相遇。
每张事实表先按一致性维度聚合到共同报告粒度,再合并结果;指标无法支持的维度必须限制下钻或另行制定分摊规则。
事实表之间往往没有一对一关系
订单事实一行可能是一条订单明细,退款事实一行是一笔退款,广告事实一行是计划当天的消耗。它们即使都有商品和日期,也不代表明细能够一一对应。
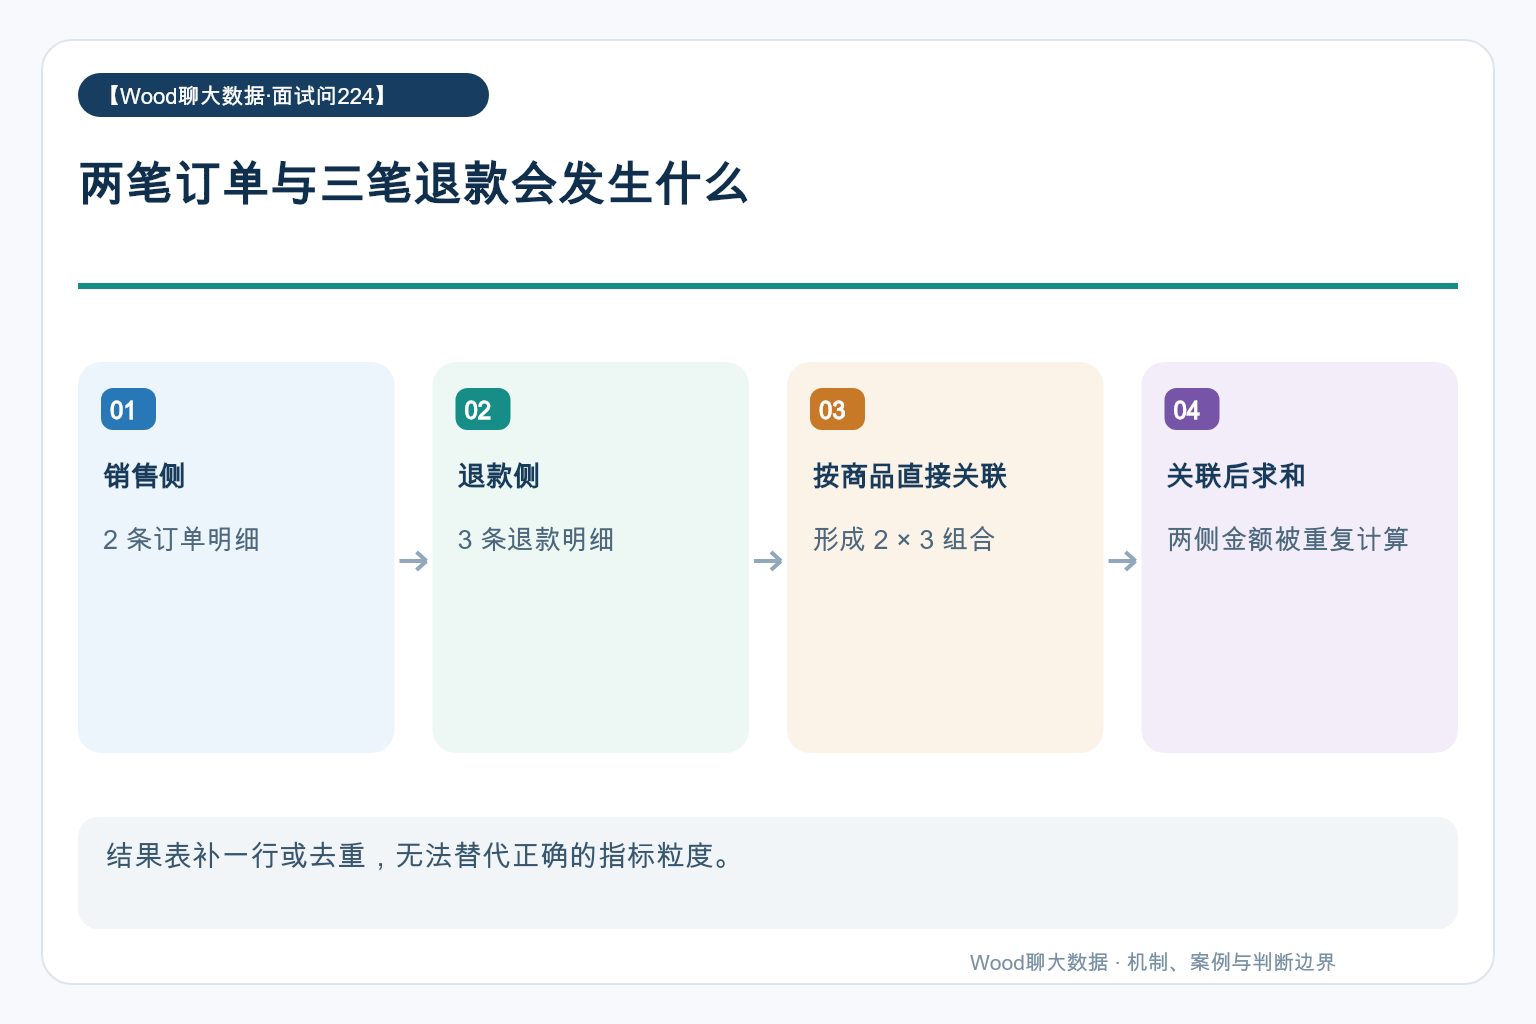
当一件商品当天有两笔订单和三笔退款,按商品、日期直接关联会形成六种组合。SUM 放在关联之后,会重复累计两侧金额。处理前先声明每张表的业务过程、粒度和唯一键,比直接在结果外层补 DISTINCT 更可靠。
共同粒度决定哪些维度可以展示
如果广告消耗只支持商品、日期,销量还能细分用户,那么三项指标共同展示的自然粒度就是商品、日期。不能因为销量表有用户字段,就把整份广告消耗复制到每个用户。
要提供用户级成本,必须有独立的分摊模型,并说明它是分配值。Drill Across 依赖一致性维度:商品标识、日期口径、渠道编码和历史版本都要对齐,同名字段的业务语义也需要验证。
每侧独立聚合,再合并结果
先分别计算商品、日期粒度的销量、退款和消耗,并验证每侧组合键唯一。之后可以做 FULL OUTER JOIN,或先构造三侧键的并集作为骨架,再逐个 LEFT JOIN 指标结果。
用销量结果单独驱动整个报表,可能丢掉有消耗却没有销量的商品;简单 INNER JOIN 又会丢失没有退款的正常销售。选择合并方式时,要明确报告覆盖范围,再决定哪些缺失项能够解释成零。

一个典型场景:补 DISTINCT 以后金额仍然错
比如开发发现指标放大,先对关联结果按订单号去重,销量恢复了,退款和消耗却仍不准确。原因是订单号只能约束订单侧,无法表达其他事实的归属关系。
原先抽样只选了有一笔订单和一笔退款的商品,恰好没有多对多组合。重新用两笔订单、三笔退款和一条消耗构造案例,再按共同粒度分别聚合,才能稳定复现并消除放大。测试应包括只在某一侧存在的键。
验收不只检查结果主键唯一
最终表一键一行只是结构条件,还要把每项指标单独回卷到源事实支持的范围,验证合计守恒。注意退款日与支付日可能不同,退货率如果要归属原订单周期,需要在退款侧先完成归属转换。
对于原始数据确实有业务主从关系的场景,事实明细之间也可以通过明确键关联;关键是证明基数和指标归属。面试回答不必把任何事实关联都说成禁区,而应说明为什么这次需要多路聚合和结果合并。