无事实事实表怎么设计?
面试怎么回答
无事实事实表没有传统数值度量,通过一组维度键及记录是否存在表达业务事实,通常用 COUNT 统计。常见有两类:记录出勤、触达等已发生事件;记录资格、计划等覆盖集合,并与实际事件比较分析“应发生但未发生”。设计重点仍是明确粒度和唯一性,防止重复行或 Join 放大计数;是否增加恒为 1 的计数列取决于工具需要。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
学生参加了一次课程、用户领到一次活动资格、客户收到一次销售触达。这些业务事件没有金额和数量,还值得进入事实表吗?
值得。没有数值度量,不代表没有可分析的业务事实。
无事实事实表(Factless Fact Table)通常只保存多个维度外键,不保存传统可加度量。它通过“某个维度组合的一行是否存在”表达事件或覆盖关系,最基本的度量就是数行数。
第一类:记录发生过的事件
例如学生出勤:
fact_attendance
  date_key
  student_key
  course_key
  teacher_key
  campus_key
一行代表“某学生在某天参加某课程”。虽然没有 attendance_count = 1,但 COUNT(*) 就能计算出勤次数。
其他例子还有客户触达、促销参与、页面曝光、用户权限变更。设计前仍然必须声明粒度,明确同一学生同一天同一课程是否只允许一行。
第二类:记录应该发生的覆盖关系
例如“哪些客户有资格参加哪些活动”,它表达的是业务覆盖,而不是已经参与。
将资格覆盖表与实际参与事件表比较,就能找出“有资格但未参与”的客户:
应覆盖集合 - 已发生集合 = 未发生对象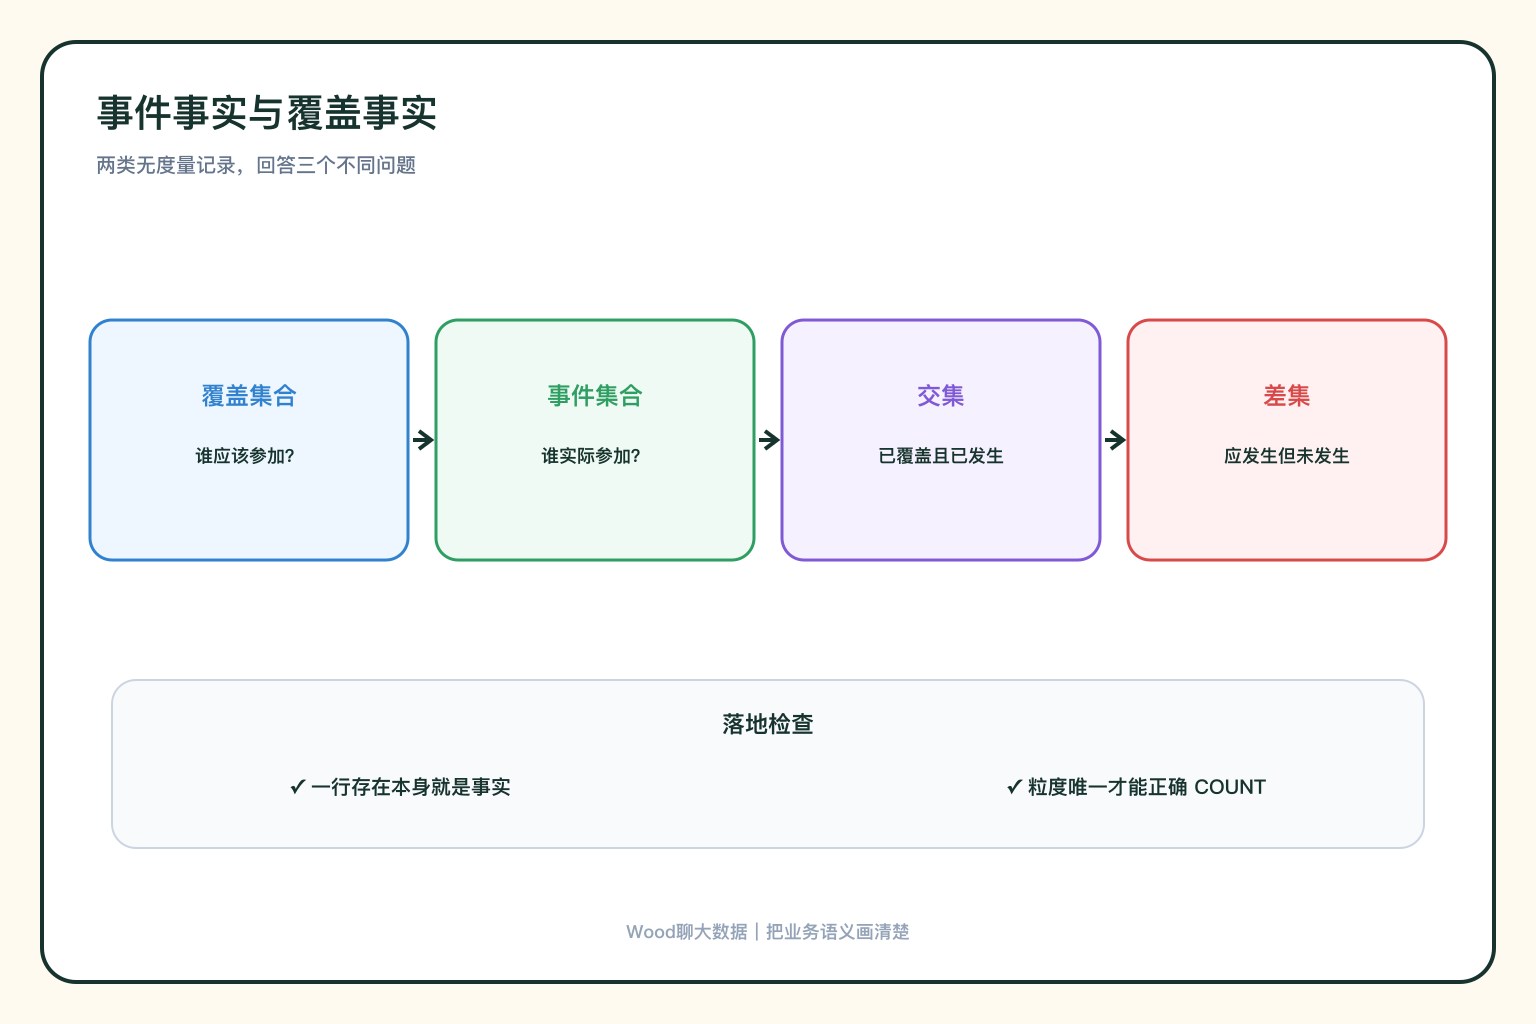
这类“没有发生什么”的分析,单靠事件表无法完成。因为事件表只知道出现过的记录,不知道哪些组合本来应该出现。
最关键的还是粒度和唯一性
如果同一个学生一次课程签到三次,事实表究竟保存三条签到行为,还是去重后的一条出勤事件?两种都可以,但粒度和指标完全不同。
如果目标是统计出勤学生数,可能需要 COUNT(DISTINCT student_key);如果事实粒度已经保证每个学生每节课一行,COUNT(*) 才能直接作为次数。设计时应设置业务唯一键或质量规则,防止重复加载把事件数量放大。
要不要补一个常量 1?
有些系统会增加 event_count = 1,让 BI 工具更容易求和。这样做不改变模型本质,但要确保它永远为 1,并避免使用者同时对 Join 放大后的行做求和。
无论有没有常量列,度量的可加范围仍由粒度决定。和多值维度 Join 后,COUNT(*) 同样可能被放大。
何时不适合?
如果事件天然有金额、时长、次数等度量,应正常放入事实表,不必刻意做成无事实。若只想保存当前用户权限,而不关心授权事件或历史覆盖,它可能更适合桥接关系表。命名不是重点,业务过程、粒度和分析问题才是判断依据。