数仓维度表怎么设计?
面试怎么回答
我会先定义维度粒度和业务主键,再引入代理键隔离源系统变化,并支持历史版本。属性设计围绕筛选、分组和解释事实展开,常用层级可以适度反规范化,跨主题维度要统一口径。属性变化按分析需求选择 SCD Type 1 覆盖或 Type 2 留历史,同时维护有效期和当前标识。最后还要处理未知成员、迟到维度、版本重叠和主键质量,保证事实关联不丢数。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人会回答:
“维度表就是保存用户、商品、地区这些描述属性,再通过主键和事实表关联。”
这只是维度表的基本形态。
真正难的是:同一个业务对象会改名、换分类、换地区;多个主题还要对“用户”“商品”保持同一套解释。
所以我理解的维度表设计是:
稳定识别业务对象,提供可分析的描述属性,明确历史变化策略,并让不同事实表共享一致口径。
第一步:先定义维度粒度和身份
和事实表一样,维度表也要先声明一行代表什么。
例如:
一行代表一个商品当前版本或者:
一行代表一个客户在某段有效期内的属性版本这里要区分两类 Key:
- 业务主键:来自业务系统,例如
user_id、product_code - 代理键:数仓内部生成的稳定标识,例如
user_sk、product_sk
业务主键可能被复用、格式变化,甚至来自多个源系统;代理键则用于隔离源系统变化,并支持同一个业务对象保存多个历史版本。
如果维度表需要保留历史,通常是代理键唯一,业务主键可以对应多行版本。
第二步:围绕分析使用组织属性
维度表的核心价值不是“字段全”,而是让事实数据能够被筛选、分组和解释。
商品维度里可以放:
- 商品名称、品牌、品类
- 一级类目、二级类目、三级类目
- 上架状态、规格类型
常用层级可以适度反规范化到一张维度表中,减少下游为了一个分类名称反复 Join 多层码表。
但也要守住边界:订单金额、点击次数这类随业务事件产生的度量,应该进入事实表;不能因为查询方便,就把会不断变化的汇总指标塞进维度表。
对跨主题反复使用的用户、商品、日期、地区,还要建设一致性维度。不同事实表引用同一套维度键和属性定义,才能保证按品牌、地区等维度汇总时口径一致。
第三步:按属性决定历史变化策略
维度属性发生变化时,不是统一选择“覆盖”或“新增一行”,而要按业务分析需求决定。
SCD Type 1:直接覆盖
适合错别字修正、无须保留历史的属性。
例如商品名称录错了,修正后历史报表也应该展示正确名称。
SCD Type 2:新增版本
适合需要还原历史状态的属性。
例如客户所属城市从杭州变为上海,需要新增一条代理键不同的版本,并维护:
effective_from
effective_to
is_current
事实表在事件发生时关联当时有效的维度版本,才能回答“当时属于哪里”。
Type 3 或扩展字段:保留有限前后值
适合只关心当前值和上一个值的少量场景,但不适合保存完整变化历史。
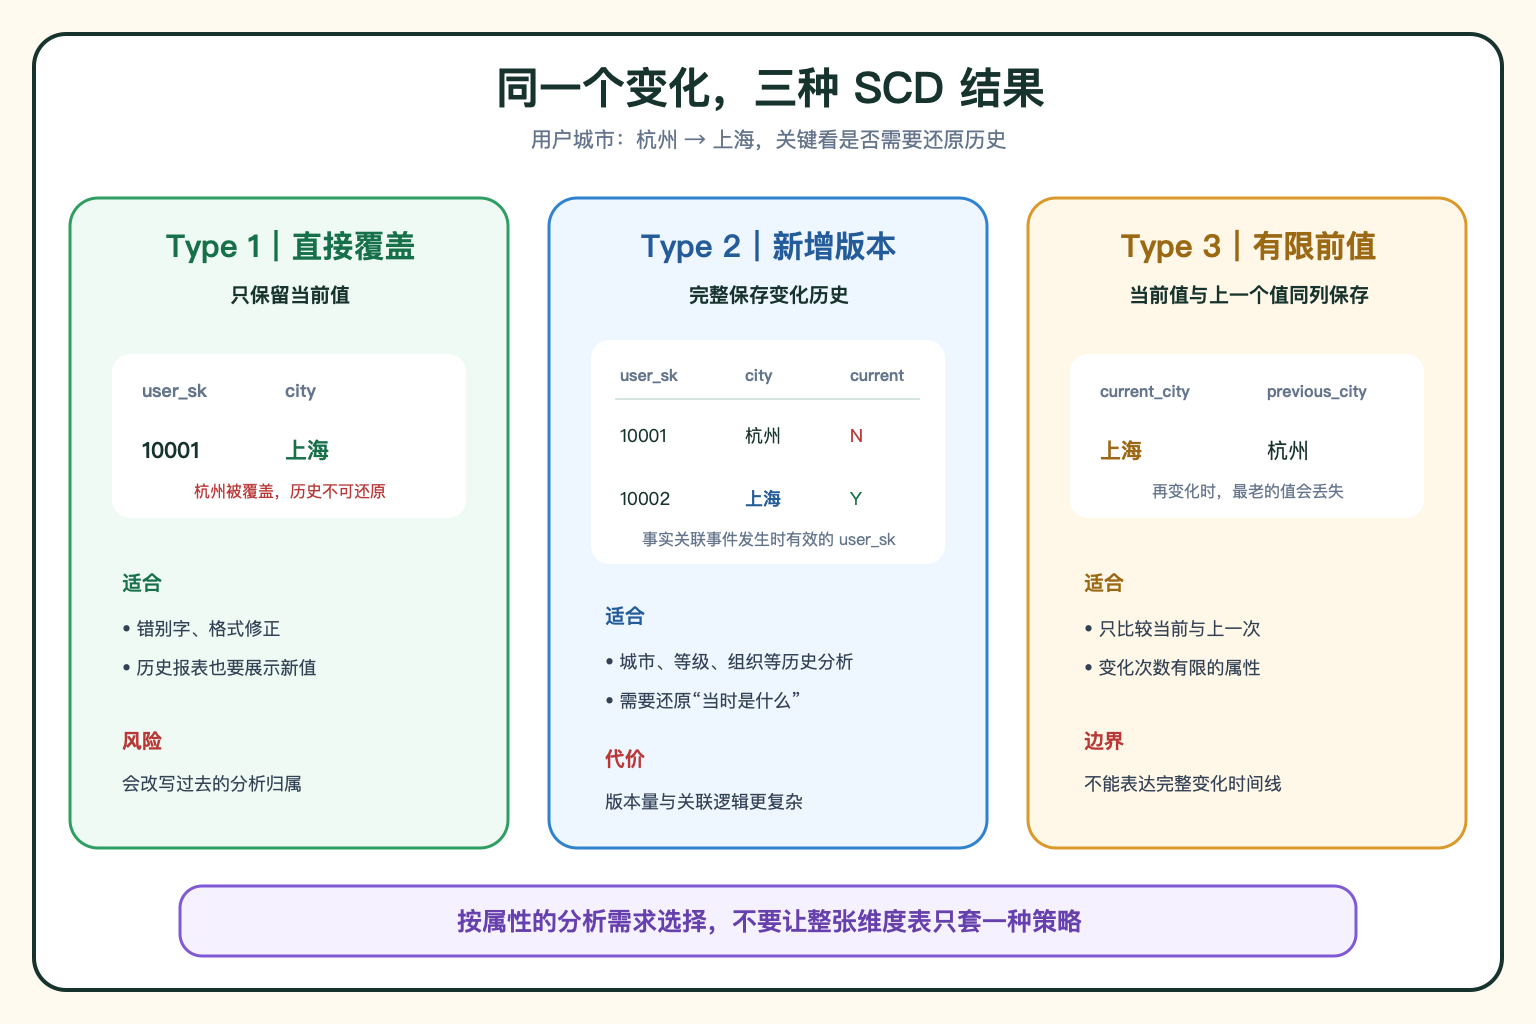
最重要的不是把所有字段都做成 Type 2,而是给每个属性明确变化策略。高频变化且分析价值低的字段如果全部留历史,会造成维度版本快速膨胀。
第四步:处理未知成员和迟到维度
事实数据到达时,对应维度可能还没同步过来。
如果直接使用 Inner Join,事实记录可能被悄悄过滤;如果保留空值,下游又很难判断是数据缺失还是业务本身为空。
常见做法是准备一个“未知成员”代理键,例如:
0 = Unknown事实先关联到 Unknown,维度补齐后再根据数据链路能力回补正确代理键,或者通过可追溯规则在查询层修正。
同时还要治理:
- 业务主键重复与空值
- Type 2 有效期重叠或断档
- 同一业务对象出现多个当前版本
- 一致性维度在不同主题中的属性口径漂移
维度表不只是“查名称”的字典表,它本身也是指标可信度的一部分。
一个典型场景
比如用户从杭州迁到上海,用户维度直接覆盖了城市字段。
结果历史订单重新跑数后,过去发生在杭州阶段的订单也全部被归到上海。报表数字总量没有变,但区域趋势被改写了。
问题不是 Join 写错,而是“城市”这个属性应该按历史版本分析,却被当成 Type 1 直接覆盖。
更合理的方式是:为城市变化新增 Type 2 版本,让订单事实关联事件发生时有效的 user_sk;而手机号码格式修正这类不需要历史分析的属性,仍然可以使用 Type 1。
维度变化策略应该按属性设计,而不是整张表只用一种处理方式。