离线数仓和实时数仓如何保证数据一致?
面试怎么回答
离线实时一致性我会从口径、处理、对账和校准四层保证。先统一指标定义、时区、事件时间和数据截止点;计算规则尽量同源,实时链路支持幂等、重放和迟到补偿;按源、明细、汇总、应用逐层对账,避免总量抵消差异;最后用离线完整结果做日终校准,并定义暂估误差、收敛时长和责任人。目标是差异可解释、最终可收敛。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
同一个“今日支付金额”,实时大屏是 980 万,第二天离线报表变成 1,005 万。两条链路都没有任务失败,业务却不知道该信哪一个。
离线和实时结果完全相同并不总是合理。先统一指标语义和数据边界,再用同源逻辑、可重放处理、分层对账和最终校准,让差异可解释、可收敛。
先判断是不是“假不一致”
常见差异来自:
- 实时按事件时间,离线按入库时间
- 一个使用 UTC,一个使用业务时区
- 实时只统计已到数据,离线包含迟到补数
- 去重主键、状态过滤和汇率版本不同
- 实时展示当前值,离线按完整日封账值
所以第一步不是改代码,而是把指标定义、时间窗口、数据截止点和查询时刻对齐。实时值可以叫“截至当前的暂估值”,离线值是“T+1 完整值”,两者差异本身可能符合预期。
计算逻辑尽量同源
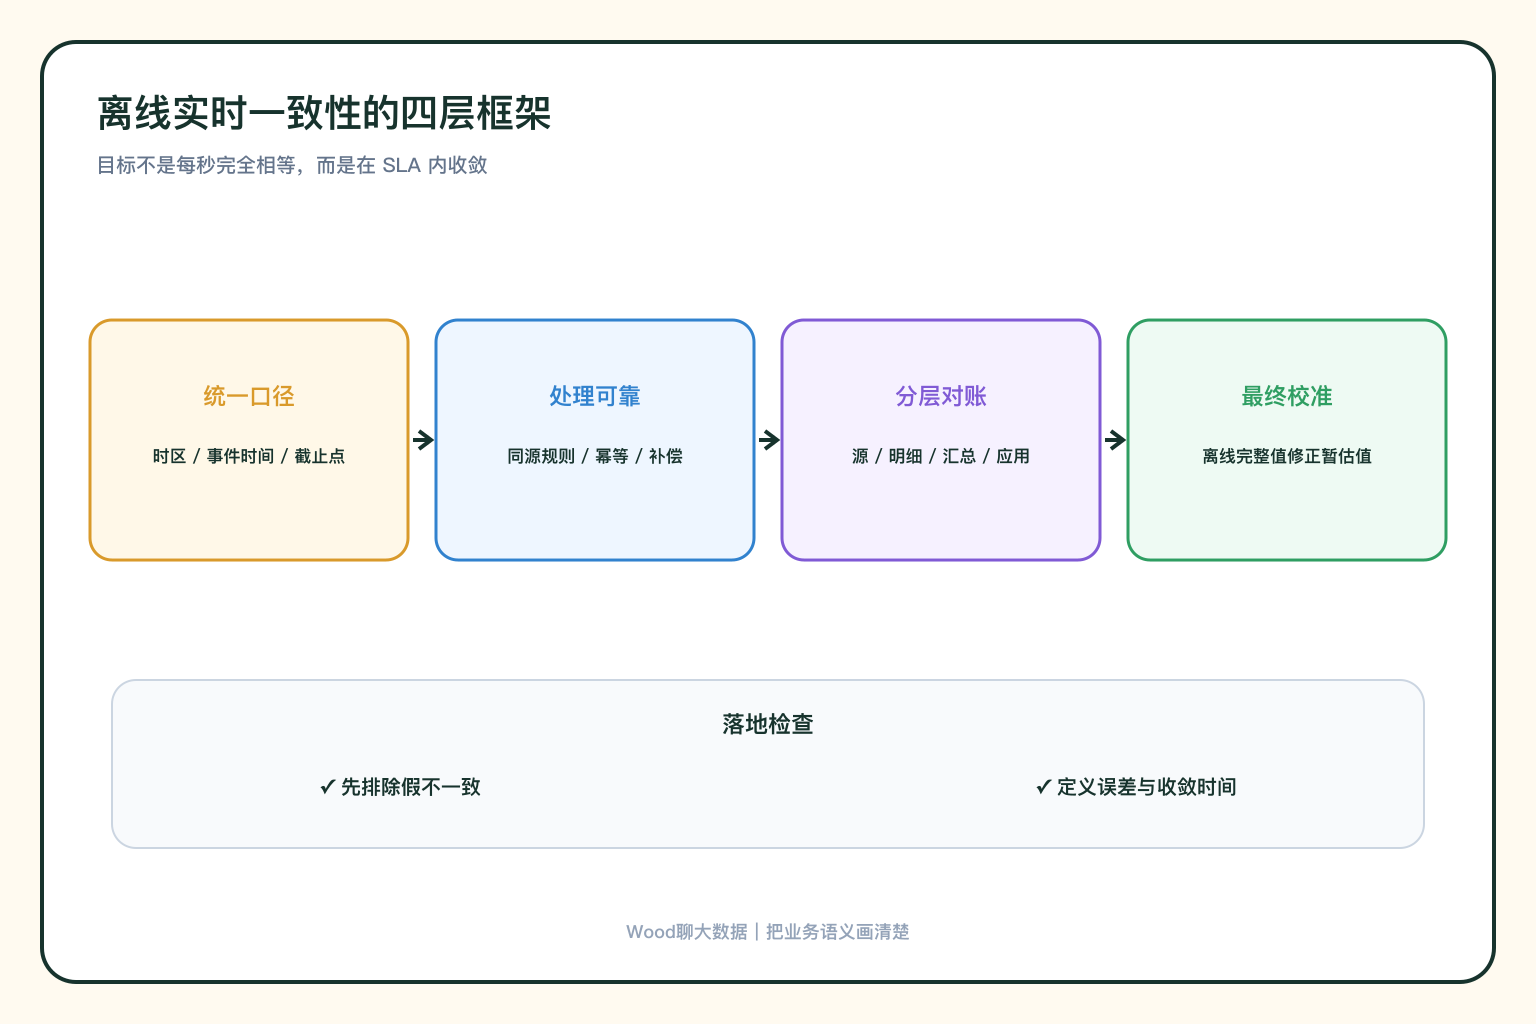
能复用的过滤条件、维度映射、去重规则和指标公式应进入统一语义层、共享函数或配置,而不是在两套 SQL 中分别复制。
但不能为了代码复用忽略执行差异。实时状态有 TTL、Watermark 和乱序处理,离线可以扫描完整分区。相同业务定义可能需要不同物理实现,关键是输出契约一致。
实时链路必须可重放
源消息要有稳定事件 ID、事件时间和版本,Sink 要支持幂等或版本覆盖。Checkpoint、Offset 只能保证恢复位置,不能代替业务去重。
迟到数据策略也要明确:多晚还更新实时结果,何时进入补偿流,窗口关闭后如何修正。对于维表变更,要确定按事件发生时维度还是当前维度关联,避免离线重算与实时查询使用不同版本。
建立分层对账,而不是只比总数
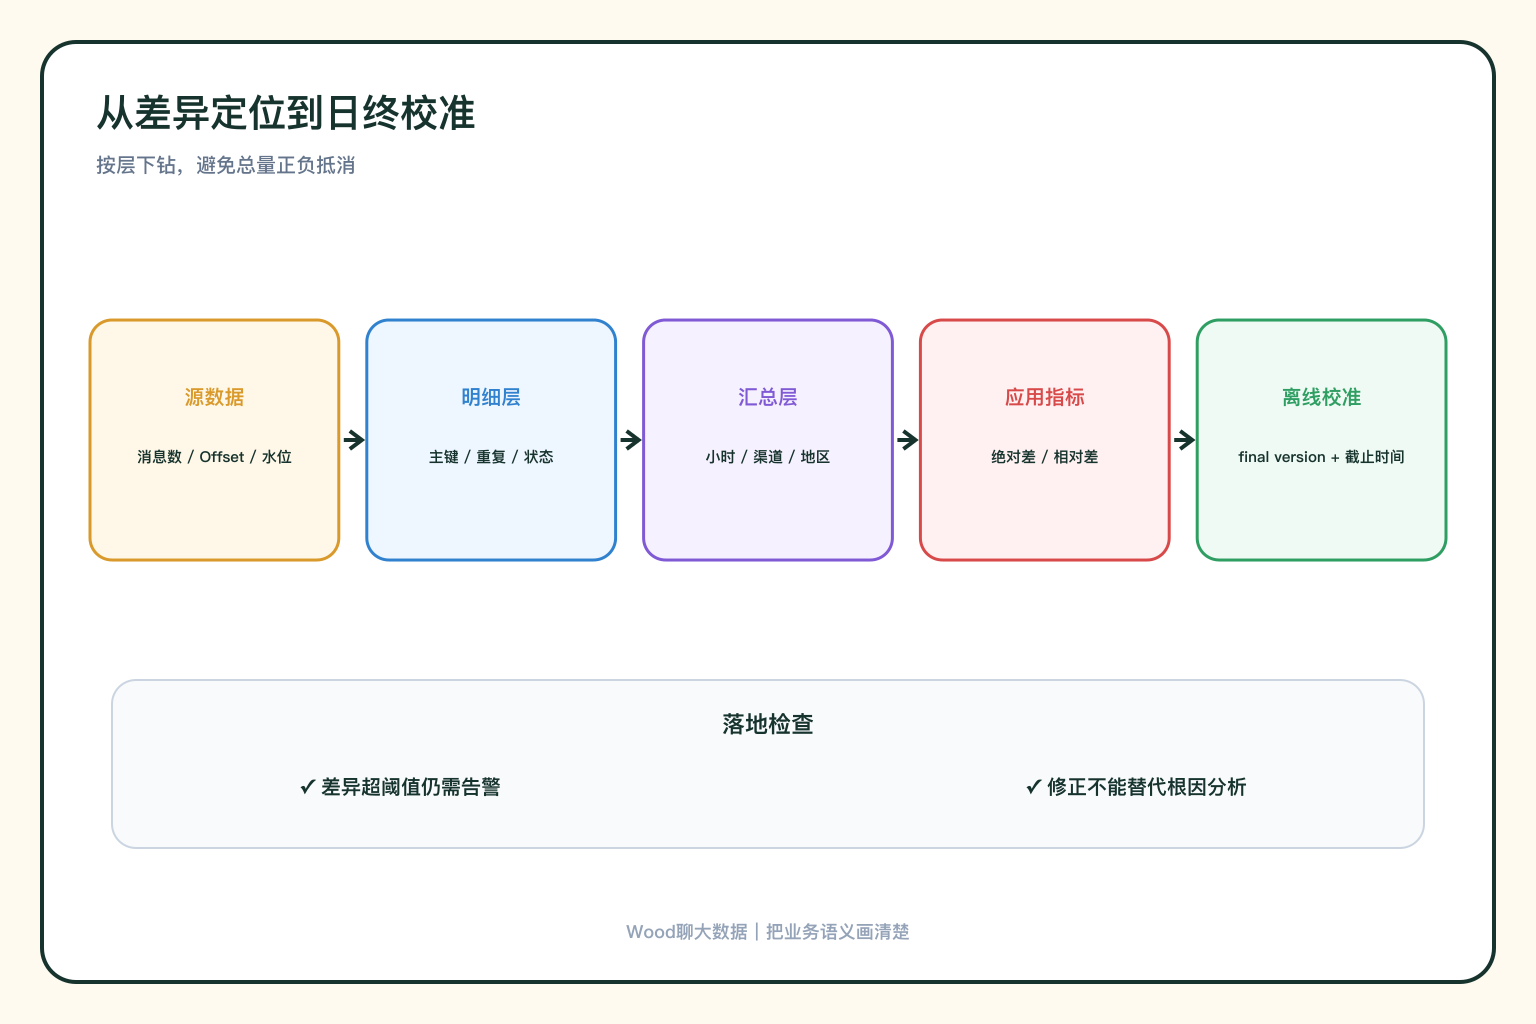
我会按“源数据—明细—汇总—应用”逐层比较:
- 源端消息数、最大 Offset、事件时间水位
- 明细主键数、重复数、状态分布和金额校验和
- 按小时、渠道、地区等维度聚合差异
- 最终指标绝对差、相对差和收敛时间
只比较全天 GMV,正负差异可能互相抵消。先按小时和业务维度下钻,才能判断是漏数、重复、迟到、维度版本还是口径差异。
用离线做最终校准
对于允许最终一致的指标,可以在日终用离线完整结果覆盖或修正实时结果,并保留 is_final、数据截止时间和版本。修正不是掩盖实时错误,差异超过阈值仍要告警和定位。
真正高价值的是定义 SLA:实时延迟允许多少、暂估误差允许多少、多久必须收敛、谁负责处理。没有这组约束,“一致”就只是口号。