数仓宽表和维度模型怎么选?
面试怎么回答
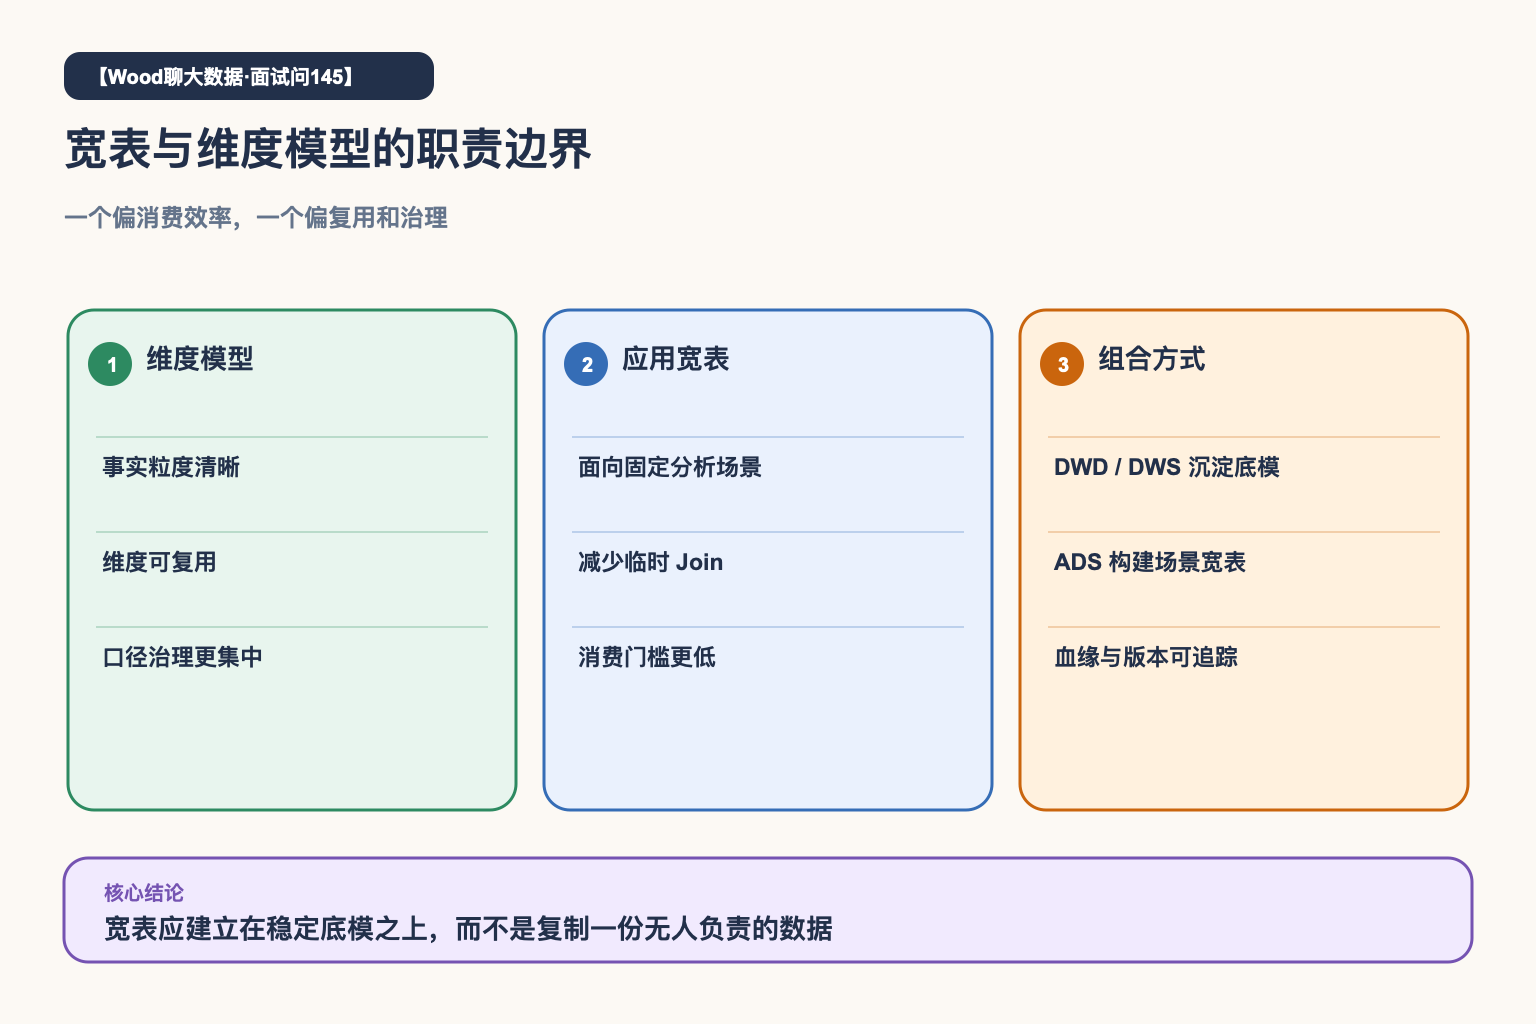
宽表和维度模型不是互斥关系。维度模型通过明确事实粒度和公共维度保证复用、扩展和口径一致;宽表面向稳定场景预先组合字段,减少下游 Join 和使用门槛。我的做法通常是底层保留标准事实与维度模型,上层按固定报表或服务契约生成应用宽表,同时管理字段血缘、负责人、刷新和版本,避免宽表失控复制。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
宽表查询简单,维度模型边界清晰。有人追求“一张表解决所有分析”,也有人坚持所有指标都现场 Join。
真正的生产方案往往不是二选一。
维度模型负责沉淀稳定事实、维度和一致口径;宽表负责为明确、稳定的消费场景降低查询复杂度。
维度模型解决的是复用问题
事实表先明确业务过程和粒度,维度表统一描述对象。订单、用户、商品、渠道各自有清晰责任,下游可以按不同问题灵活组合。
它的优势是复用、扩展和口径治理,代价是查询需要理解粒度与 Join 关系,对普通分析用户门槛更高。
宽表解决的是消费效率问题
宽表把一个稳定场景需要的事实、维度和派生字段提前组装好,减少下游重复 Join,也能降低复杂查询对线上引擎的压力。
但宽表字段多、重复存储大,维度变化后容易批量回刷。如果不同团队各自建一张“用户订单宽表”,同名字段很快就会出现多套口径。
选型看场景稳定度和复用范围
探索性强、分析维度经常变化时,更适合基于维度模型灵活查询。日报、推荐特征、固定看板等访问模式稳定时,可以提供应用宽表。
还要考虑数据时效、更新频率、存储成本和回刷范围。高频变化的用户属性直接冗余进大量宽表,维护成本通常很高。
我更倾向“底模 + 应用宽表”
在 DWD、DWS 层保持事实粒度和公共维度一致,在 ADS 或服务层按具体消费契约生成宽表。
宽表要明确负责人、刷新频率、字段来源和版本,能够追溯回底层事实与维度。这样它是可治理的交付层,不是随手复制的结果表。
一个典型场景
一个团队为每张看板都复制一份订单宽表。用户等级规则变更后,需要同时回刷十几张表,而且部分表遗漏,导致同一天的会员 GMV 出现多个结果。
问题并不是“宽表不能用”,而是公共维度和指标口径没有先沉淀。把会员等级历史与订单事实统一后,再按看板需要生成宽表,变更范围才可控。
宽表提升的是消费效率,不能牺牲底层事实的一致性。