AB 实验数据怎么建模?分到实验组就算真正曝光了吗?
本文目录
面试怎么回答
我会把实验分配、实际曝光和转化事件分开保存,统一实验单位和身份标识,记录实验版本及入组时间。分析时先确定分母和观察窗口,再聚合到实验单位,避免曝光与订单多对多放大。还要检查分流比例、跨组和埋点异常。按分配分析与按曝光分析回答不同问题,不能看哪个结果更好就临时换口径。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
产品想知道新版页面有没有提高转化率。实验组名单有了,订单表也有了,Join一下似乎就能回答。可有些用户从来没打开过这个页面,他们算不算参与了这次体验?
实验分配、实际曝光和业务转化应分别建模;分析单位、入组版本与观察窗口明确后,才谈得上可靠的组间比较。
分组事实和曝光事实不是同一件事
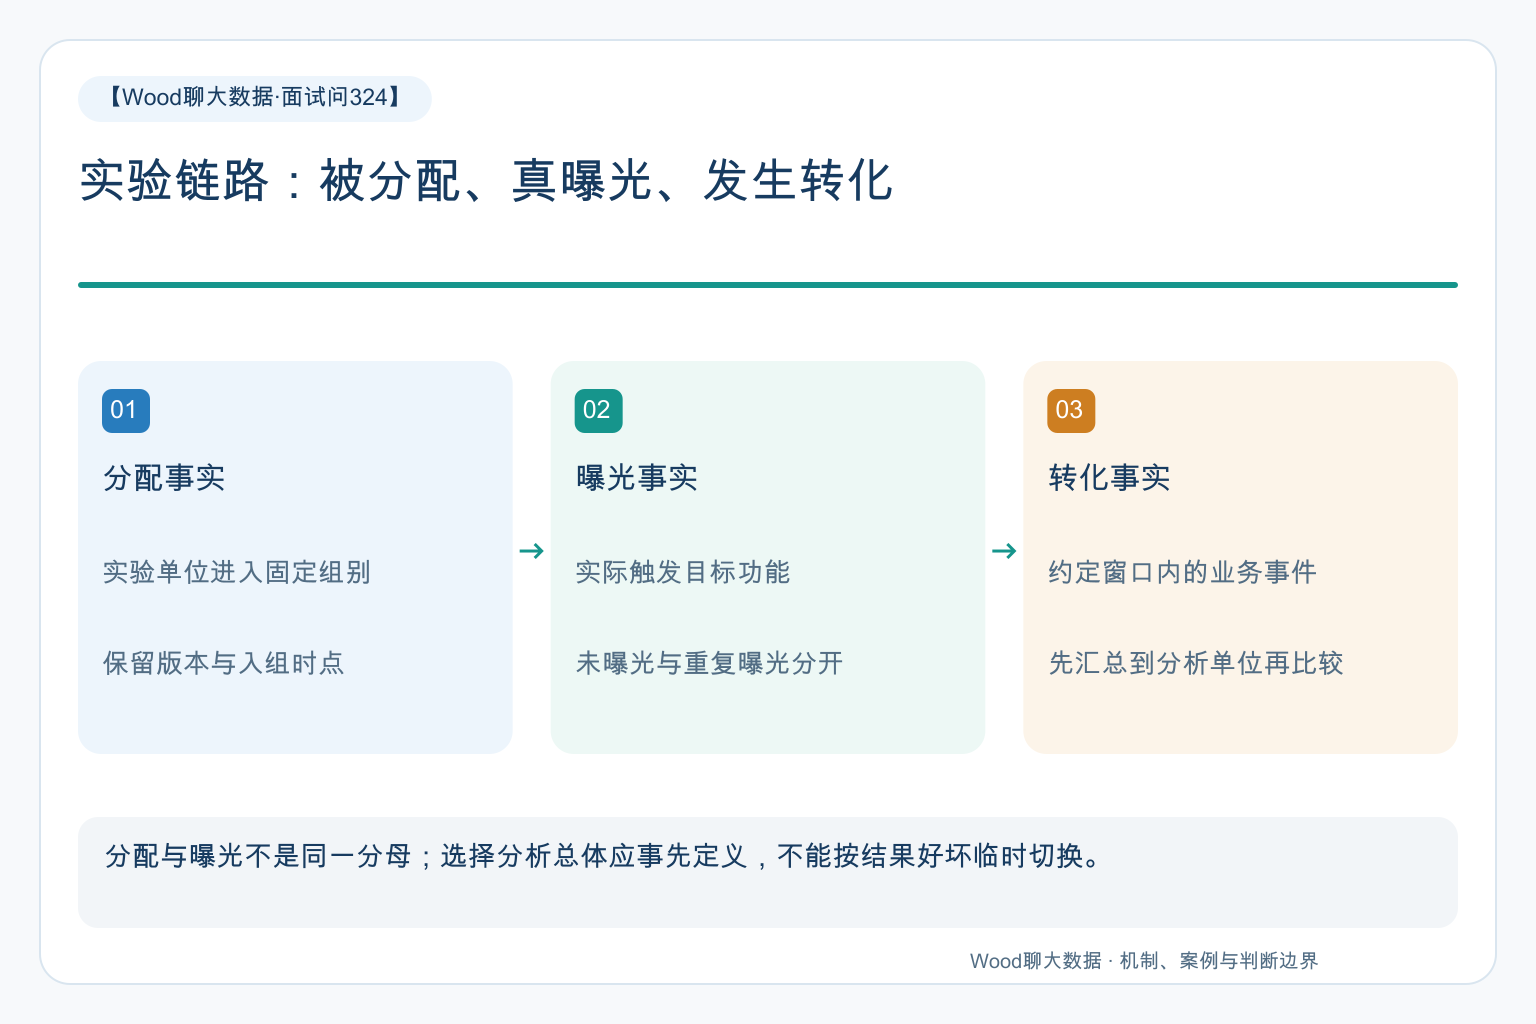
实验分配表示某个单位被分到哪个版本,曝光表示它实际触发或看到相关体验。一个用户可以被分配却未曝光,也可以在一天内曝光多次。
如果只有当前用户标签,历史分配变化可能被覆盖;如果只有曝光事件,又无法完整还原分配总体。因此两类数据应该分别保留,再通过明确身份关联。
曝光也需要具体定义:服务端返回实验版本、客户端成功展示、还是用户进入有效可见区域?不同定义影响计数,必须与产品和实验负责人事先约定。
实验单位决定数据粒度
按用户随机分流,就应围绕用户构建分配和分析单位;按设备分流,则不能事后随意按账号合并,假装所有账号内设备都接受了同一种处理。
分配事实至少记录实验ID、实验版本、随机化单位、组别、生效时间与分流规则版本。同一单位在同一有效实验范围内是否允许换组,也要有明确约束。
曝光明细保留事件ID、发生时间、实验与组别证据;转化明细则保留订单或业务事件身份。三个表的自然粒度不同,不能直接一把Join后按行数统计人数。
转化必须落在约定观察窗口内
假设目标是入组后七天内是否购买,需要先确定起算点、是否要求实际曝光、转化事件类型和去重方式。用户入组之前的订单不能直接成为实验带来的转化。
窗口尚未走完的用户,也不能与已经完整观察七天的用户不加区分地比较。应定义成熟样本范围或明确采用何种分析方法,避免晚入组用户天然少一些观察时间。
多次曝光与多笔订单还会形成多对多放大。常见做法是先按实验单位整理是否曝光、是否转化、转化次数或金额,再在组别层面汇总,同时保留明细用于追溯。
分母选择不能等结果出来再决定
按分配总体分析,可以保留最初分流形成的比较框架;按实际曝光人群分析,则需要额外确认筛选曝光是否引入选择差异。
例如新版页面加载更慢,部分用户没有形成有效曝光。如果只比较成功曝光的用户,可能把受影响的人提前排除了。这里不提供一套万能统计结论,而是提醒数仓保留足够事实,让实验分析能够识别这种边界。
实验结果是否显著、是否存在干扰和如何估计效应,应由约定的分析方法处理。数据模型不能仅凭两个转化率大小,就替代完整实验判断。
一个典型场景:订单越多,实验人数也越多
比如报表把曝光明细直接关联订单明细,再按组统计COUNT(*)作为参与人数。某些高活跃用户多次曝光又多次下单,贡献了大量关联行,实验组看起来规模异常。
团队最初怀疑分流服务不均衡,但检查分配表人数比例基本正常。旧验收只检查Join字段非空和报表总金额有值,没有验证一行到底是不是一个实验单位。
修正后先分别在单位粒度汇总曝光和转化,再与固定版本的分配事实关联,统计用户数、转化用户数和金额。回归测试加入未曝光、重复曝光、跨设备、跨组和窗口未成熟样本。
数据质量检查要贴着实验设计
检查预期与实际分配比例是否异常、同一单位是否跨组、曝光组别是否与分配一致、事件时间是否落在合理范围,以及不同组是否存在系统性的日志缺失。
发现异常应先核对采集和分流链路,再决定是否可用于结论。不要为了把比例调回预期而随意删用户,那会改变分析总体。
一个好的实验数仓,不是替业务自动宣布哪组赢了,而是让每个比较都能说明:比较了谁、实际经历了什么、观察了多久,以及哪些数据仍然不可信。
资料与适用边界
机制以所链接版本为准;业务示例用于说明判断方法,不代表作者真实项目或已验证的生产性能。