数仓事实表的粒度怎么设计?
面试怎么回答
我会先明确业务过程,再用一句话声明一行代表什么,把粒度当成事实表的契约。然后选择事务事实、周期快照或累积快照,校验主键、维度和度量是否都服从这个粒度,尤其检查度量的可加性。订单级和明细级数据不能混在一张表里,否则很容易重复汇总。需要更高层查询时,可以单独建设聚合事实表,但不会破坏原子事实表的粒度。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
很多人的第一反应是:
“粒度就是一行数据代表什么,事实表越细越好。”
这句话只答对了一半。
真正需要讲清楚的是:
粒度是一张事实表的契约。先声明一行到底代表什么,再决定维度、事实和主键;任何字段都不能破坏这份契约。
第一步:先用一句话声明“一行是什么”
建事实表时,不要先把源表字段全部搬进来,而要先写一句完整的粒度声明。
例如:
一行代表一个订单中的一个商品明细或者:
一行代表一个账户在一个自然日结束时的余额快照这句话至少要回答三个问题:
- 业务过程是什么:下单、支付、退款,还是账户余额
- 识别对象是什么:订单、订单明细、用户,还是账户
- 时间范围是什么:一次事件、一天快照,还是整个流程周期
粒度一旦确定,后面的维度键和度量都必须与它一致。
第二步:区分三类常见事实表
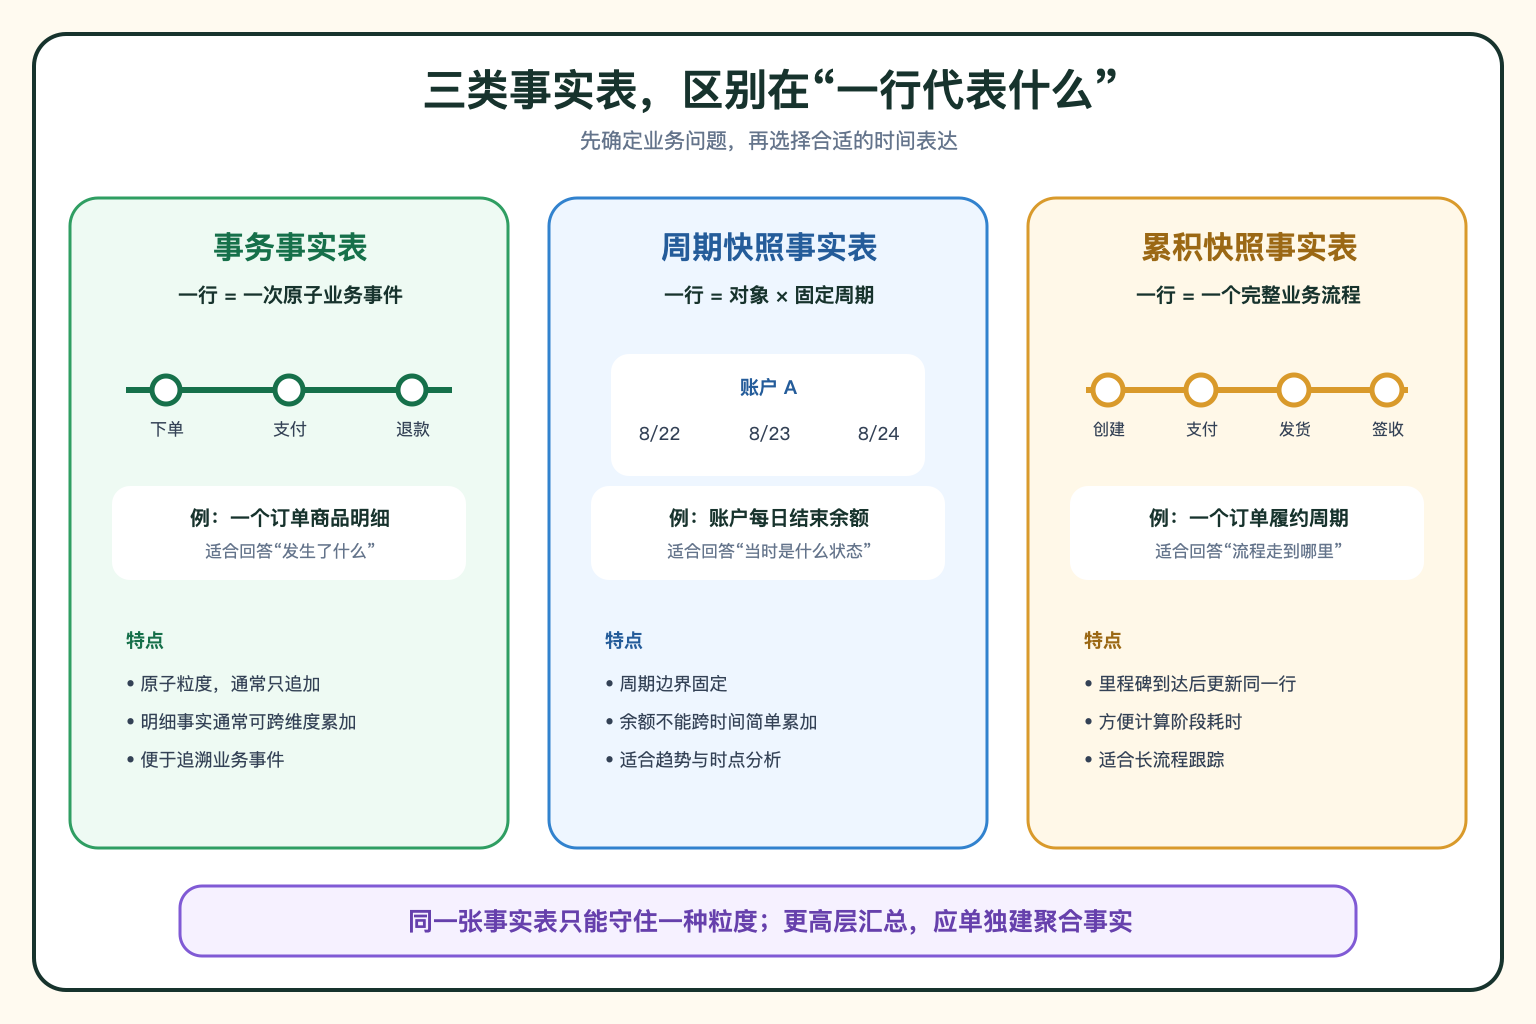
事实表不是都按同一种方式设计,常见的有三类:
1. 事务事实表
一行记录一次最原子的业务事件,例如一条订单明细、一次支付、一次点击。
它适合回答“发生了什么”,通常数据只追加,不反复更新。
2. 周期快照事实表
一行记录某个对象在固定周期的状态,例如账户每日余额、门店每月库存。
它适合回答“某个时间点是什么状态”。
3. 累积快照事实表
一行对应一个完整业务流程,随着关键节点到达不断更新,例如订单从创建、支付、发货到签收。
它适合回答“流程走到哪一步、各环节耗时多久”。
第三步:检查维度和度量是否服从粒度
粒度声明完成后,我会做三类检查。
第一,检查主键能不能唯一标识这一行。
订单明细粒度通常需要 order_id + item_id,只用 order_id 就不够。
第二,检查每个维度是否能落在这一行上。
如果事实表是一条支付事件,那么支付时间、支付渠道可以直接描述它;但“用户当前等级”是会变化的状态,需要明确取事件发生时的等级,不能含糊地关联当前值。
第三,检查度量能不能在这个粒度上安全汇总。
明细金额通常可以跨商品、订单和日期累加;库存余额只能在商品之间相加,不能跨日期直接累加;订单总金额如果复制到每条商品明细上,再做 SUM 就会重复计算。
不是把字段放进事实表就结束了,还要知道这个度量在哪些维度上可加。
第四步:不要在一张表里混合两种粒度
最常见的问题,是为了“查询方便”把订单级和订单明细级字段放到同一张事实表里。
比如一笔订单有三条商品明细,订单总金额是 300 元。如果把 order_amount=300 复制到三条明细上:
商品A:order_amount = 300
商品B:order_amount = 300
商品C:order_amount = 300
下游一旦直接求和,就会得到 900 元。
更合理的做法是:
- 明细事实表保存能够按明细累加的
item_amount - 订单级金额放在订单事实表,或者明确只在订单粒度聚合
- 如果查询确实需要高层汇总,再单独建设聚合事实表
查询方便不能以口径不可靠为代价。
一个典型场景
比如报表里 GMV 比财务口径高,排查后发现事实表是一行一条订单明细,但订单总金额被重复写到了每条明细。
这个问题表面上是聚合 SQL 写错了,根因其实是表的粒度和度量粒度不一致。
修复时不能只在当前报表里加一个 DISTINCT。更重要的是回到模型层:重新声明粒度,拆分订单事实和订单明细事实,并标清每个度量的可加性。
事实表设计得好不好,最先看的不是字段多不多,而是一行的业务含义是否始终唯一。