数仓星型模型和雪花模型怎么选?
面试怎么回答
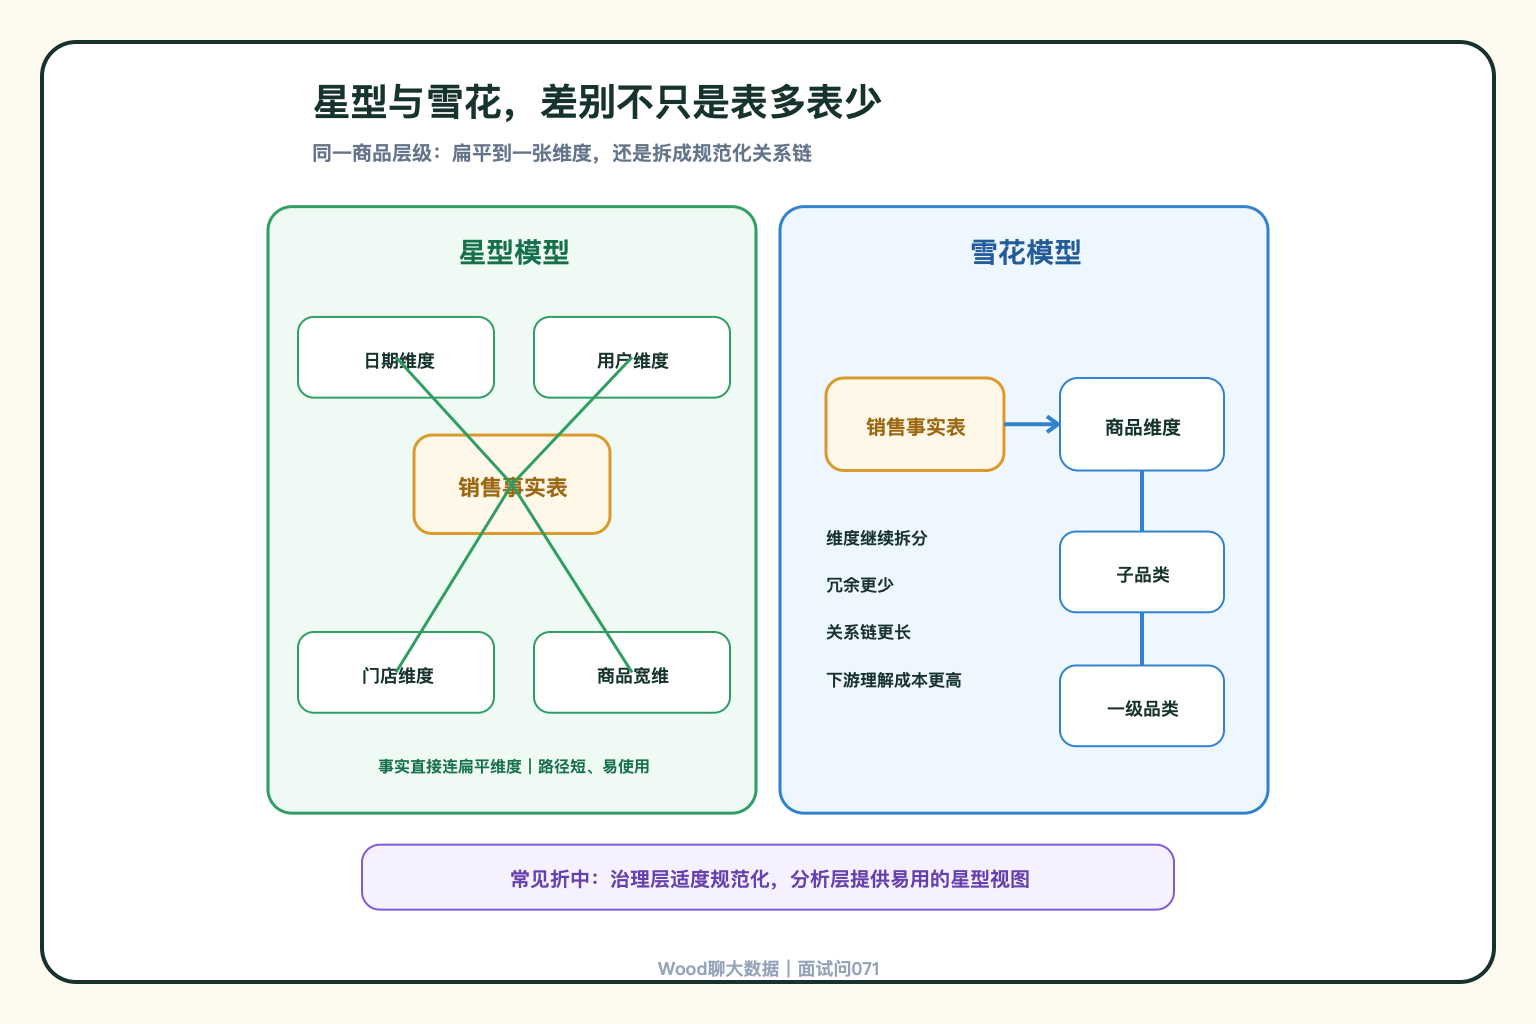
星型模型让事实表直接关联相对扁平的维度表,Join 少、查询直观,适合高频分析和语义层;雪花模型把维度层级进一步规范化,减少属性冗余、治理边界更清晰,但关系链和使用复杂度更高。实际项目中我会结合维度规模、层级复用、变更频率和下游使用方式选择,常见做法是治理层适度规范化,分析层提供更易用的星型模型。
先把这段讲顺;面试官追问时,再展开下面的原理和细节。
详细讲解
只回答“星型反规范化、雪花规范化”,还没有触及真正的设计取舍。
核心不是哪种模型更高级,而是:维度属性要集中在一张宽维表中,还是拆成多个层级清晰的规范化维表。
星型模型:事实表直接连接维度表
以销售主题为例,订单事实表直接关联日期、用户、商品、门店等维度。
商品维度中可以同时保存商品、子品类、一级品类和品牌属性。维度表存在一定冗余,但查询路径短,业务人员只需要理解“事实表 + 若干维度表”。
星型模型的优势通常是:
- Join 层级少,查询和排查更直接
- 维度属性集中,报表使用门槛低
- 层级字段可以在同一维度中直接过滤和分组
- 更适合作为面向分析和语义层的模型
代价是维度属性可能重复存储,层级属性变更时需要更新更多记录。
雪花模型:继续拆分维度层级
雪花模型会把商品维度进一步拆成商品、子品类、一级品类、品牌等表,维度之间继续关联。
它的优势是:
- 减少重复属性存储
- 层级和主数据边界更清楚
- 某些被多个维度复用的实体更容易统一维护
但查询一条商品品类指标时,需要从事实表一路 Join 多张维表。模型更复杂,关系链更长,对自助分析和下游使用者不一定友好。
实际项目中怎么选?
面向高频分析,优先保证易用性
如果大量查询都需要商品、品类和品牌一起分析,把这些属性放在同一商品维度中,通常比每次跨多层 Join 更清楚。
层级实体独立治理时,可以适度雪花化
如果品牌、组织、地理区域本身有独立主数据、权限和维护周期,完全塞进一个维度可能造成边界混乱。这时可以保留独立实体,再通过统一视图或数据服务降低下游复杂度。
不要只看存储冗余
在现代分析系统中,省下少量维度存储不一定比查询易用性更重要。真正要比较的是:
- 查询需要经过多少层关系
- 维度规模和属性重复程度
- 层级是否被多个主题复用
- 属性变化和历史追踪如何处理
- 下游是工程师写 SQL,还是业务自助分析
一个典型反例
为了追求第三范式,把商品的每一级分类、品牌、供应商和属性值全部拆成独立表。
源系统结构看起来很规范,但报表每次都要写很长的 Join,开发人员还要理解多张表的生效时间和删除状态。一旦漏掉一个条件,分类结果就可能重复或缺失。
更合理的做法,往往是在主数据层保留规范化关系,在面向分析的维度模型中提供扁平、稳定、带历史语义的商品维度。
数仓不需要在星型和雪花之间二选一到底,而是要在治理边界与分析易用性之间找到合适层次。